


스페이스X AI, Grok 4.7 공개: Grok 4.6과 동일한 가격의 코딩 및 지식 작업용 플래그십 세대



AI 팟캐스트


스페이스X AI는 9월 21일 코딩과 지식 작업 성능을 높인 Grok 4.7을 출시했다. 가격은 기존 Grok 4.6과 동일하게 유지되며, 출력 속도를 두 배 높인 패스트 버전도 함께 제공된다. 벤치마크 결과, CursorBench 4.0에서 46.3%를 기록하고 터미널 작업과 법률 부문 등에서 개선을 보였으나, 일부 벤치마크에서는 타사 모델이 우위를 점해 경쟁 상태를 나타낸다. 보안 측면에서는 강화된 안전 스택을 적용해 탈옥 방어력을 높였으며, 생체 보안 벤치마크에서 최고 점수를 기록한 것으로 전해진다.

TradingKey - 스페이스X AI(구 xAI, SPXC의 AI 부문)는 9월 21일 Grok 4.7을 출시하며, 코딩 및 지식 작업 분야에서 현재까지 자사 모델 중 가장 성능이 뛰어난 모델 세대로 공식 규정했습니다. 이용 가격은 기존 Grok 4.6과 동일하게 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 6달러로 유지됩니다. 장시간 코딩 작업을 전문적으로 평가하는 CursorBench 4.0에서 Grok 4.7은 Grok 4.6보다 5.9%포인트 높은 46.3%를 기록했으며, 공식 발표에 따르면 해당 가격대 벤치마크 내에서 최상의 가성비를 달성한 것으로 나타났습니다.
지난 2년간 플래그십 모델의 성능 향상은 일반적으로 토큰 단가 인상으로 이어졌습니다. 세대 업그레이드와 가격 인상이 이뤄진 후 업계가 추론 비용을 점진적으로 수용하기를 기다리는 방식이었습니다. 이에 반해 Grok 4.7은 다른 길을 택했습니다. 성능을 끌어올리면서도 가격과 추론 속도는 Grok 4.6 수준을 유지했으며, 출력 속도를 두 배 높인 패스트(fast) 버전도 추가로 제공합니다.
공식 공개된 세부 사항은 네 가지 항목에 집중되어 있습니다. 기본 모델 및 강화학습 훈련 방식의 변화, 7개 벤치마크에 대한 수평·수직적 비교, 장시간 작업 환경에서의 비용 구조, 그리고 전면 재설계된 안전 가드레일 스택입니다. 또한 발표와 동시에 Cursor, Grok Build, Grok API는 물론 제3자 코딩 프레임워크 및 모델 라우팅 플랫폼에서 해당 모델을 즉시 이용할 수 있습니다.
Grok 4.7의 핵심 가치 제안은 장시간 코딩 작업, 전문 문서 작성, 안전 가드레일이라는 세 가지 핵심 기능에 맞춰져 있습니다. 이 세 기능 모두 이전 세대와 동일한 가격과 속도를 제공하는 동일 요금 체계를 공유하는 한편, 지연 시간에 민감한 사용 환경은 패스트 버전을 통해 대응합니다.
공식 벤치마크 결과에 따르면 이번 세대 모델의 성능 개선은 꾸준히 지속되고 있습니다. CursorBench 4.0은 5.9%포인트 향상되었고, Terminal-Bench 4.0은 두 배 가까이 상승했으며, AA Briefcase는 111 포인트를 얻었습니다. 또한 생물안보 벤치마크에서는 자사 역대 최고 점수를 기록했습니다. 다만 법률 벤치마크에서의 절대 수준이 19.6%에 그친 점과 4개 벤치마크에서 Fable 5.1이 우위를 점한 점은, 이번 경쟁이 일방적인 대체라기보다는 양측이 득실을 주고받는 경쟁 상태임을 보여줍니다.
가격 및 속도 변동 없음
Grok 4.7은 동일한 추론 속도를 유지하면서 Grok 4.6과 마찬가지로 입력 토큰 100만 개당 2달러, 출력 토큰 100만 개당 6달러에서 시작한다. 또한 두 배의 가격으로 표준 버전 대비 두 배의 출력 속도를 제공하는 공식 패스트(Fast) 버전도 이용할 수 있다.
이러한 가격 책정은 동급 모델 가운데 낮은 편에 속한다. 이에 비해 GPT-5.6 Sol은 최고 티어 기준 입력 4달러, 출력 20달러인 반면, Fable 5.1은 최고 티어 기준 입력 10달러, 출력 50달러이다. 출력 단가만 비교하면 Grok 4.7은 전자의 약 3분의 1, 후자의 약 8분의 1 수준이다.
가격을 동일하게 유지함에 따른 실질적 효과는 전환 비용을 감당 가능한 수준으로 관리할 수 있다는 점이다. 이미 Grok 4.6을 사용 중인 팀은 API나 호출 방식을 변경할 필요 없이 Cursor나 Grok Build에서 모델을 직접 교체하고 기존 작업 수트로 비교 테스트를 실행할 수 있다.
모델 개선
Grok 4.7의 강화 학습 단계는 훈련 시간도 더 길어졌으며, 훈련 과제의 전반적인 난이도가 높아지고 완료하는 데 수시간이 걸리는 문제에 가중치가 더 많이 두어졌다. 공식적인 직접적 결과로 이 모델은 자체 출력을 더 잘 검증하고 긴 문맥을 관리할 수 있게 되었다.
훈련 목표에서도 또 다른 변화가 나타났다. Grok 4.7은 Grok Bot 하네스를 자체적으로 이해하도록 훈련되어 대화형 작업과 일반 지식 업무에서 더 나은 성능을 제공한다. 스페이스X AI(SpaceXAI)는 8월 11일 Grok Bot을 출시하며, 이를 각각 자체 컴퓨터를 갖추고 도구 및 애플리케이션 내에서 작업할 수 있는 지속 실행형 에이전트 집합이라고 설명했다.
문서 및 프레젠테이션 생성 능력도 별도로 강조되었다. 공식 발표에 따르면 Grok 4.7은 두 출력 범주 모두에서 Grok 4.6 대비 뚜렷한 향상을 보이며 다른 프론티어 모델들과 대등한 성능을 발휘한다.
7개 벤치마크 성적표
Grok 4.7은 문서 및 프레젠테이션 작성에서 더 우수한 성능을 발휘한다. GDPval 및 AA Briefcase 테스트에서 AI는 변호사, 간호사, 금융 분석가와 같은 전문가의 업무를 수행해야 한다. Grok 4.7은 두 벤치마크 테스트 모두에서 Grok 4.6을 앞질렀으며 다른 프론티어 모델들과 대등한 성능을 달성했다.
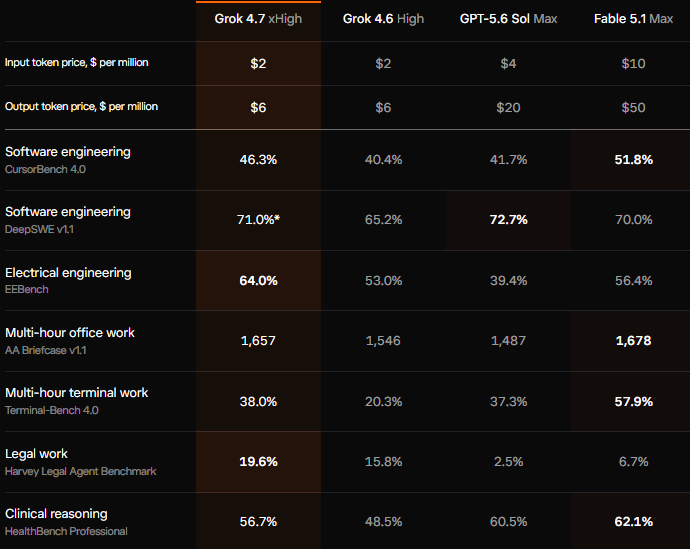
[코딩, 터미널 작업, 전기공학, 법률, 임상 추론 및 사무 업무를 다룬 공식 비교표. 출처: x.ai]
법률과 터미널 작업 부문에서 가장 큰 개선을 보였다. 하비 리걸 에이전트 벤치마크(Harvey Legal Agent Benchmark)에서 Grok 4.7은 19.6%를 기록하며 해당 그룹에서 가장 높은 점수를 달성한 반면, GPT-5.6 Sol은 2.5%에 그쳤다. 터미널벤치 4.0(Terminal-Bench 4.0)에서는 Grok 4.7이 Grok 4.6의 20.3%에서 38.0%로 치솟으며 거의 두 배로 증가했다. 임상 추론은 8.2퍼센트포인트 향상되었고, 사무 업무 점수는 111점 증가했다.
장기 작업 하에서의 비용 곡선
CursorBench 4.0의 공식 페이지는 과제당 평균 비용, 평균 출력 토큰 수, 평균 단계 수 등 세 가지 차트를 나란히 제시하며, 세로축은 동일한 점수 기준으로 표준화되어 있다. 차트의 기준점은 Sonnet 5(높음 기본 프리셋)에 표시되어 있으며, 이는 점수 30.8%, 과제당 3.48달러, 약 61,000개의 출력 토큰, 85단계를 나타내며 비용 효율성 비교의 기준선 역할을 한다.
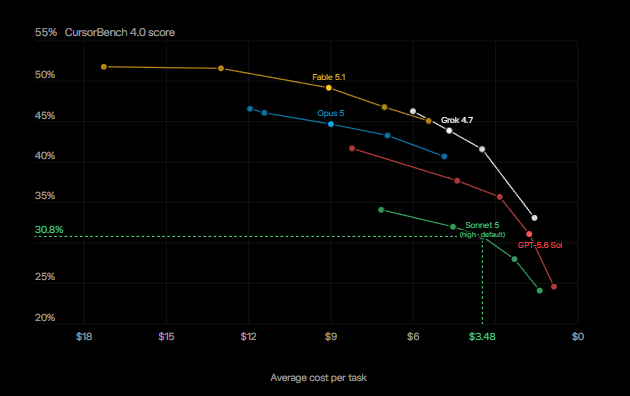
[출처: X.ai]
비용 곡선을 살펴보면 Fable 5.1은 과제당 18달러에 가까운 비용으로 가장 높은 점수를 기록하고 있는 반면, GPT-5.6 Sol은 저비용 측에 위치하며 비용이 줄어들수록 점수가 더 가파르게 하락한다. Grok 4.7은 두 모델 사이에 위치하며, 공식 주장에 따르면 이 벤치마크에서 가성비 프론티어에 해당한다. 출력 토큰 및 단계 수 차트의 형태는 비용 차트와 일치하는데, 이는 비용 차이가 단가 자체보다는 과제를 완료하는 데 필요한 추론 길이에 주로 기인함을 나타낸다.
6명으로 구성된 백엔드 팀이 40만 줄 규모의 서비스를 기존 프레임워크에서 새 프레임워크로 마이그레이션하는 상황을 가정해 보자. 이러한 종류의 과제를 단일 단계 커밋으로 나누는 것은 무의미하며, 모델은 수시간 동안 연속으로 작업하면서 진행 과정에서 이전 단계의 결과를 스스로 점검해야 한다. 이는 CursorBench 4.0과 Terminal-Bench 4.0이 측정하고자 하는 정확한 시나리오다. 과제당 비용이 10달러 이상에서 수 달러 수준으로 떨어져야만 팀이 주말에 일괄 처리하기 위해 기다리지 않고 일상적인 일정에 반영할 가능성이 높아진다.
보안 및 사이버 보안
Grok 4.7은 완전히 새로워진 안전 스택을 적용했다. 공식적으로 이 모델은 거부율과 탈옥 방어력 모두에서 현재까지 테스트된 자사 모델 중 가장 강력한 모델로 설명된다.
사이버 보안 및 생체 보안과 같은 이중 용도 분야에서 공식 데이터는 합법적인 작업에 대한 유용성을 유지하면서 위험한 요청은 거부하는 두 가지 측면을 모두 보여준다. 생체 보안 분야에서 Grok 4.7은 LatchBio 생체 보안 벤치마크에서 62.4%를 기록하며 해당 벤치마크 최고 점수를 달성했다. 사이버 보안 분야에서는 자체 HackerBench v0.3 벤치마크를 통해 이 모델이 합법적인 보안 연구를 차단하는 경우는 거의 없었던 반면, 고위험 이중 용도 프롬프트는 3.3%만 허용한 것으로 나타났다.
SpaceXAI는 또한 방어적 연구를 위해 엄선된 사이버 보안 파트너를 대상으로 Grok 4.7의 레드팀(red-teaming) 기능에 대한 초청 전용 접근 권한을 제공하기 시작했다고 밝혔다.
이 콘텐츠는 AI를 활용하여 번역되었으며, 명확성을 확보할 수 있도록 검토 과정을 거쳤습니다. 정보 제공 용도로만 제공됩니다.
추천 기사









코멘트 (0)
$ 버튼을 클릭하고, 종목 코드를 입력한 후 주식, ETF 또는 기타 티커를 연결합니다.