


SpaceXAI发布Grok 4.7:面向编程与知识工作的一代旗舰,价格与Grok 4.6持平



AI播客


SpaceXAI发布AI模型Grok 4.7,定位为编程与知识工作能力最强的一代。其输入输出定价维持前代水平,并提供双倍输出速度的fast版本,处于同类模型低位。该模型在长任务编程、专业文档产出及安全防护能力上显著提升,强化学习训练时间更长,且采用全新安全防护栈,兼顾合法任务可用性与高风险请求拒答。

Tradingkey - SpaceXAI(SPXC旗下AI部门,原xAI)于9月21日发布Grok 4.7,官方将其定位为目前面向编程与知识工作能力最强的一代模型,定价与Grok 4.6保持一致:输入2美元/百万token,输出6美元/百万token。在专门考察长时间编程任务的CursorBench 4.0上,Grok 4.7取得46.3%,比Grok 4.6高出5.9个百分点,官方称其在该基准上处于同价位段的性价比前沿。
过去两年,旗舰模型的能力提升通常以更贵的token单价收尾:换代、涨价,然后等行业慢慢消化推理成本。Grok 4.7走的是另一条路,能力上探的同时,价格与推理速度都停在Grok 4.6的水平线上,并额外提供一个输出速度翻倍的fast版本。
官方披露的细节集中在四个方面:基座模型与强化学习训练的变化、七项基准的横竖对比、长任务下的成本结构,以及一套完全重写的安全防护栈。此外,模型即日起在Cursor、Grok Build、Grok API以及第三方编程框架与模型路由平台上同步开放。
Grok 4.7的核心主张落在长任务编程、专业文档产出与安全防护三项能力上。三者共用同一条价格线,与前代同价、同速,并用fast版本覆盖对延迟敏感的场景。
官方基准显示,这一代模型的进步是连续的:CursorBench 4.0提升5.9个百分点,Terminal-Bench 4.0接近翻倍,AA Briefcase增加111分,生物安全基准取得公司最高分。同时,法律基准19.6%的绝对水平、以及Fable 5.1在四项基准上的领先,说明这仍是互有胜负的一轮竞争,而不是单方面的替代。
定价与速度维持不变
Grok 4.7的起步价为每百万输入token 2美元、每百万输出token 6美元,与Grok 4.6完全一致,推理速度也维持在同一水平。官方另外提供一个fast版本,输出速度为标准版的两倍,价格同步翻倍。
这一定价在同类模型中处于低位。作为对照,GPT-5.6 Sol在max档位为输入4美元、输出20美元;Fable 5.1在max档位为输入10美元、输出50美元。仅比较输出单价,Grok 4.7约为前者的三分之一,约为后者的八分之一。
价格不动带来的现实影响是迁移成本可控。已经在使用Grok 4.6的团队,可以直接在Cursor或Grok Build中切换模型,用现成的任务集跑一次对比,接口与调用方式都不需要改动。
模型改进
Grok 4.7强化学习阶段的训练时间也更长,训练任务的难度组合整体上移,权重向需要数小时才能完成的问题倾斜。官方给出的直接结果是:模型更能核对自己的产出,也更能管理长上下文。
另一处改动发生在训练目标里。Grok 4.7被训练成原生理解Grok Bot的执行框架(harness),因此在对话类任务与通用知识工作上的表现更好。SpaceXAI于8月11日推出Grok Bot,将其描述为一组常驻运行、各自拥有电脑、可以在工具与应用内部工作的智能体。
文档与演示文稿的生成能力被单独提出来。官方称Grok 4.7在这两类产出上比Grok 4.6有明显改进,与其它前沿模型表现相当。
七项基准的成绩单
Grok 4.7在创建文档和演示文稿方面表现更佳。在 GDPval 和AA Briefcase测试中,人工智能需要完成律师、护士和金融分析师等专业人士的工作。Grok 4.7在这两项基准测试中均优于Grok 4.6,并且与其他前沿模型性能相当。
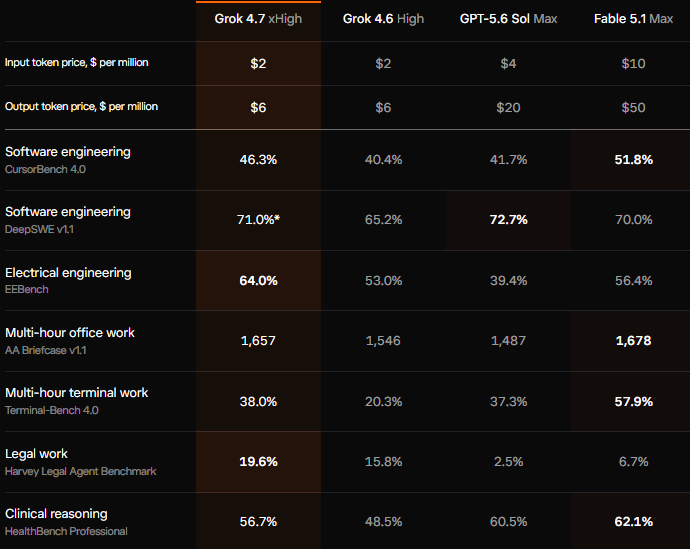
【官方对比表覆盖编程、终端操作、电气工程、法律、临床推理与办公任务,来源:x.ai】
法律与终端操作是提升幅度最大的两类。Harvey Legal Agent Benchmark上,Grok 4.7的19.6%是本组最高,而GPT-5.6 Sol只有2.5%;Terminal-Bench 4.0上,Grok 4.7从Grok 4.6的20.3%提升到38.0%,接近翻倍。临床推理提升8.2个百分点,办公任务分数增加111分。
长任务下的成本曲线
CursorBench 4.0的官方页面把三张图并排呈现:每任务平均成本、平均输出token、平均步数,纵轴统一为同一套得分。图中的参考点被标在Sonnet 5(high默认档)上:得分30.8%、每任务3.48美元、约6.1万输出token、85步,作为成本效率的比较基线。
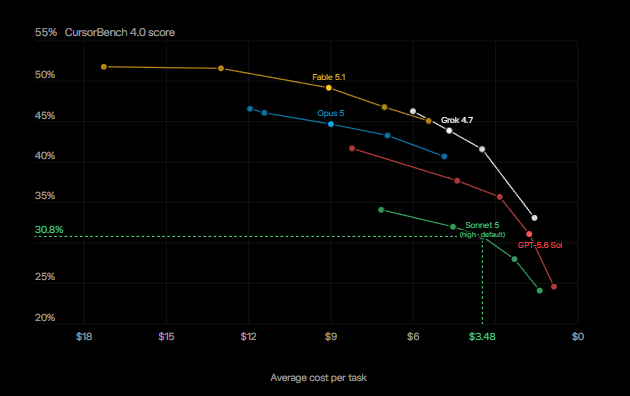
【来源:X.ai】
从成本曲线看,Fable 5.1的得分最高,代价是每任务成本接近18美元;GPT-5.6 Sol位于低成本一侧,得分随成本下降滑落得更快。Grok 4.7落在两者之间,官方称其在该基准上处于性价比前沿。输出token与步数两张图的形状与成本图一致,说明成本差异主要来自完成任务所需的推理长度,而不是单价本身。
设想一个6人的后端团队要把一套40万行的服务从旧框架迁到新框架。这类任务拆成单步提交没有意义,模型必须连续工作数小时,并在中途自己检查前一步的结果,这正是CursorBench 4.0与Terminal-Bench 4.0试图衡量的场景。当一个任务的成本从十几美元降到几美元,团队才可能把它放进日常排期,而不是等到周末集中处理。
安全与网络安全
Grok 4.7使用了一套全新的安全防护栈。官方称它是公司测试过的、在拒答与抗越狱两项上表现最强的模型。
在网络安全与生物等双用途领域,官方数据同时覆盖两面:对合法任务保持可用,对危险请求保持拒答。生物安全方向,Grok 4.7在LatchBio的生物安全基准上取得62.4%,是该基准上的最高分。网络安全方向,自建基准HackerBench v0.3显示模型只放行了3.3%的高风险双用途提示,同时很少拦截合法的安全研究工作。
SpaceXAI还表示,已开始向部分网络安全合作伙伴提供Grok 4.7红队能力的邀请制访问权限,用于防御性研究。










