Anthropic發布Claude Opus 5.5:成本降40%、速度更快、安全升級,長任務能力更強



AI 播客


美東時間 9 月 22 日,Anthropic 推出 Claude Opus 5.5,主打複雜任務處理能力提升、運作成本降低與更高安全性。其任務成本下降 40%,輸出速度提升逾 30%,輸入與快取讀取價格同步下調。該模型在大型程式碼遷移、商業資料整理及研究報告撰寫等長任務表現顯著優化,並強化資安與生物領域的防護機制。

TradingKey - 美東時間 9 月 22 日,Anthropic 宣布推出 Claude Opus 5.5,主打三件事:處理複雜任務更強,運作成本更低,使用過程更安全。與 Opus 5 相比,它的任務成本下降 40%,輸出速度提升 30% 以上;輸入、輸出與快取讀取價格也同步下調。
這次升級最值得關注的,或許不是某個單項測試第一,而是它開始更像一個能長時間協作的工作夥伴。它可以處理大規模程式碼遷移、整理商業資料、製作分析報告,也能把答案寫得更直接、更容易檢查。
複雜程式設計更省時間
Opus 5.5 最突出的能力,集中在那些規模大、步驟多、需要持續檢查的程式任務上。在一項測試中,Opus 5.5 審查並修復了一個 20 萬行程式碼庫,耗時不到 3 小時。Opus 5 則用了 20 多個小時,並消耗了約 2.5 倍的 tokens。對企業來說,這意味著 AI 的價值不只在於「能不能寫程式碼」,還在於能否少走彎路、少花時間。
【來源:Anthropic】
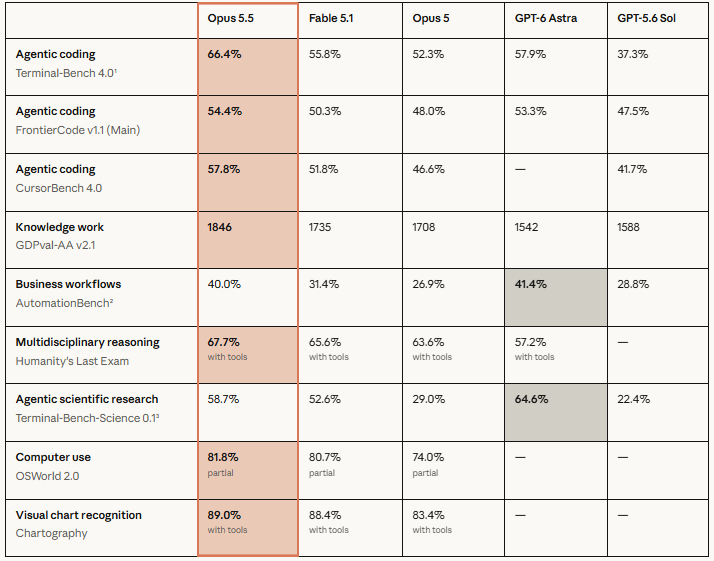
測試資料也顯示,Opus 5.5 在 Terminal-Bench 4.0 上的成績為 66.4%,在 FrontierCode v1.1 上為 54.4%,在 CursorBench 4.0 上為 57.8%。這些數字不能代表所有真實工作,但能說明它對長任務與多步驟任務更有信心。
辦公和研究能力也有提升
Opus 5.5 的應用場景不只適用於程式設計師。Anthropic 的測試涵蓋商業流程、知識工作、科學研究、電腦操作與圖表辨識。
在 GDPval-AA v2.1 知識工作測試中,Opus 5.5 獲得 1846 分,高於 Fable 5.1 的 1735 分與 Opus 5 的 1708 分。在電腦操作測試中,其成績為 81.8%;在圖表辨識測試中,則達到 89%。
研究任務中的一個細節很有意思。測試人員要求多個模型根據難以找到的財報資訊撰寫報告,並逐項核對數字與引述。Opus 5.5 在不同設定下有 16 次通過品質標準,而其他兩個模型則一次都沒有通過。這說明它在整理資料時更重視證據,雖然仍無法取代人工核對。
例如,投資機構 Walleye Capital 讓它分析一項虛構的企業合併案。它不僅完成了財務模型,還發現了測試說明中的錯誤,並主動修正。對一般使用者來說,這種能力可以轉化為更清晰的市場分析、預算整理與簡報資料。
價格下降是關鍵變化
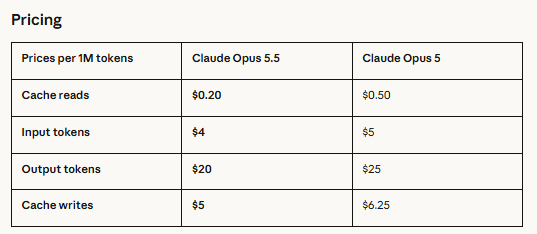
Opus 5.5 的價格比 Opus 5 更低。每百萬 token 的輸入價格從 5 美元降至 4 美元,輸出價格從 25 美元降至 20 美元,快取讀取則從 0.50 美元降至 0.20 美元。
【來源:Anthropic】
快取讀取對長時間程式開發和自動化任務尤為重要,因為許多工作會反覆使用已經處理過的內容。價格下降後,團隊可以更放心地讓模型多做幾輪檢查,而不是為了省錢過早停止。
Claude Code 與 Claude Platform 還提供快速模式,速度最高可達一般模式的 2.5 倍。快速模式的輸入價格為每百萬 token 8 美元,輸出價格為 40 美元,適合對回應速度要求更高的情境。
安全能力更受重視
Anthropic 表示,Opus 5.5 在其自動行為稽核中取得了目前 Claude 模型的最佳成績。測試涵蓋近 2000 種模擬情境,重點觀察模型是否會逾越限制、採取難以撤回的行動,或受到提示注入影響。
在一次測試中,Opus 5.5 試圖繞過邊界的次數比 Opus 5 少約 85%,且相關行為都屬於低嚴重程度,並主動回報了問題。不過,Anthropic 也承認,安全測試不可能提前發現所有真實世界中的風險。
因此,Opus 5.5 在資安與生物領域設定了更嚴格的防護。一般軟體開發中的除錯與修復仍可使用,但大量資安任務會被轉交給其他模型。需要進行生物研究的機構,則要透過審核專案申請相應權限。
本內容經由 AI 翻譯並經人工審閱,僅供參考與一般資訊用途,不構成投資建議。