Anthropic发布Claude Opus 5.5:成本降40%、速度更快、安全升级,长任务能力更强



AI播客


美东时间9月22日,Anthropic发布Claude Opus 5.5,主打复杂任务处理、更低运行成本与更高安全性。相比前代,其任务成本下降40%,输出速度提升超30%,并全面下调各项API价格。该模型在长代码库修复、商业知识工作及图表识别等长任务测试中表现优异,具备更强的逻辑校验与数据证据意识。同时,其自动化行为审计安全性显著提升,但在网络安全与生物领域实施了更严格的权限审核。

TradingKey - 美东时间9月22日,Anthropic宣布推出Claude Opus 5.5,其主打三件事:处理复杂任务更强,运行成本更低,使用过程更安全。与Opus 5相比,它的任务成本下降40%,输出速度提升30%以上;输入、输出和缓存读取价格也同步下调。
这次升级最值得关注的,或许不是某个单项测试第一,而是它开始更像一个能长时间协作的工作伙伴。它可以处理大规模代码迁移、整理商业资料、制作分析报告,也能把答案写得更直接、更容易检查。
复杂编程更省时间
Opus 5.5最突出的能力,集中在那些规模大、步骤多、需要持续检查的编程任务上。在一项测试中,Opus 5.5审查并修复了一个20万行代码库,用时不到3小时。Opus 5则用了20多个小时,并消耗了约2.5倍的 tokens。对企业来说,这意味着AI的价值不只在于“能不能写代码”,还在于能否少走弯路、少花时间。
【来源:Anthropic】
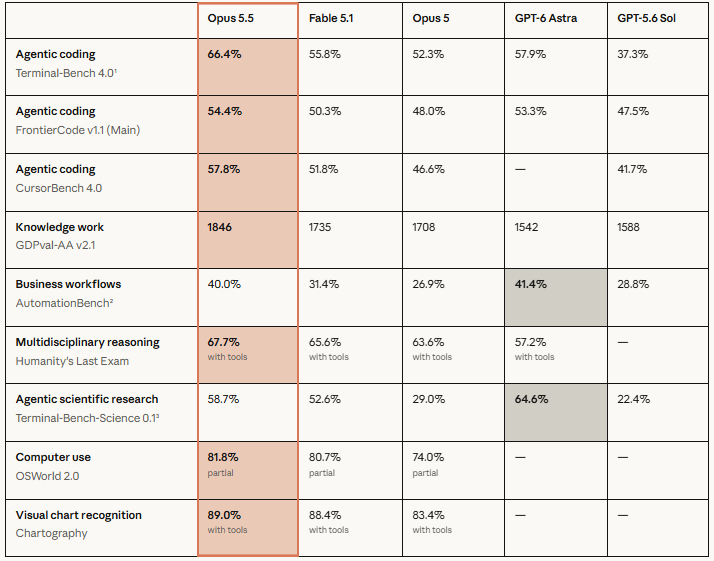
测试数据也显示,Opus 5.5在Terminal-Bench 4.0上的成绩为66.4%,在FrontierCode v1.1上为54.4%,在CursorBench 4.0上为57.8%。这些数字不能代表所有真实工作,但能说明它对长任务和多步骤任务更有信心。
办公和研究能力也有提升
Opus 5.5的使用场景不只在程序员身上。Anthropic的测试包括商业流程、知识工作、科学研究、电脑操作和图表识别。
在GDPval-AA v2.1知识工作测试中,Opus 5.5得到1846分,高于Fable 5.1的1735分和Opus 5的1708分。在电脑操作测试中,它的成绩为81.8%;在图表识别测试中,它达到89%。
研究任务中的一个细节很有意思。测试人员要求多个模型根据难以找到的财报信息写报告,并逐项核对数字和引语。Opus 5.5在不同设置下有16次通过质量标准,而其他两个模型一次都没有通过。这说明它在整理资料时更重视证据,虽然仍然不能替代人工核对。
例如,投资机构Walleye Capital让它分析一项虚构的企业合并。它不仅完成了财务模型,还发现了测试说明中的错误,并主动修正。对普通用户来说,这种能力可以转化为更清晰的市场分析、预算整理和汇报材料。
价格下降是关键变化
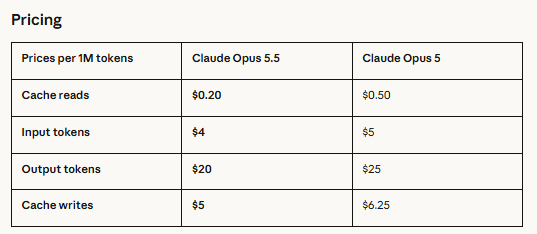
Opus 5.5的价格比Opus 5更低。每百万tokens的输入价格从5美元降至4美元,输出价格从25美元降至20美元,缓存读取则从0.50美元降至0.20美元。
【来源:Anthropic】
缓存读取对长时间编程和自动化任务尤其重要,因为很多工作会反复使用已经处理过的内容。价格下降后,团队可以更放心地让模型多做几轮检查,而不是为了省钱过早停止。
Claude Code和Claude Platform还提供快速模式,速度最高可达普通模式的2.5倍。快速模式的输入价格为每百万 tokens 8美元,输出价格为40美元,适合对响应速度要求更高的场景。
安全能力更受重视
Anthropic表示,Opus 5.5在其自动行为审计中取得了目前Claude模型的最好成绩。测试覆盖近2000种模拟情景,重点观察模型是否会越过限制、采取难以撤回的行动,或受到提示注入影响。
在一次测试中,Opus 5.5试图绕过边界的次数比Opus 5少约85%,且相关行为都属于低严重程度,并主动报告了问题。不过,Anthropic也承认,安全测试不可能提前发现所有真实世界中的风险。
因此,Opus 5.5在网络安全和生物领域设置了更严格的保护。普通软件开发中的查错和修复仍可使用,但大量网络安全任务会被转交给其他模型。需要开展生物研究的机构,则要通过审核项目申请相应权限。