AWS 組網靠「買」:誰是 Trn3 背後的賣水人?


上篇(見鏈接)海豚君拆解了 AWS 的兩步 “省事棋”:Scale-Up 協議 NeuronLink 實爲套殼 PCIe,圖的是快速交付;Trn2 全銅 “拼” 出的 3D torus 止步 64 卡,AWS 由此從谷歌的直連派轉向英偉達的交換派。
那麼,主力機型 Trn3 如何用標品 “買” 出交換式組網?和 GB300 差在哪?AWS 鏈的錢又流向了誰?下篇繼續拆解。
以下是正文:
一、Trn3:「買」出來的交換式
1、與 GB300 類似的機架形態
以主力機型 Trn3 NL72x2 爲例,該方案基本照搬了英偉達 NVL72 的交換式架構,包括 72 卡一櫃,櫃內托盤 “三明治式” 的擺放等(計算托盤 - 交換托盤 - 計算托盤)。
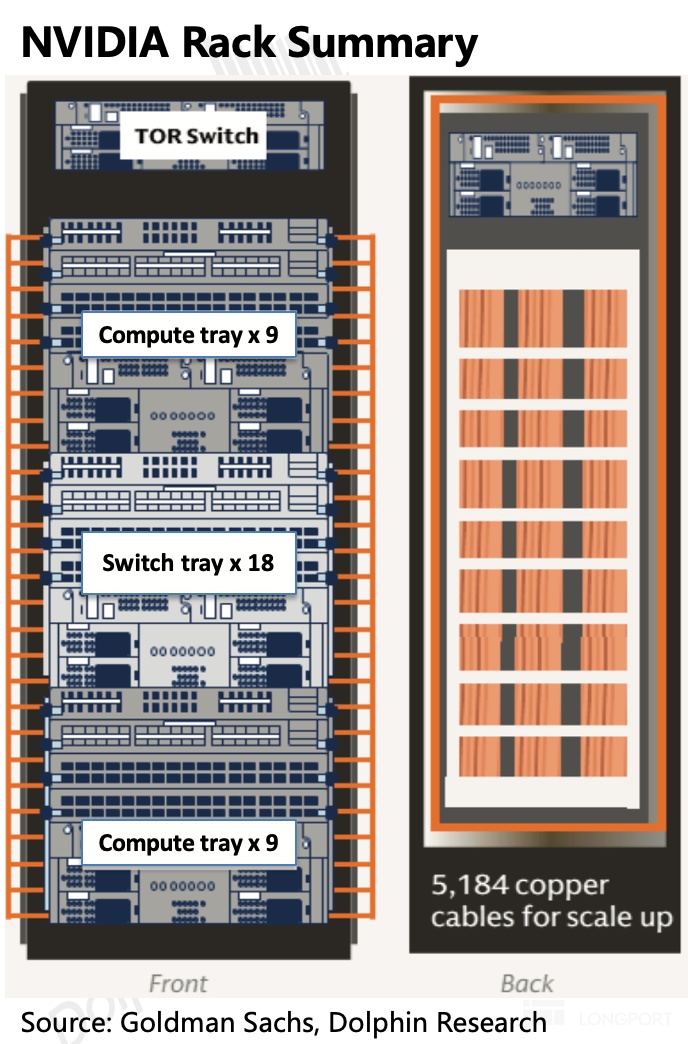
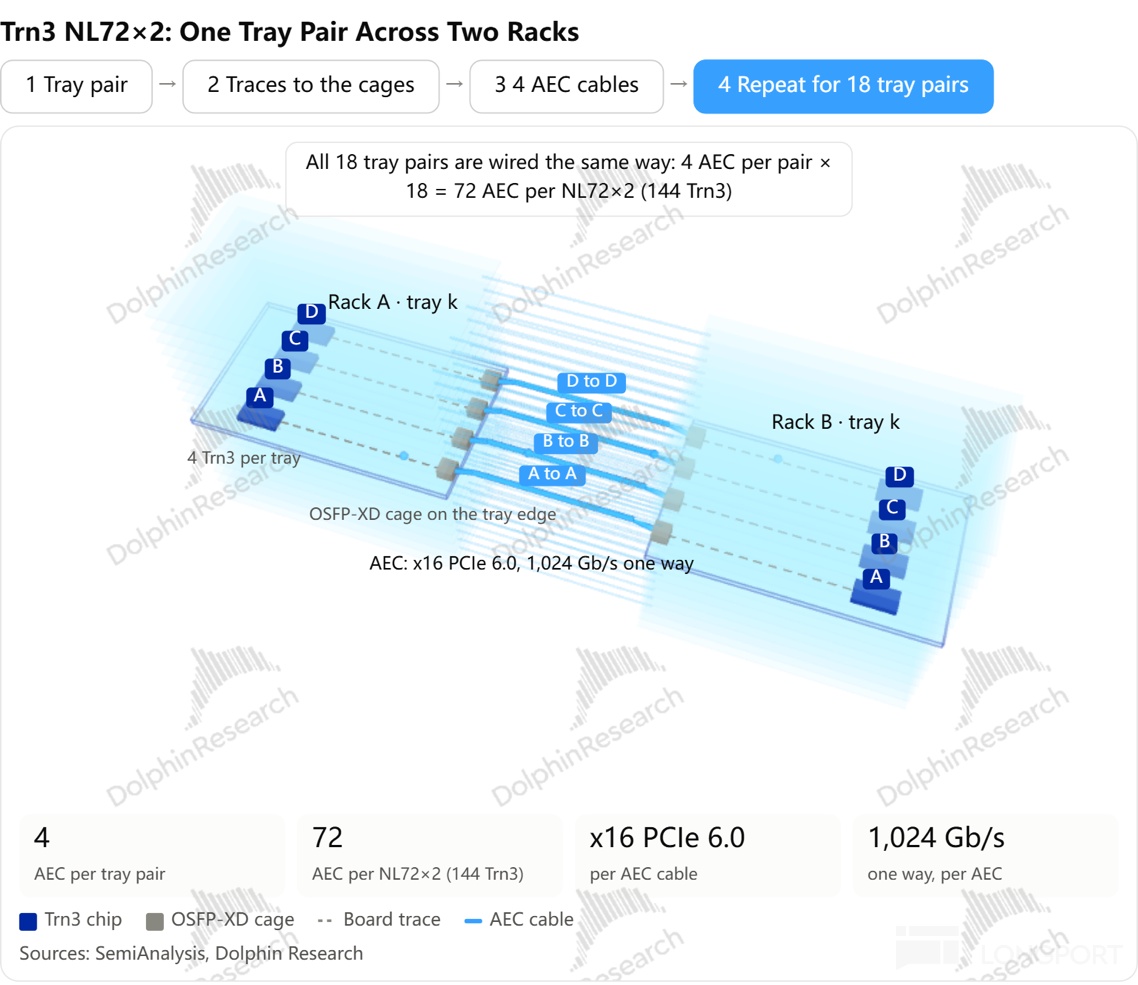
而之所以被稱爲 Trn3 NL72x2,是因爲兩個 72 卡的機架作爲一個可交付的 SKU(即 144 卡的 Scale-Up 域),機架之間是通過有源銅纜(AEC)連接的。
跨櫃使用 AEC 的原因是無源銅纜物理距離受限,而光模塊又貴又易壞,相鄰機櫃之間的短距連接,AEC 確實是合適的選擇。兩櫃之間,機櫃內相對位置相同的芯片通過 AEC 兩兩直連,如下所示:
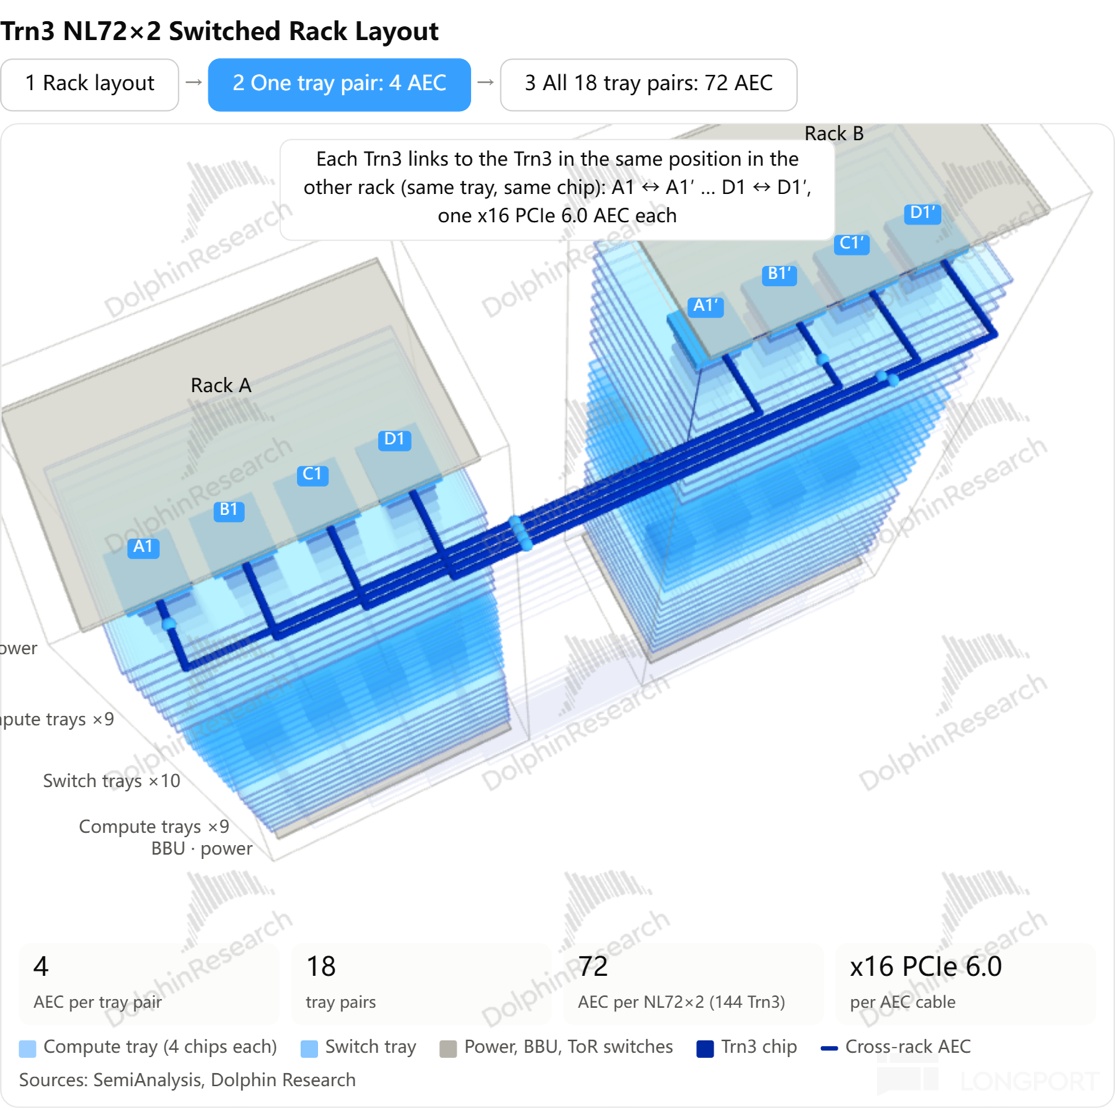
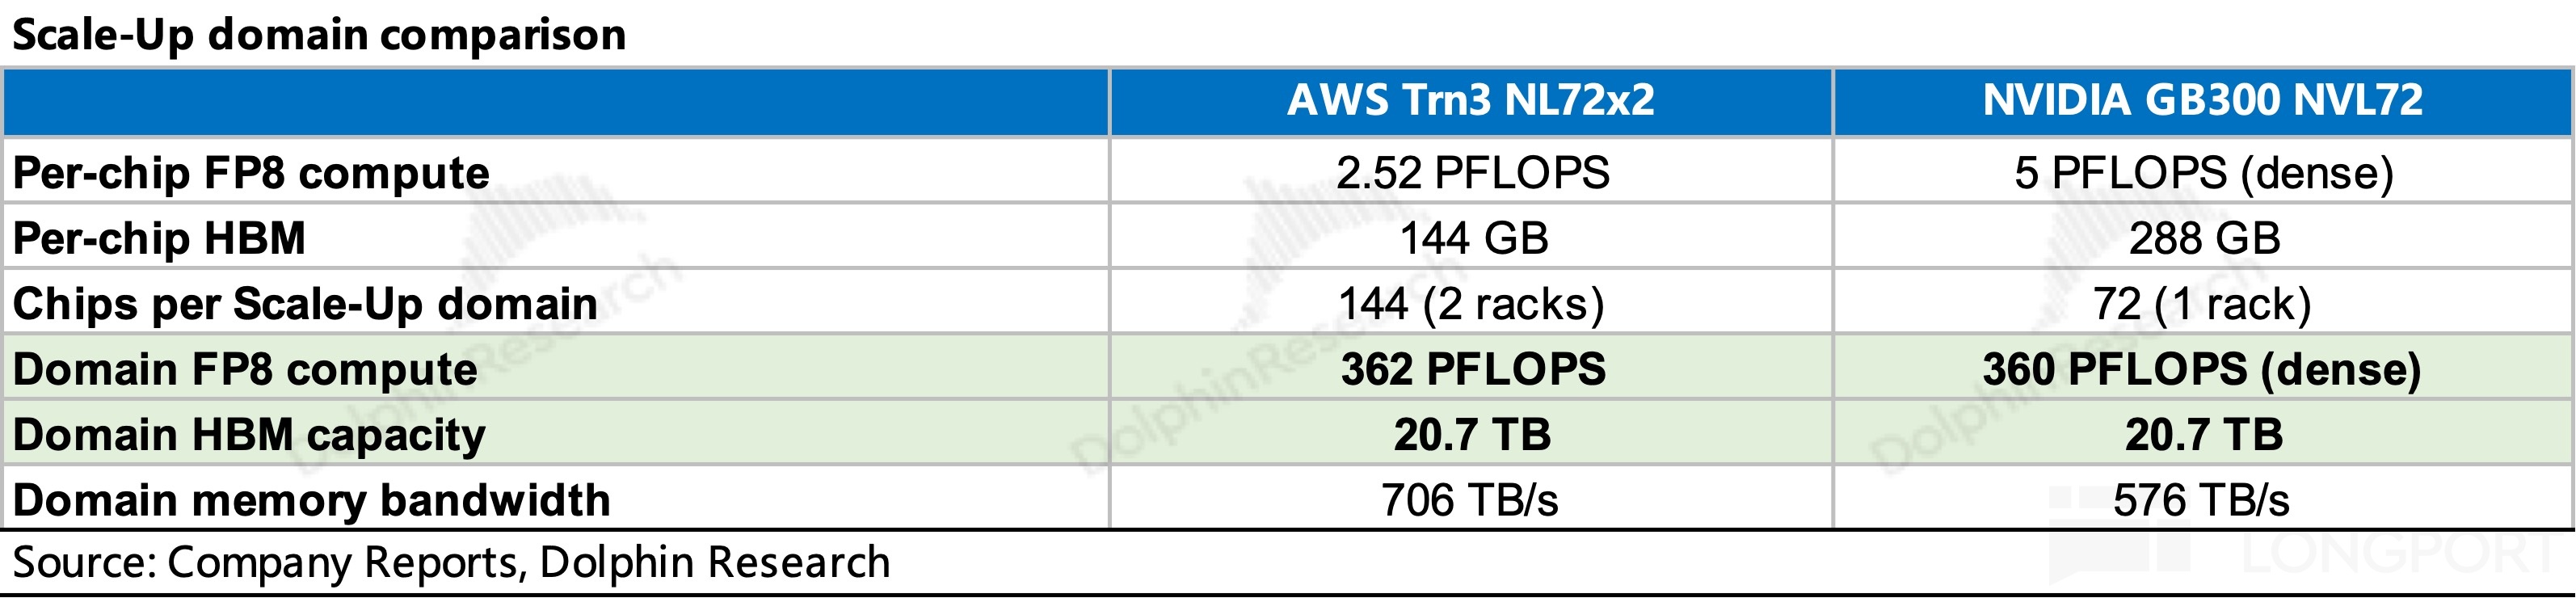
自然的疑問是,爲什麼是 144 卡?核心點在於彌補 Trn3 弱勢的算力、帶寬性能。如下表所示,Trn3 單卡 FP8 算力約爲 GB300 的一半,兩櫃 144 顆 Trn3 在 FP8 算力與 HBM 容量上正好對標一櫃 GB300 NVL72。
介紹完以上架構設計與整體性能上的類同,更關鍵的問題是,該如何理解 Trn3 的組網及其差異?
2、如何理解 Trn3 的組網及其差異?
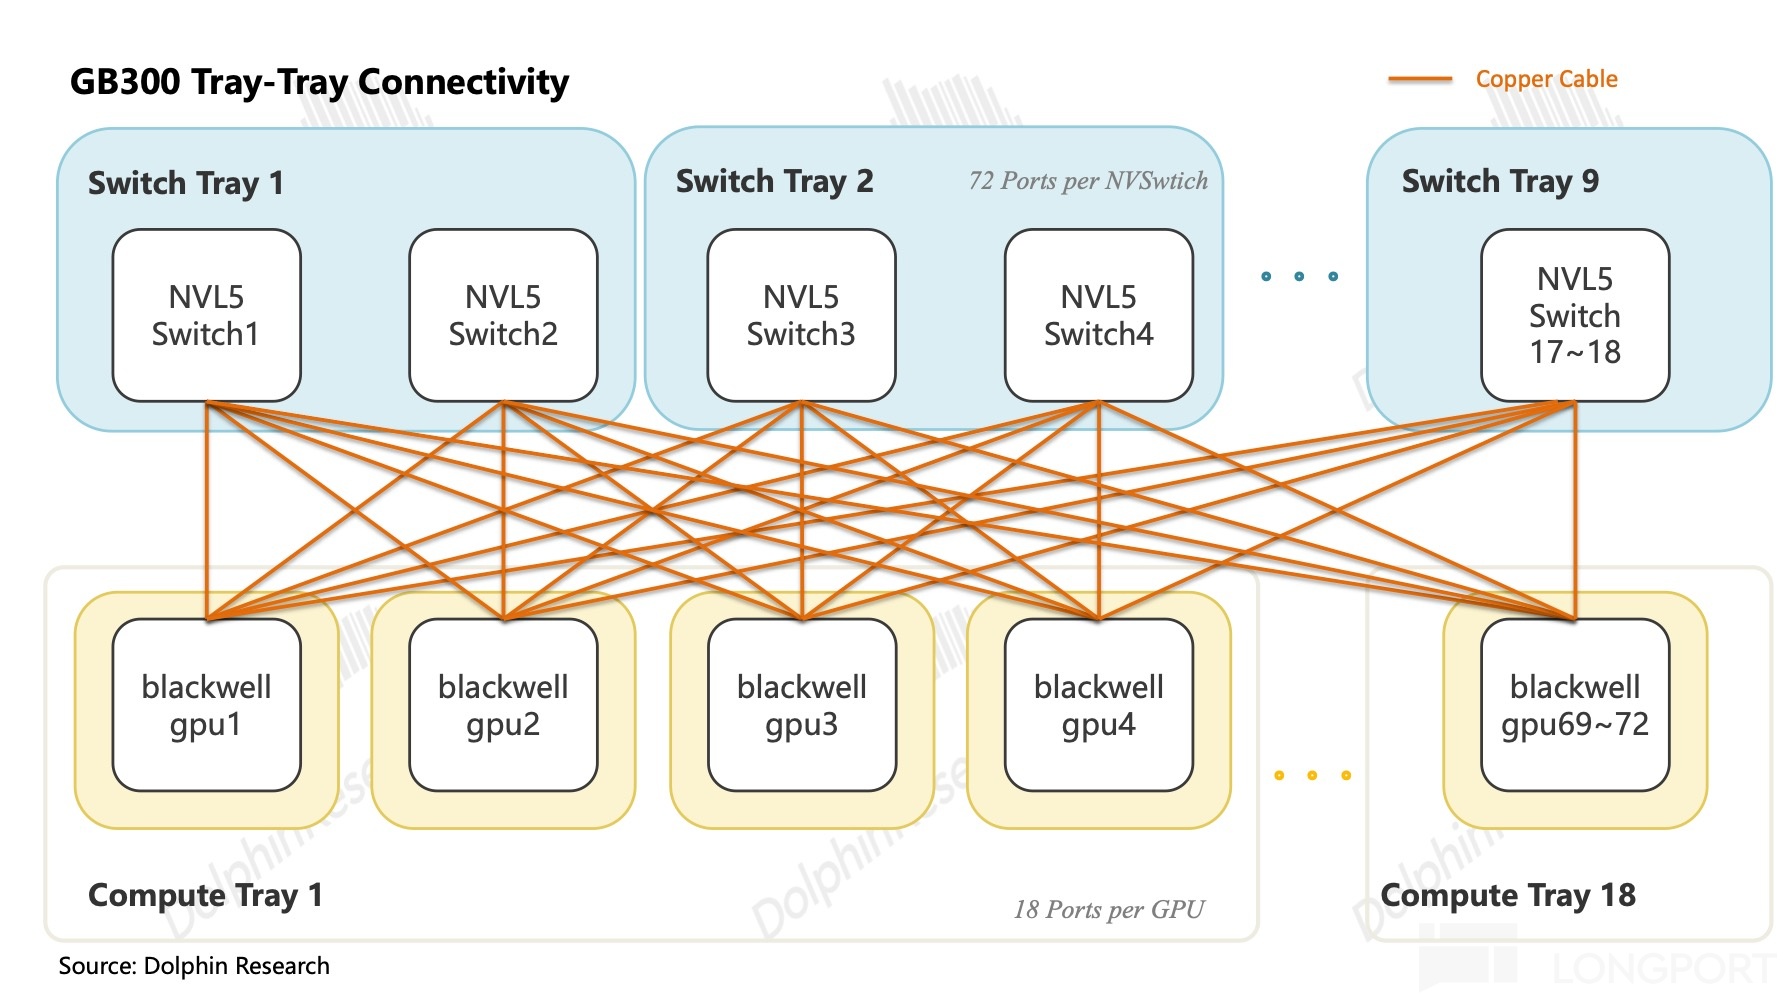
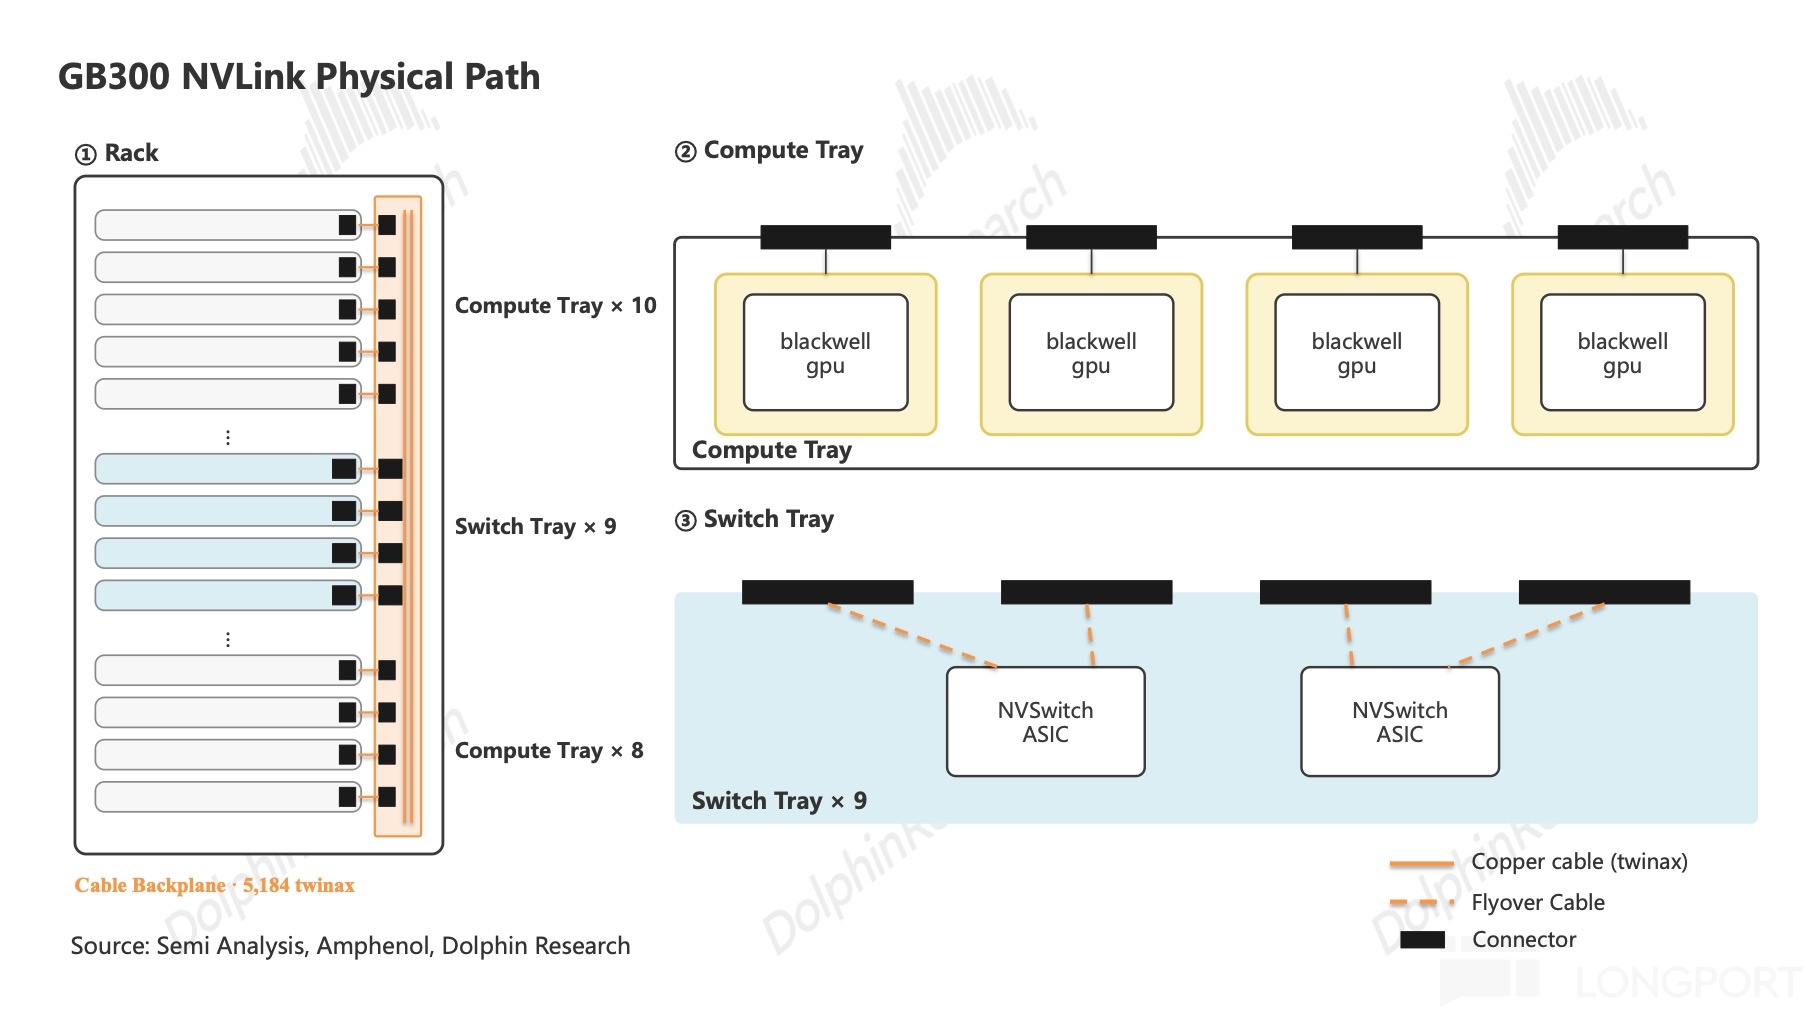
我們一直強調 Trn3 是交換式的組網,也就意味着可以參考英偉達的組網來理解。要點是,GB300 的 Scale-Up(含托盤內/跨托盤)是 72 卡全互連的,通過機櫃內交換托盤中的 NV Switch 芯片進行轉發。域內通信僅 1 跳,延遲極低。具體可參見先前的深度。
AWS Trn3 Scale-Up 域內的互連同樣需要交換芯片的轉發,但目前仍不是全互連的,需要多跳,方案整體的延遲是落後的。那麼,
3、非全互連的交換式組網是如何實現的呢?
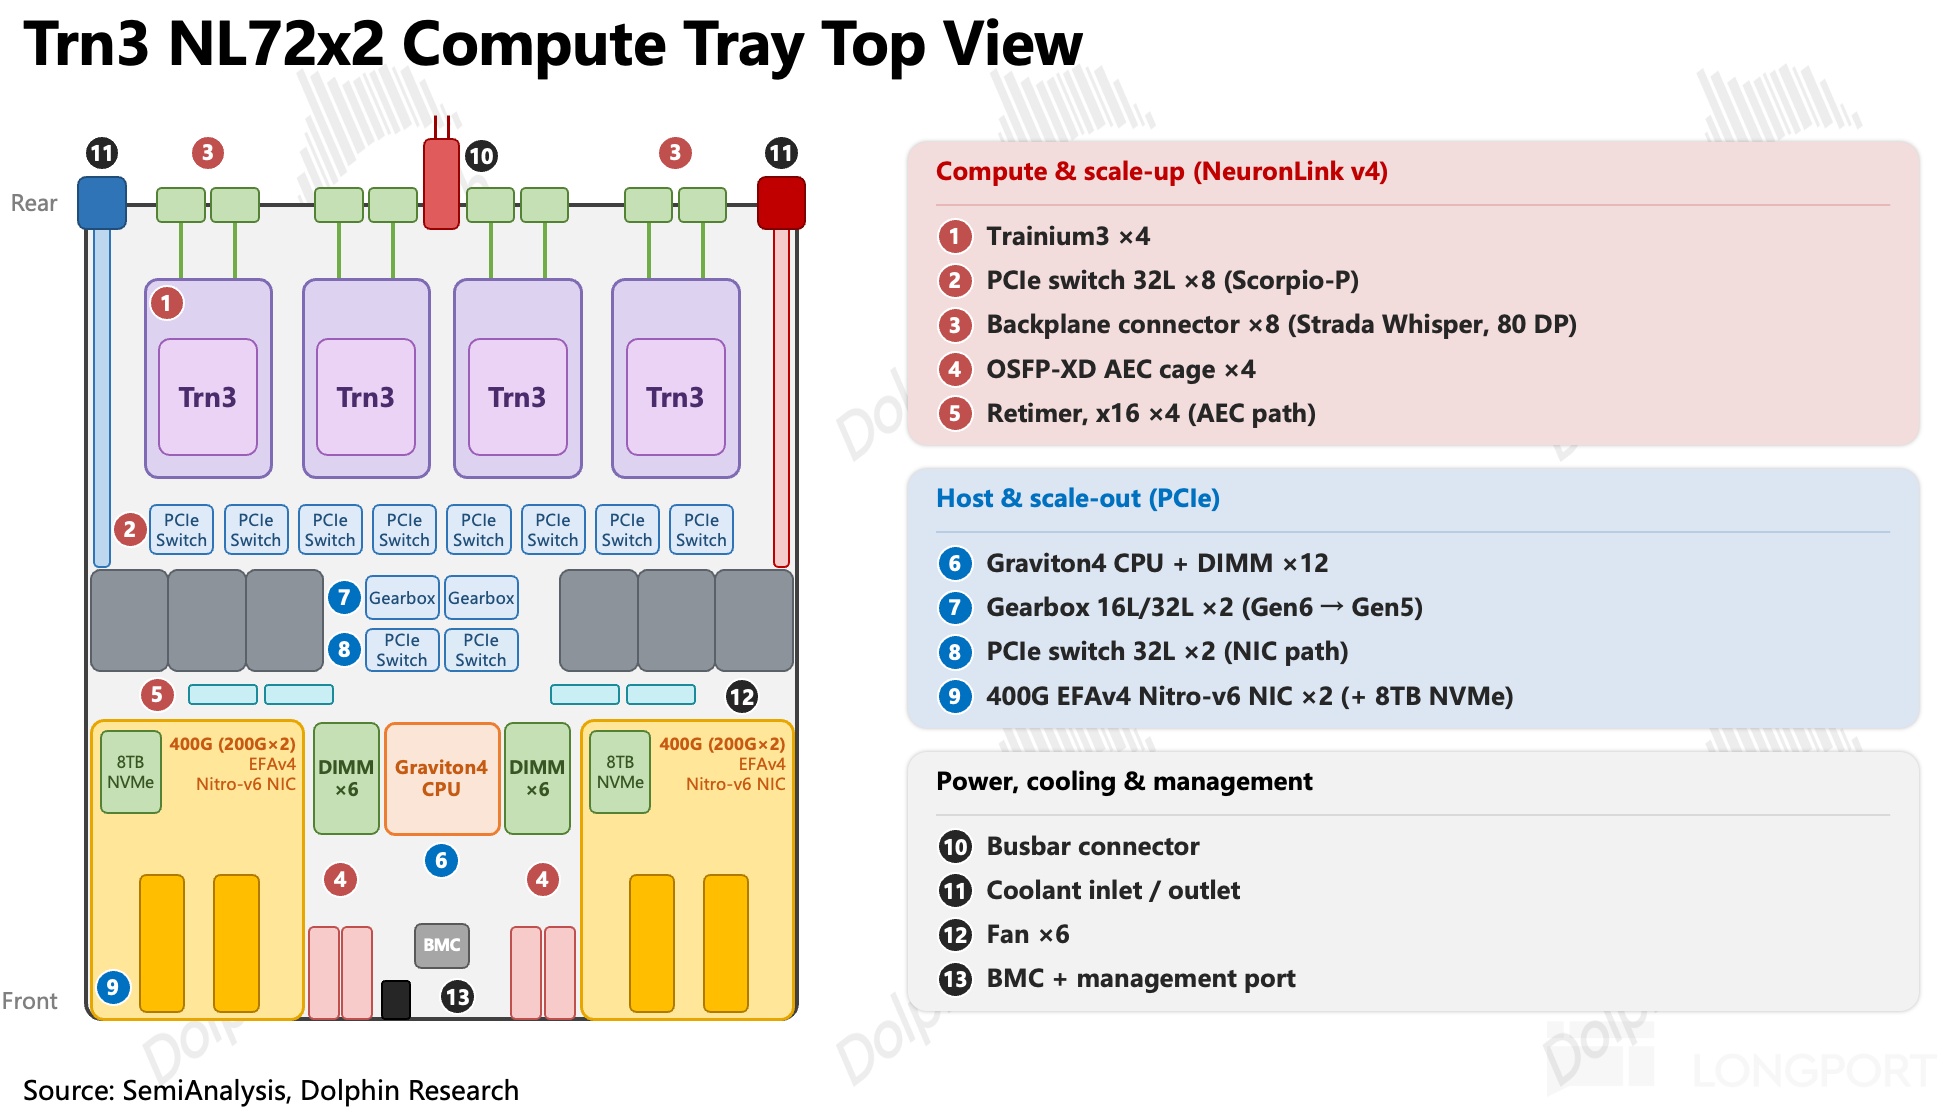
計算托盤內部元件如下,需要關注的是紅框內 Scale-Up 相關元件,此前深度中已有涉及。其中最爲核心的差異是,Trn3 計算托盤內有 8 顆 Scorpio-P 交換 ASIC(見下圖 PCIe Switch),而 GB300 內沒有,其交換芯片都外置在交換托盤內。
當然 Trn3 NL72x2 的機架內也有交換托盤,用的是 Scorpio-X 交換 ASIC。需要兩款交換芯片的原因,將在下文組網部分一同展開。(注: Scorpio-P 和 Scorpio-X 均來自美股半導體公司 Astera Labs。)
從數據流動的視角來看,GB300 的全互連的 Scale-Up 路徑可簡化成:起始 GPU → 背板銅纜 → NVSwitch ASIC → 背板銅纜 → 目標 GPU。能做到全互連,關鍵在於一顆 NVSwitch 有 72 個端口,接滿域內全部 72 顆 GPU。
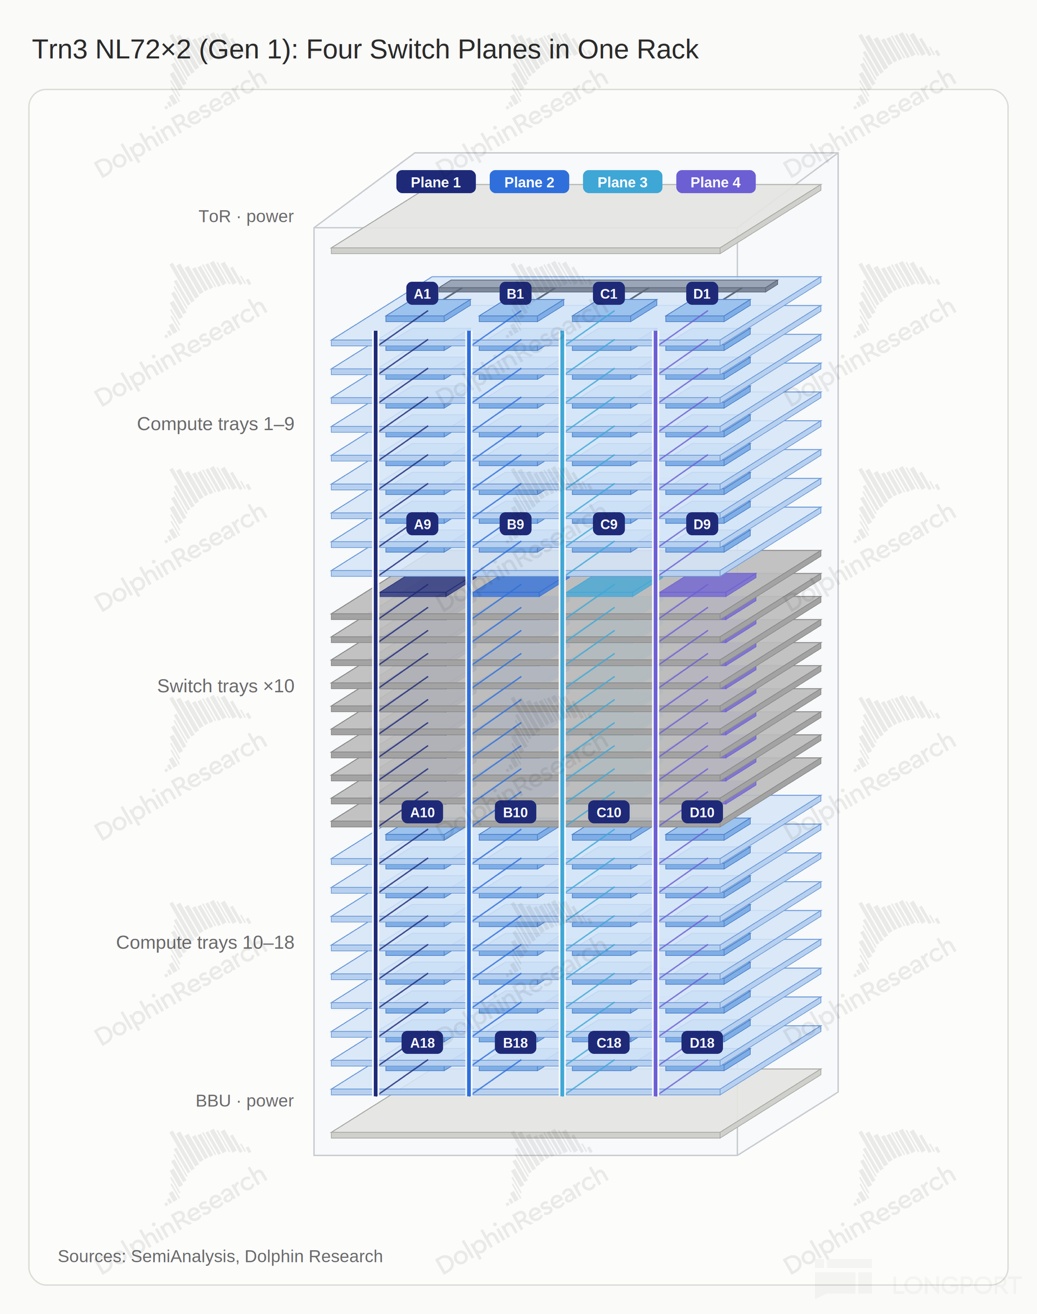
而 Trn3 的 Scorpio-X(交換托盤)只有 18 個可用端口,只對應 18 個計算托盤,而一顆交換芯片在每個托盤只能接 1 顆 Trn3。
但單托盤有 4 顆 Trn3,就得搭 4 個獨立的 “垂直天梯”(如下圖)。這樣搭下來,同個天梯上的 18 顆計算芯實現一跳互聯;但每托盤是四顆芯片,就組成了四條天梯。Scorpio-X 端口數太少,天梯之間無直聯通道。
而天梯之間要互聯,就要降到托盤內的8 顆 Scorpio-P(見前圖),而之所以用 8 顆,是托盤間一條天梯內,每個計算芯連 10 顆交換芯,每交換芯配給計算芯 8 條通道,合計每計算芯 80 條通道。
而托盤內每顆交換芯只有 32 條通道,分給盤內 4 顆芯片,每顆只能分到 8 條。用 8 顆這樣的 P 交換芯就能配 64 條通道。等於配上 8 顆 P 交換芯的組網,能保持 Tray 內的一跳,和同天梯內跨 Tray 一跳保持基本相同的通道速率。
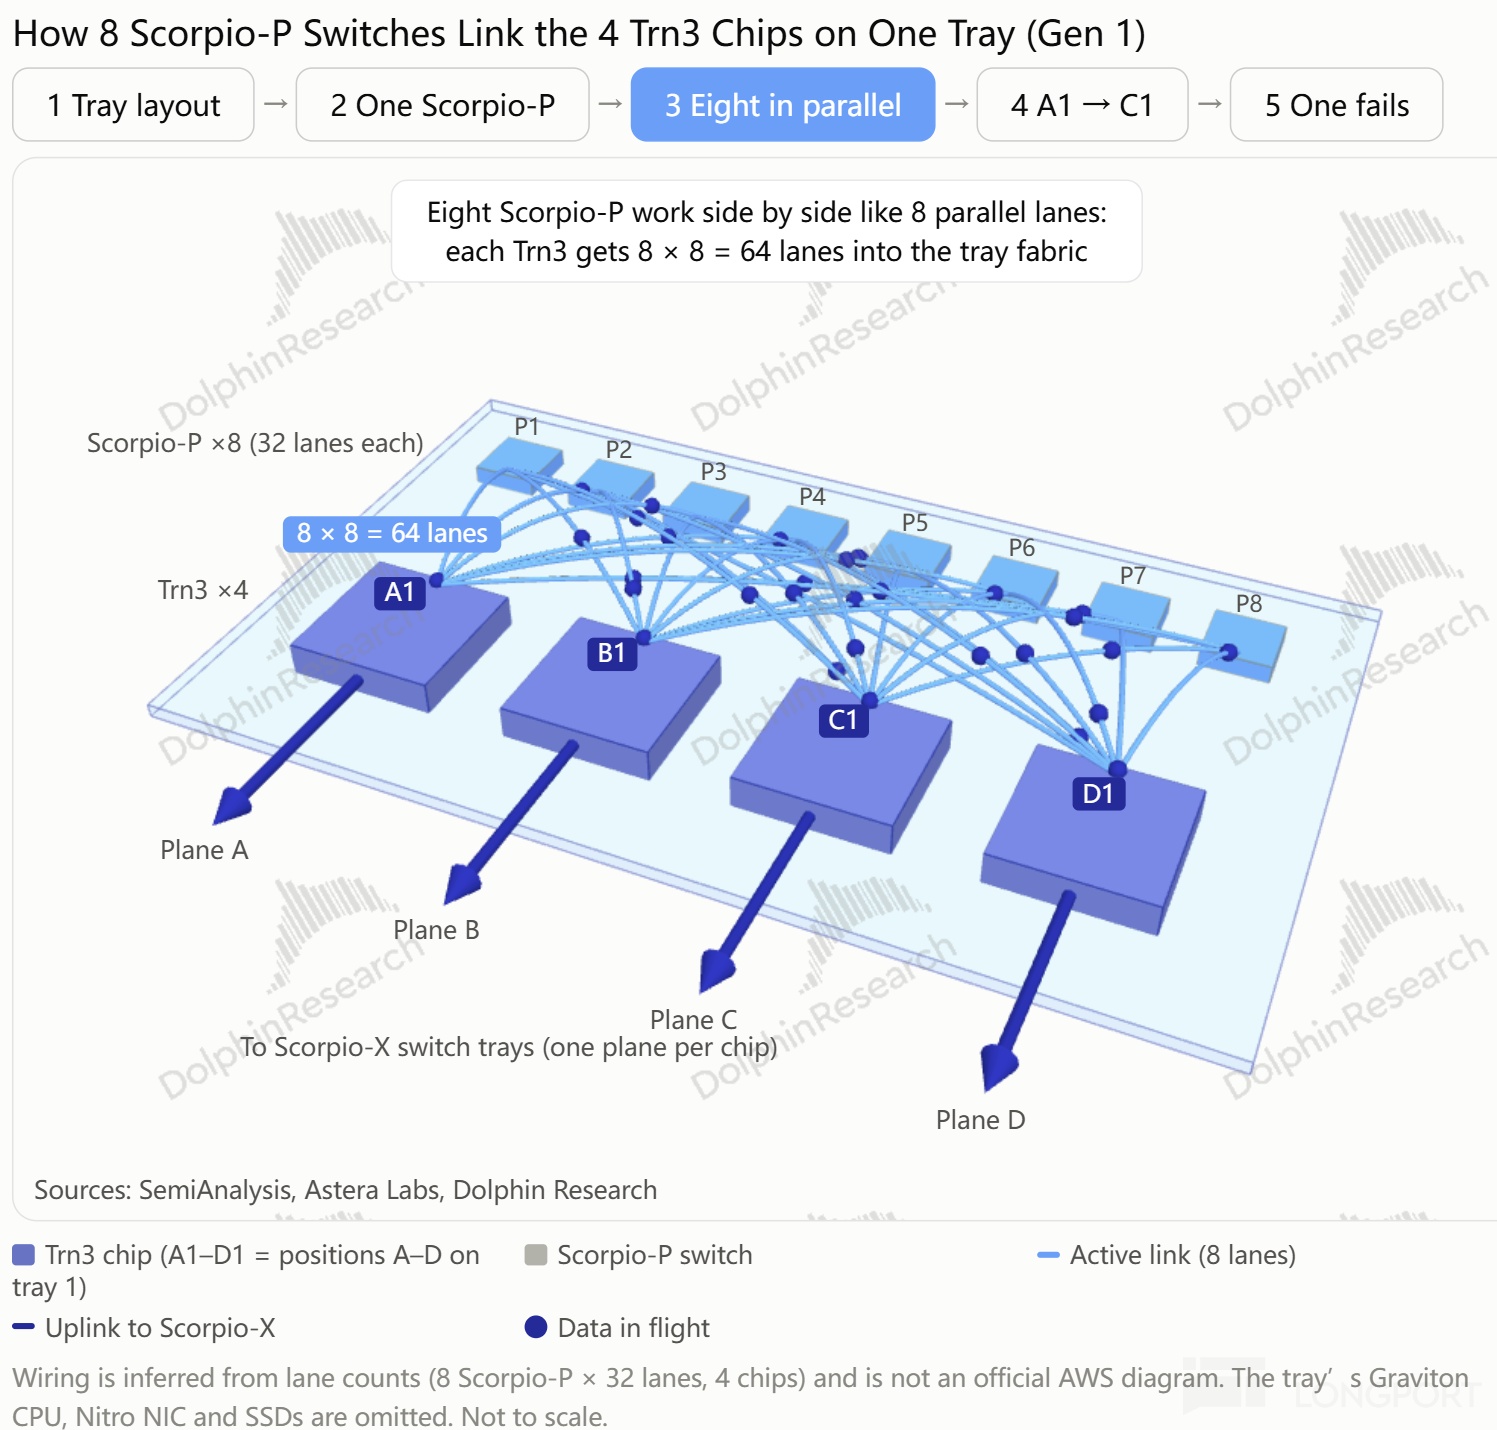
小結一下,Trn3 NL72x2 域是通過 AEC 跨櫃構成的,其櫃內類似 GB300 交換式的通信由於交換托盤內的交換 ASIC 端口數少,組網是多平面的,因此在計算托盤與交換托盤內都存在交換芯片,尚未實現全互連。
4、跨櫃:交換芯 + 跨櫃的拖累
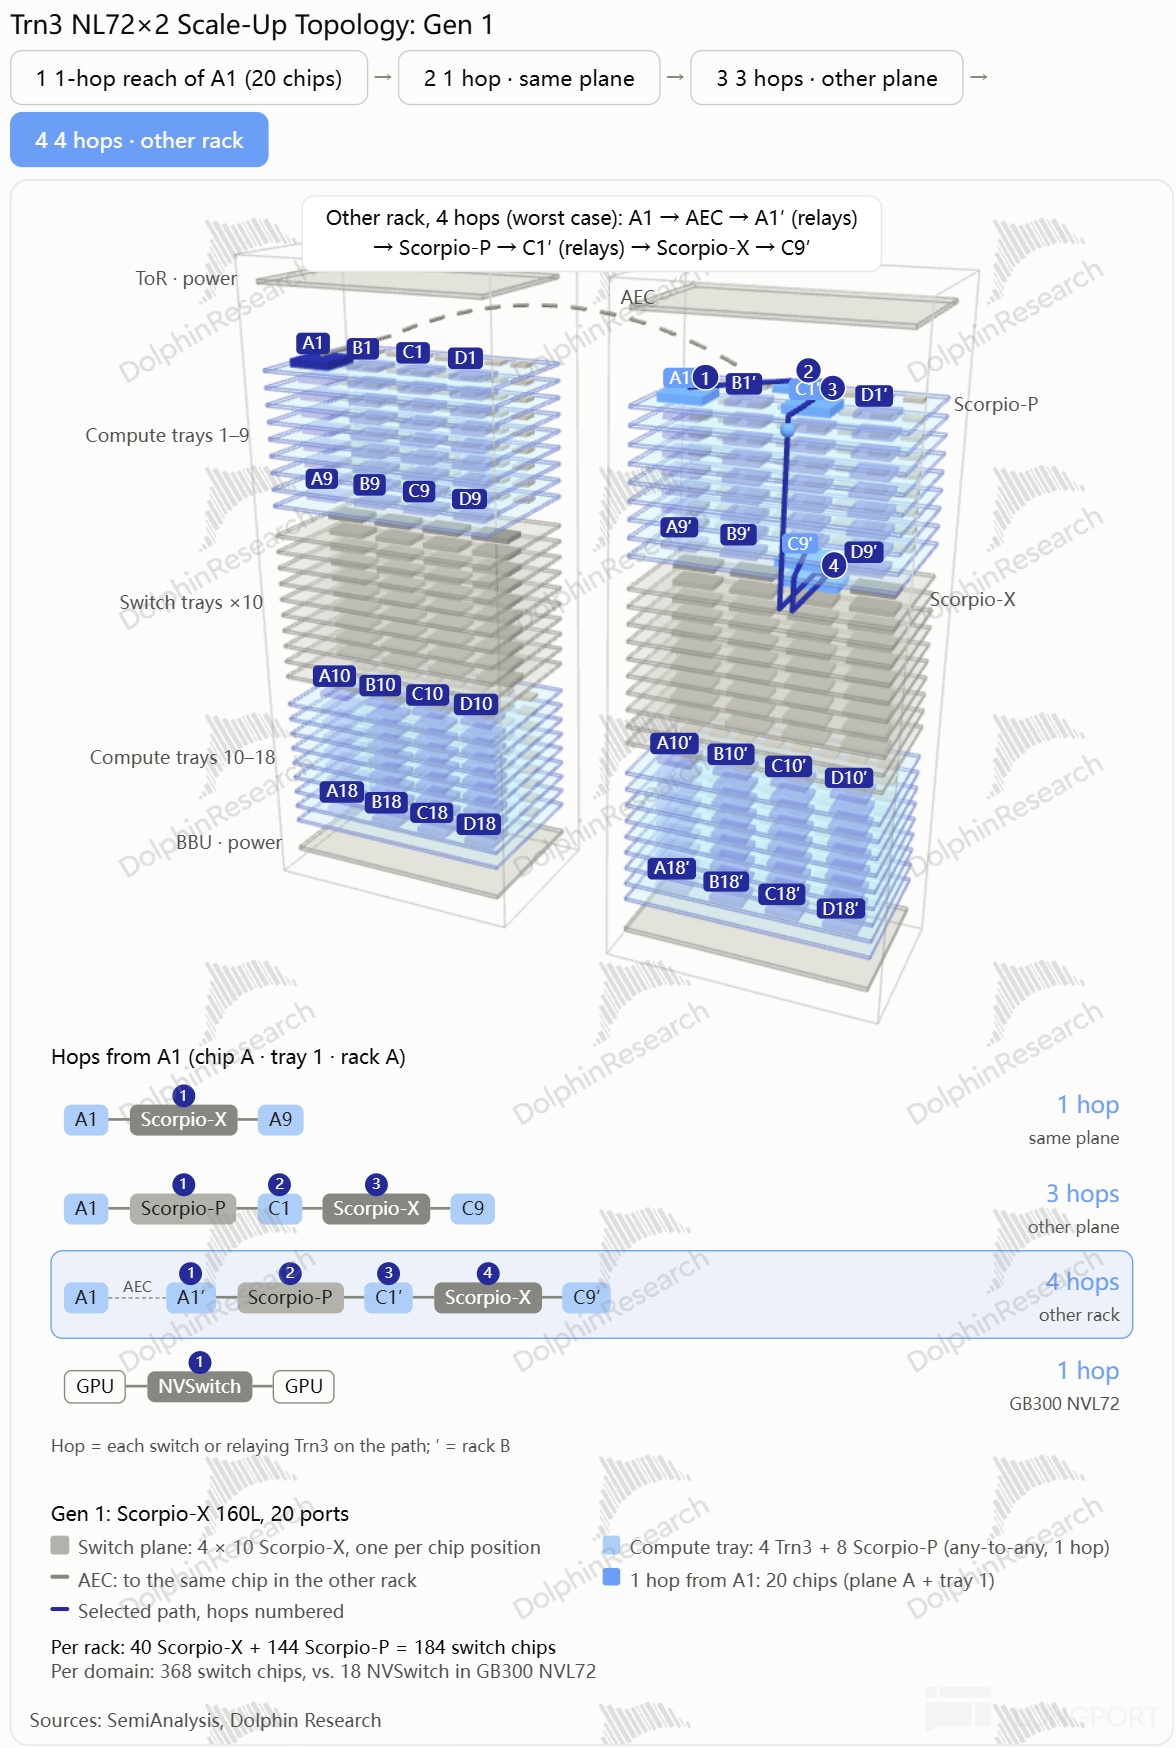
海豚君在谷歌的深度中已經指出了多跳帶來的延遲影響,其在 v8i(面向推理場景)的組網也優化了跳數。那麼在 Trn3 NL72x2 域內,跳數(延遲)如何呢?
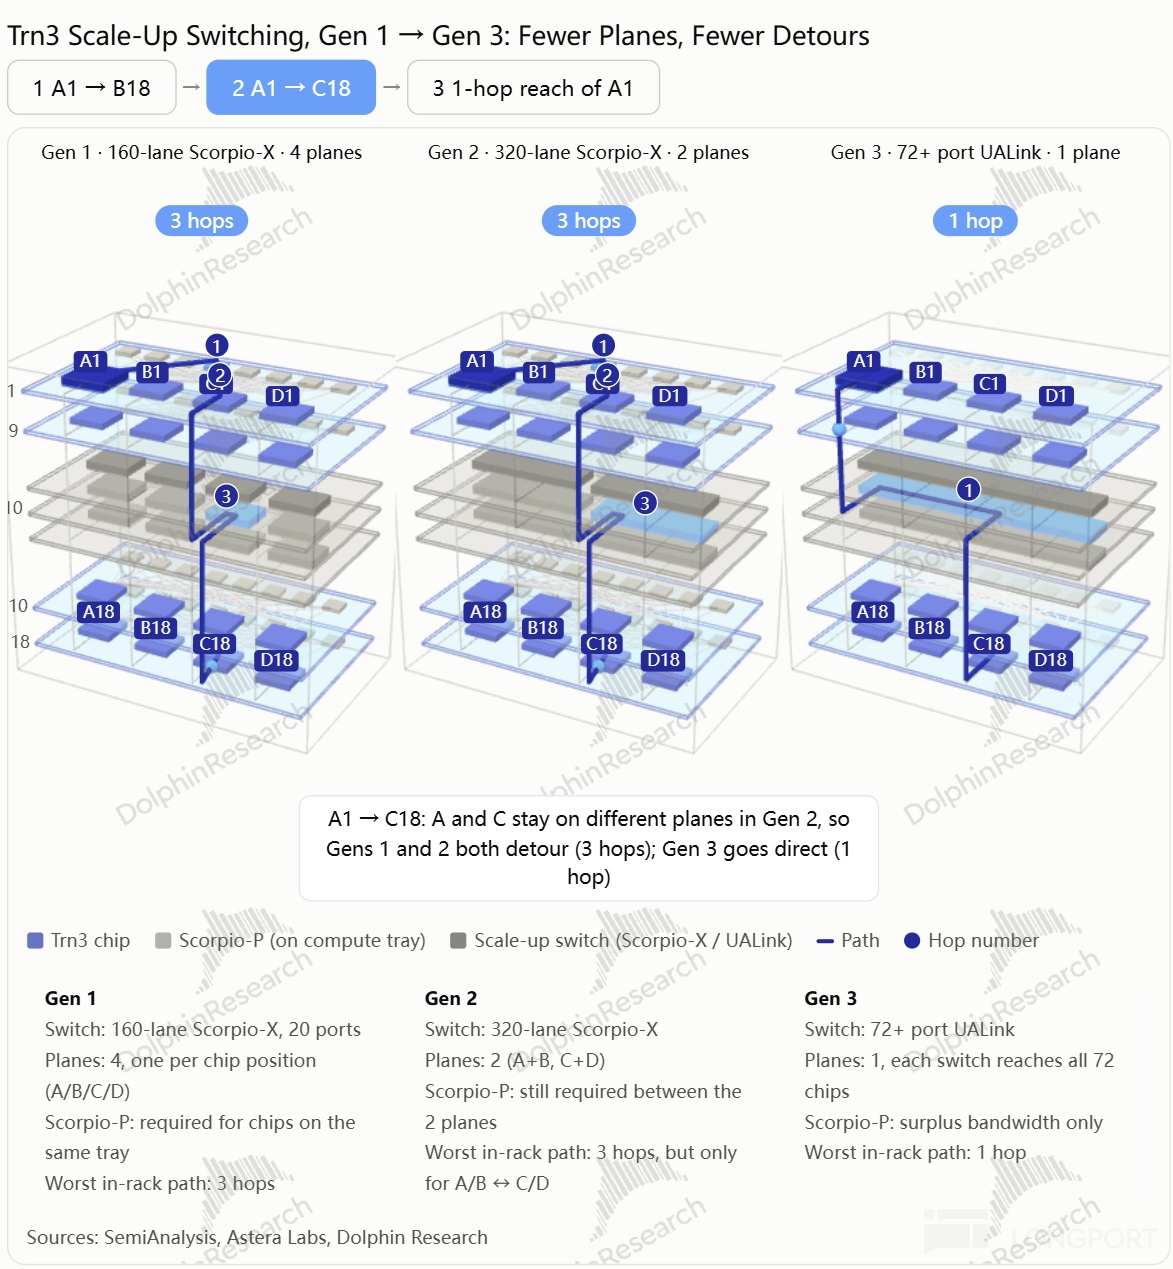
如圖,以機櫃 A 托盤 1 的芯片 A1,跨越機櫃 B,到達 C9:到托盤 9 的 A9 同在一個平面,經 Scorpio-X 直達,1 跳;到 C9 要先經 Scorpio-P 借道另一顆芯片換到 C 所在平面,3 跳;到機櫃 B 的 C9′還要再多一次跨櫃中轉,4 跳。
5、如何補課?等標品的端口數長上來
交換側的多跳、多平面,都由於交換芯片的端口數過少。AWS 的解法是 Trn3 生命週期內需迭代三代,但只替換交換托盤裏的交換 ASIC(Scorpio-X),直到採用第三代 UALink 才降到櫃內 1 跳。
a. 一代,160 通道 Scorpio-X PCIe 6.0:每櫃 4 平面,櫃內最長路徑 3 跳、跨櫃 4 跳;
b. 二代,320 通道 Scorpio-X PCIe 6.0:端口翻倍,平面由 4 個減爲 2 個,托盤內相鄰芯片仍經 Scorpio-P 互連;
c. 三代,72+ 端口 UALink 交換機:每顆交換機可接櫃內每一顆 Trn3,櫃內變全互連,實現 1 跳,但跨櫃仍需兩跳。跳數減少將拉低整體延遲。而計算托盤內的交換芯片不再是必經的中轉,但仍然在成本側。
二、小結:跑得快,但跑得遠嗎?
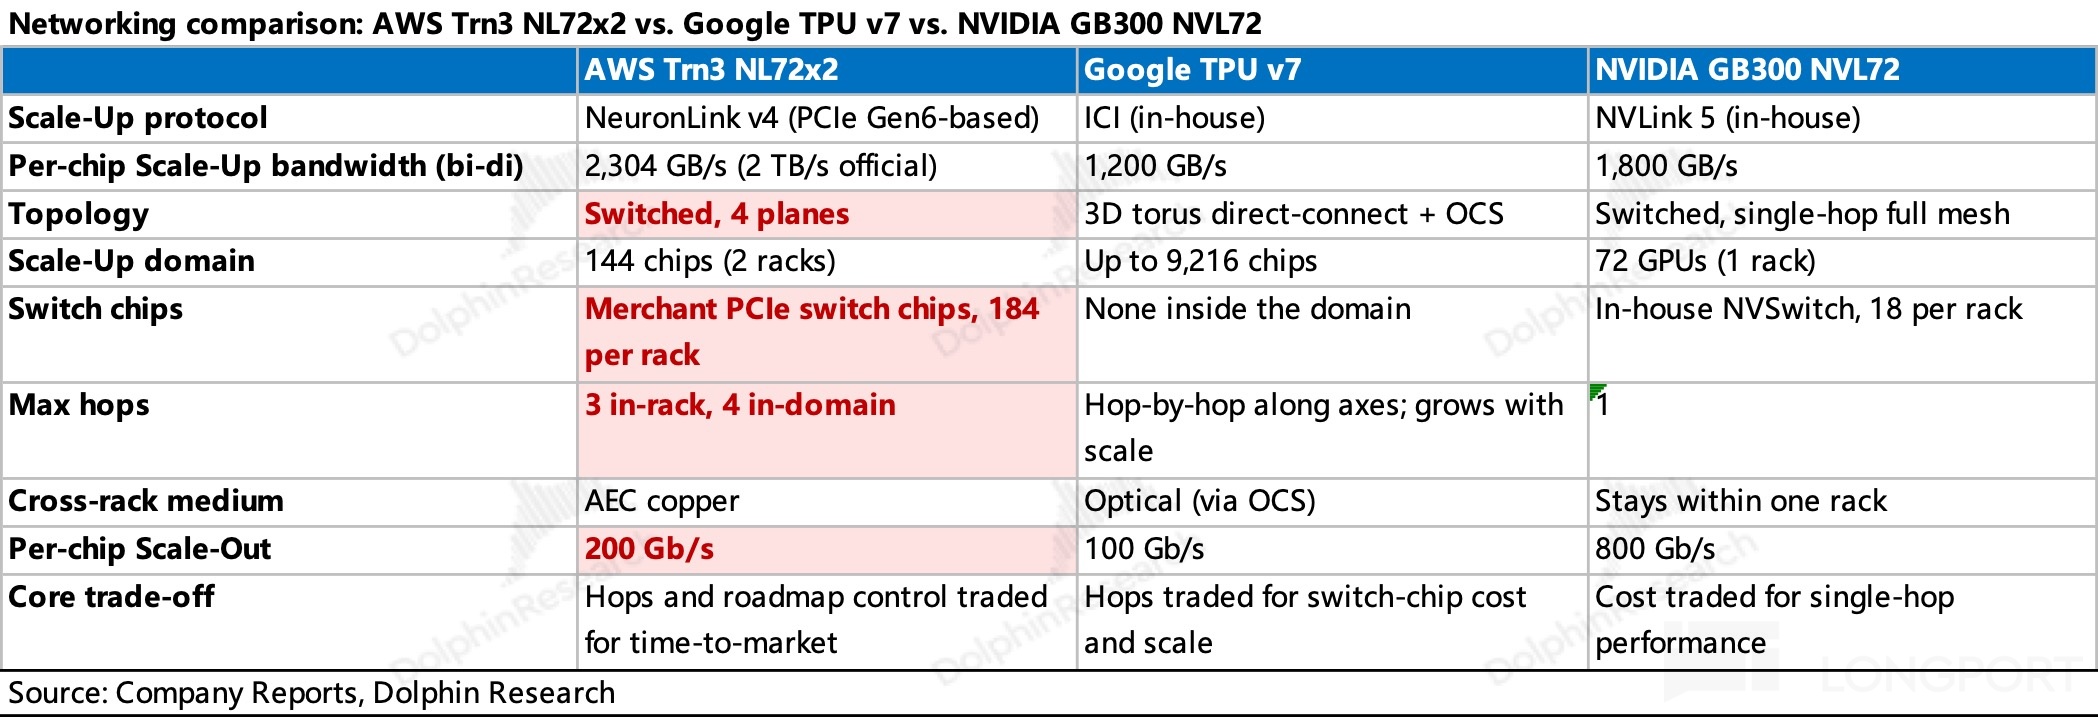
結合上篇來看,AWS 的組網並不依靠自研求差異化和高性能,而是撿市面上立即可用的標準件,低成本組網,其實就是圖省事的火速投用。
Scale-Up 層:
- 協議層面,基於 PCIe 的 NeuronLink 是圖省事的做法,中長期看是會被取代的。
- 組網上,由於 3D torus 的大規模組網對廠商軟件以及網絡基礎設施的要求較高,AWS 被迫轉向交換式連接。
但作爲核心硬件的交換芯片採用的是標品,端口少,即便採取了交換式拓撲仍然需要多跳,跳數改善要等高端口數的交換機出貨。
Scale-Out 層:每卡 Scale-Out 帶寬僅 200Gb/s,近兩代無提升;交換芯片同樣外採。
換言之,AWS 的組網缺乏自主權,其端口數、跳數、升級節奏都取決於供應商。因此,單論組網,AWS 既沒有英偉達的性能,也沒有谷歌的規模,競爭力並不強。
中長期看,Trn3 仍在等着 UALink 交換機的出貨,那麼 Trn4 的組網相較於其它廠商的組網方案差距可能會進一步拉大。
三、AWS 鏈的機會在哪裏?
如上所述,AWS 不是奔着打贏英偉達、AMD、谷歌去的。接下來我們來探究下其產業鏈的機會在何處。
1、組網真的便宜嗎?
AWS 組網硬件多爲採買標品,或許不必爲定製化支付溢價。
NL72x2 的單域(即雙機架)組網成本測算如下:
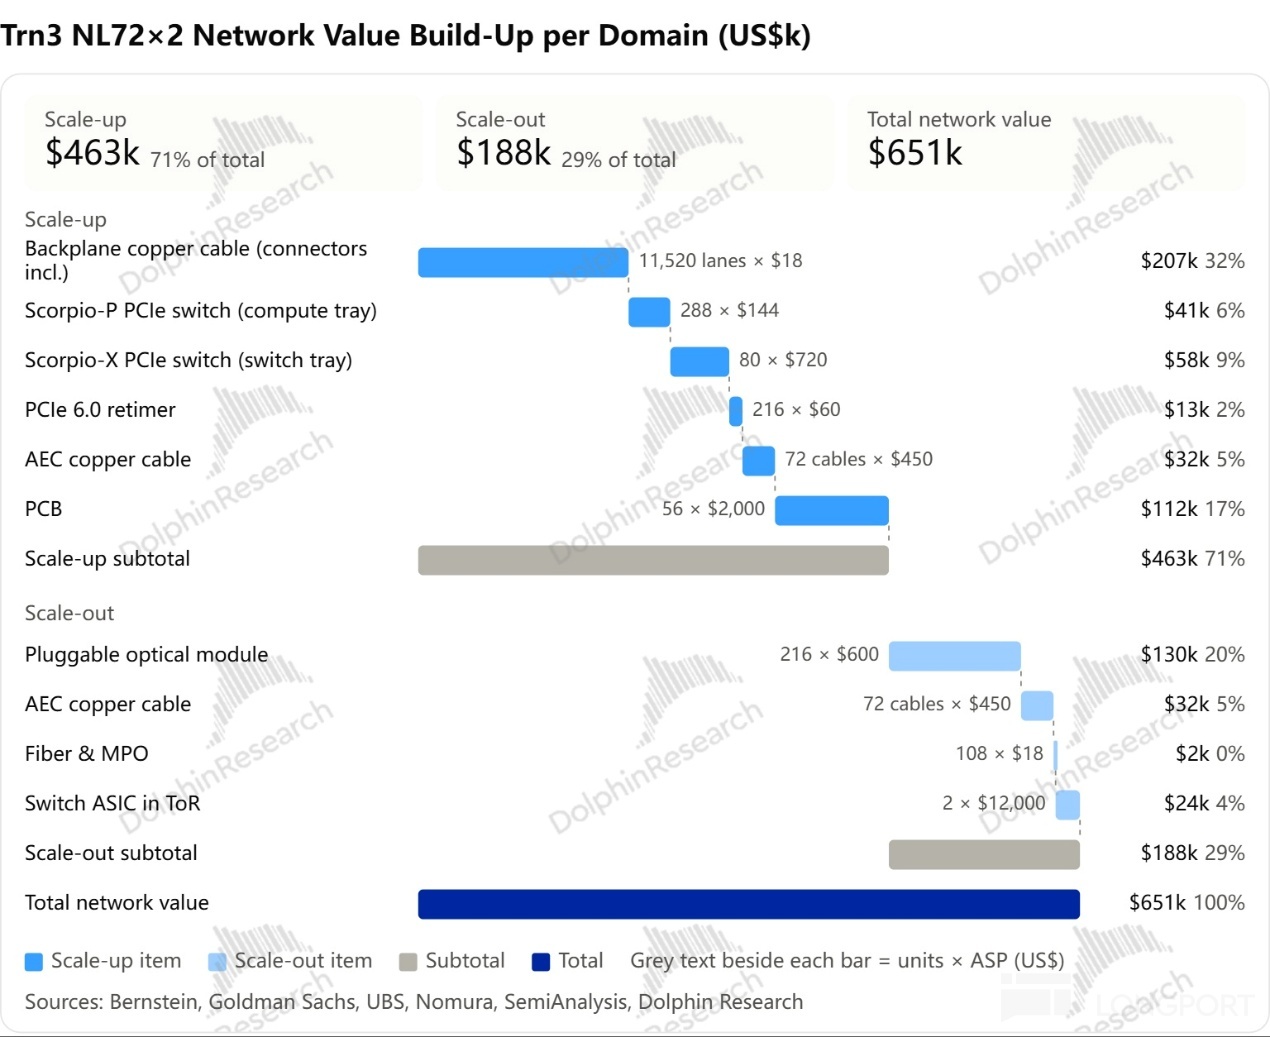
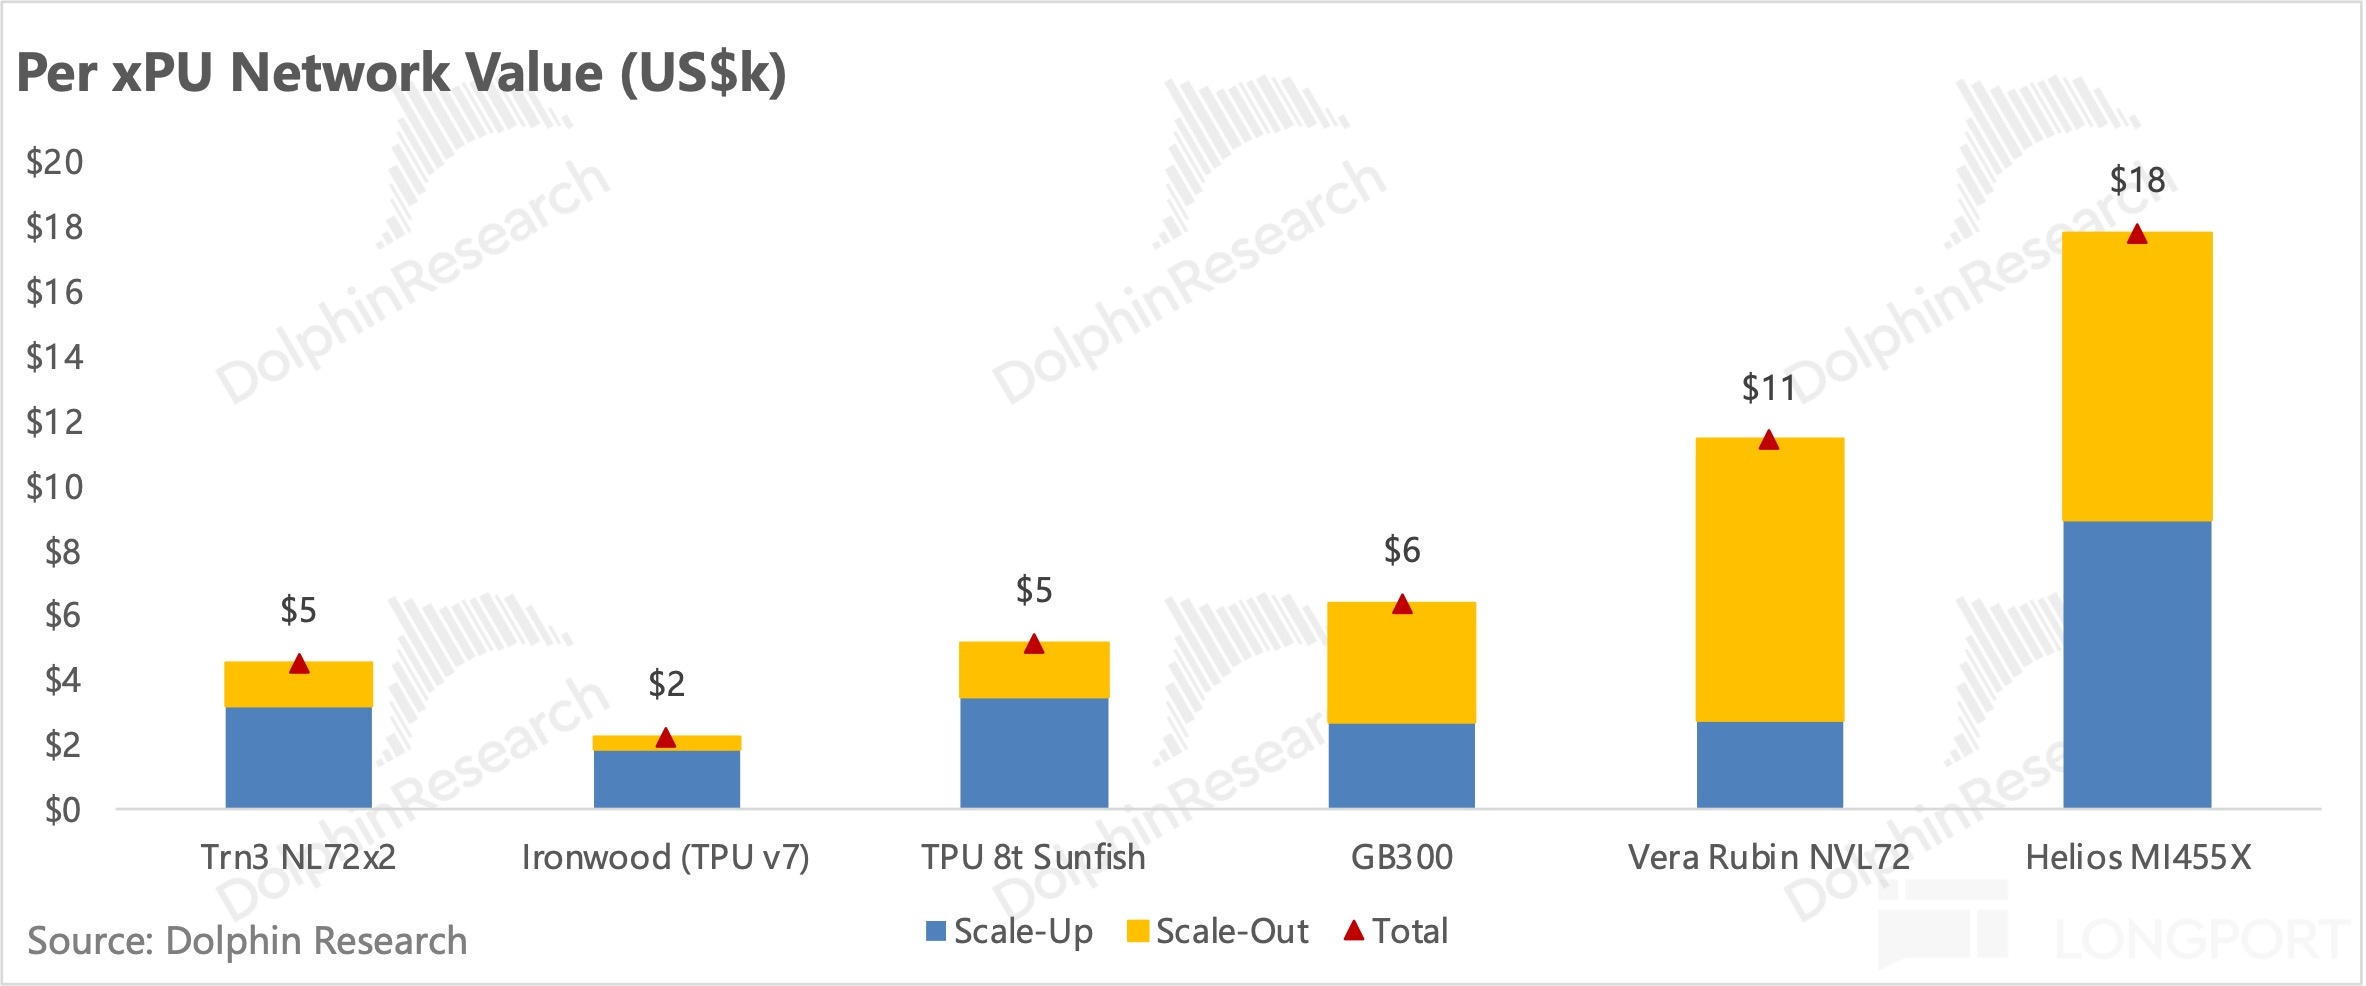
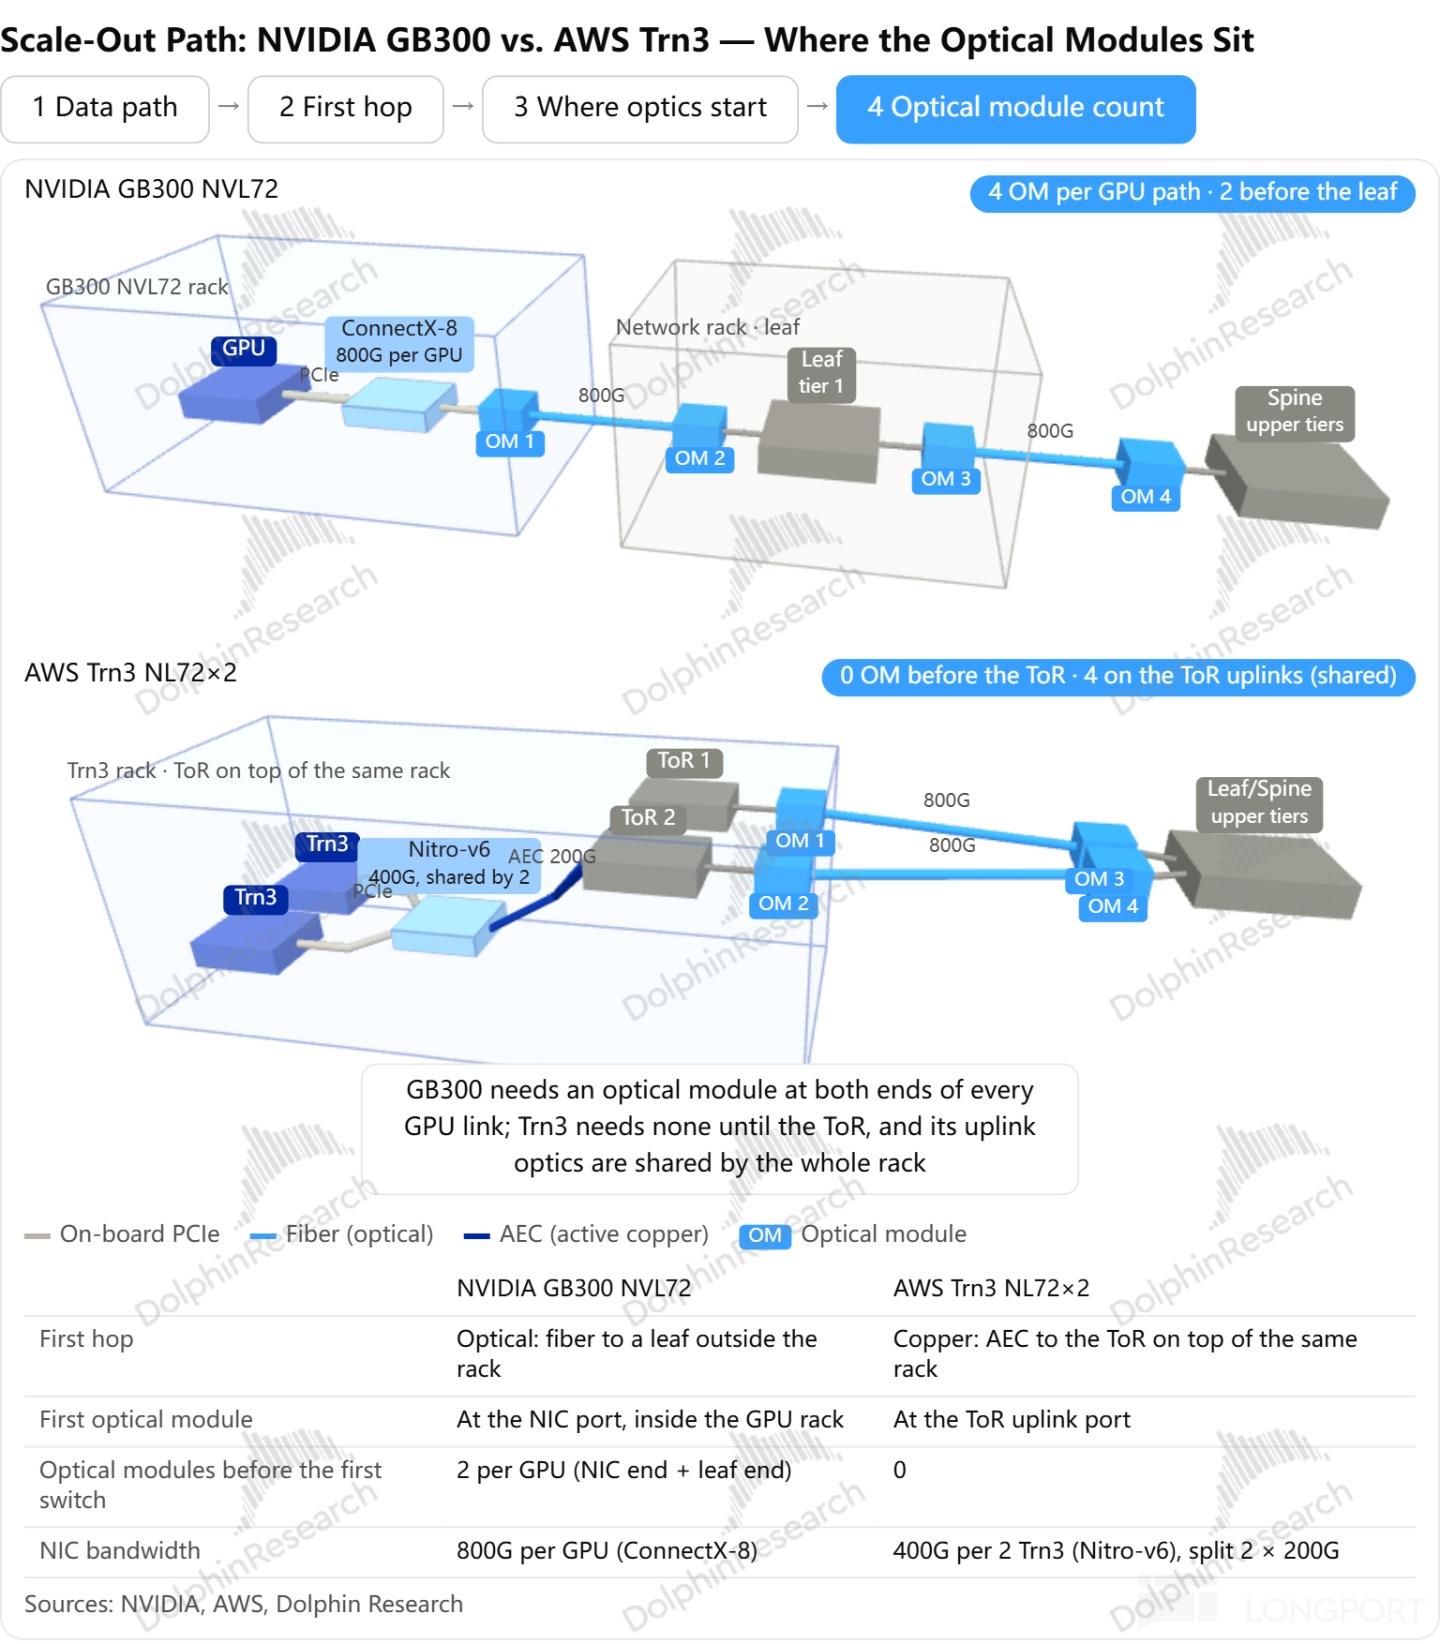
初看單卡組網成本,AWS 的策略是成功的,機櫃形態基本對標 GB300,單卡組網成本卻更低。省下的錢主要來自 Scale-Out 側光模塊的節省:主要是省去了網卡與 ToR 層的光模塊。Trn3 的 Scale-Out 流量先經 AEC 銅纜接到櫃頂部的兩臺 ToR 交換機,因此光模塊只出現在 ToR 層及以上的鏈路。
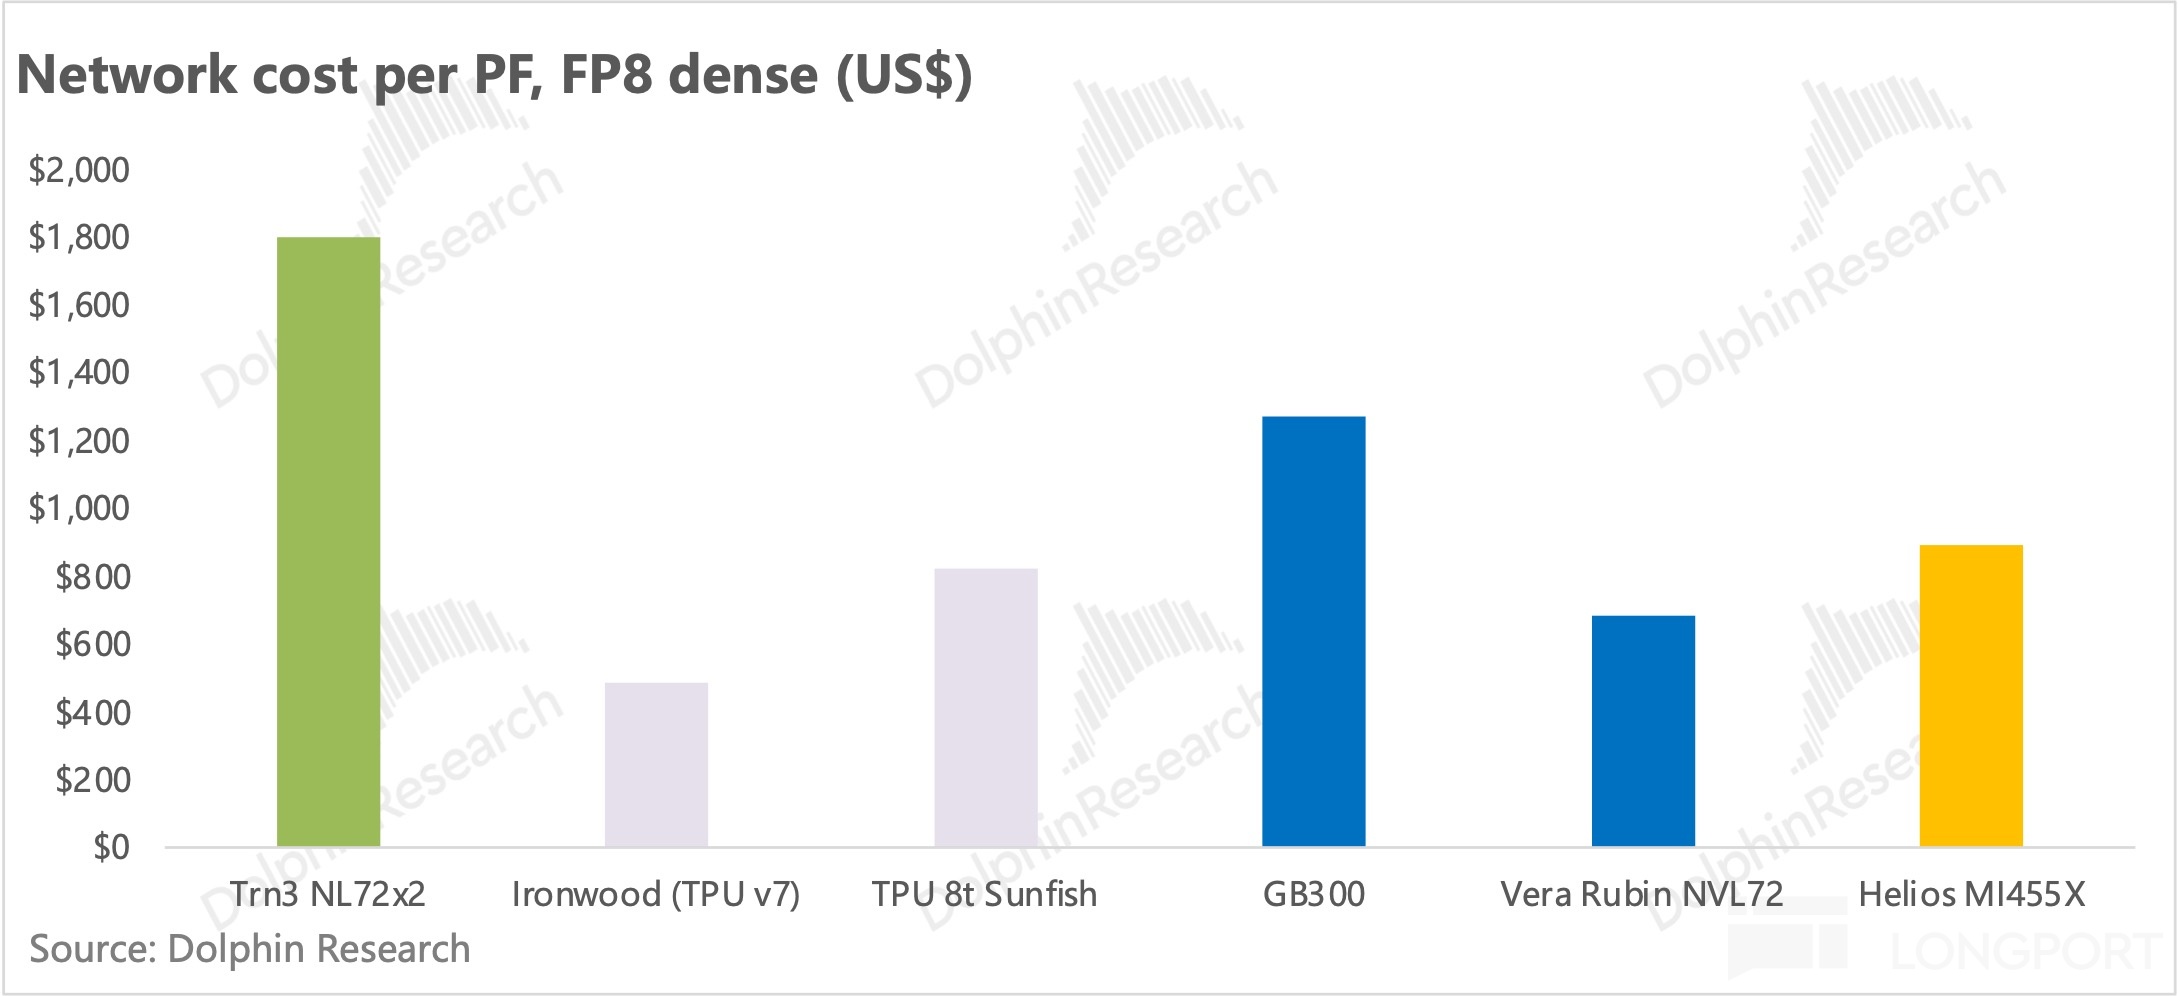
若折算到同等算力,結論與上文一致,Trn3 的組網性價比不高,競爭力並不強。
2、如何看待產業鏈機會?
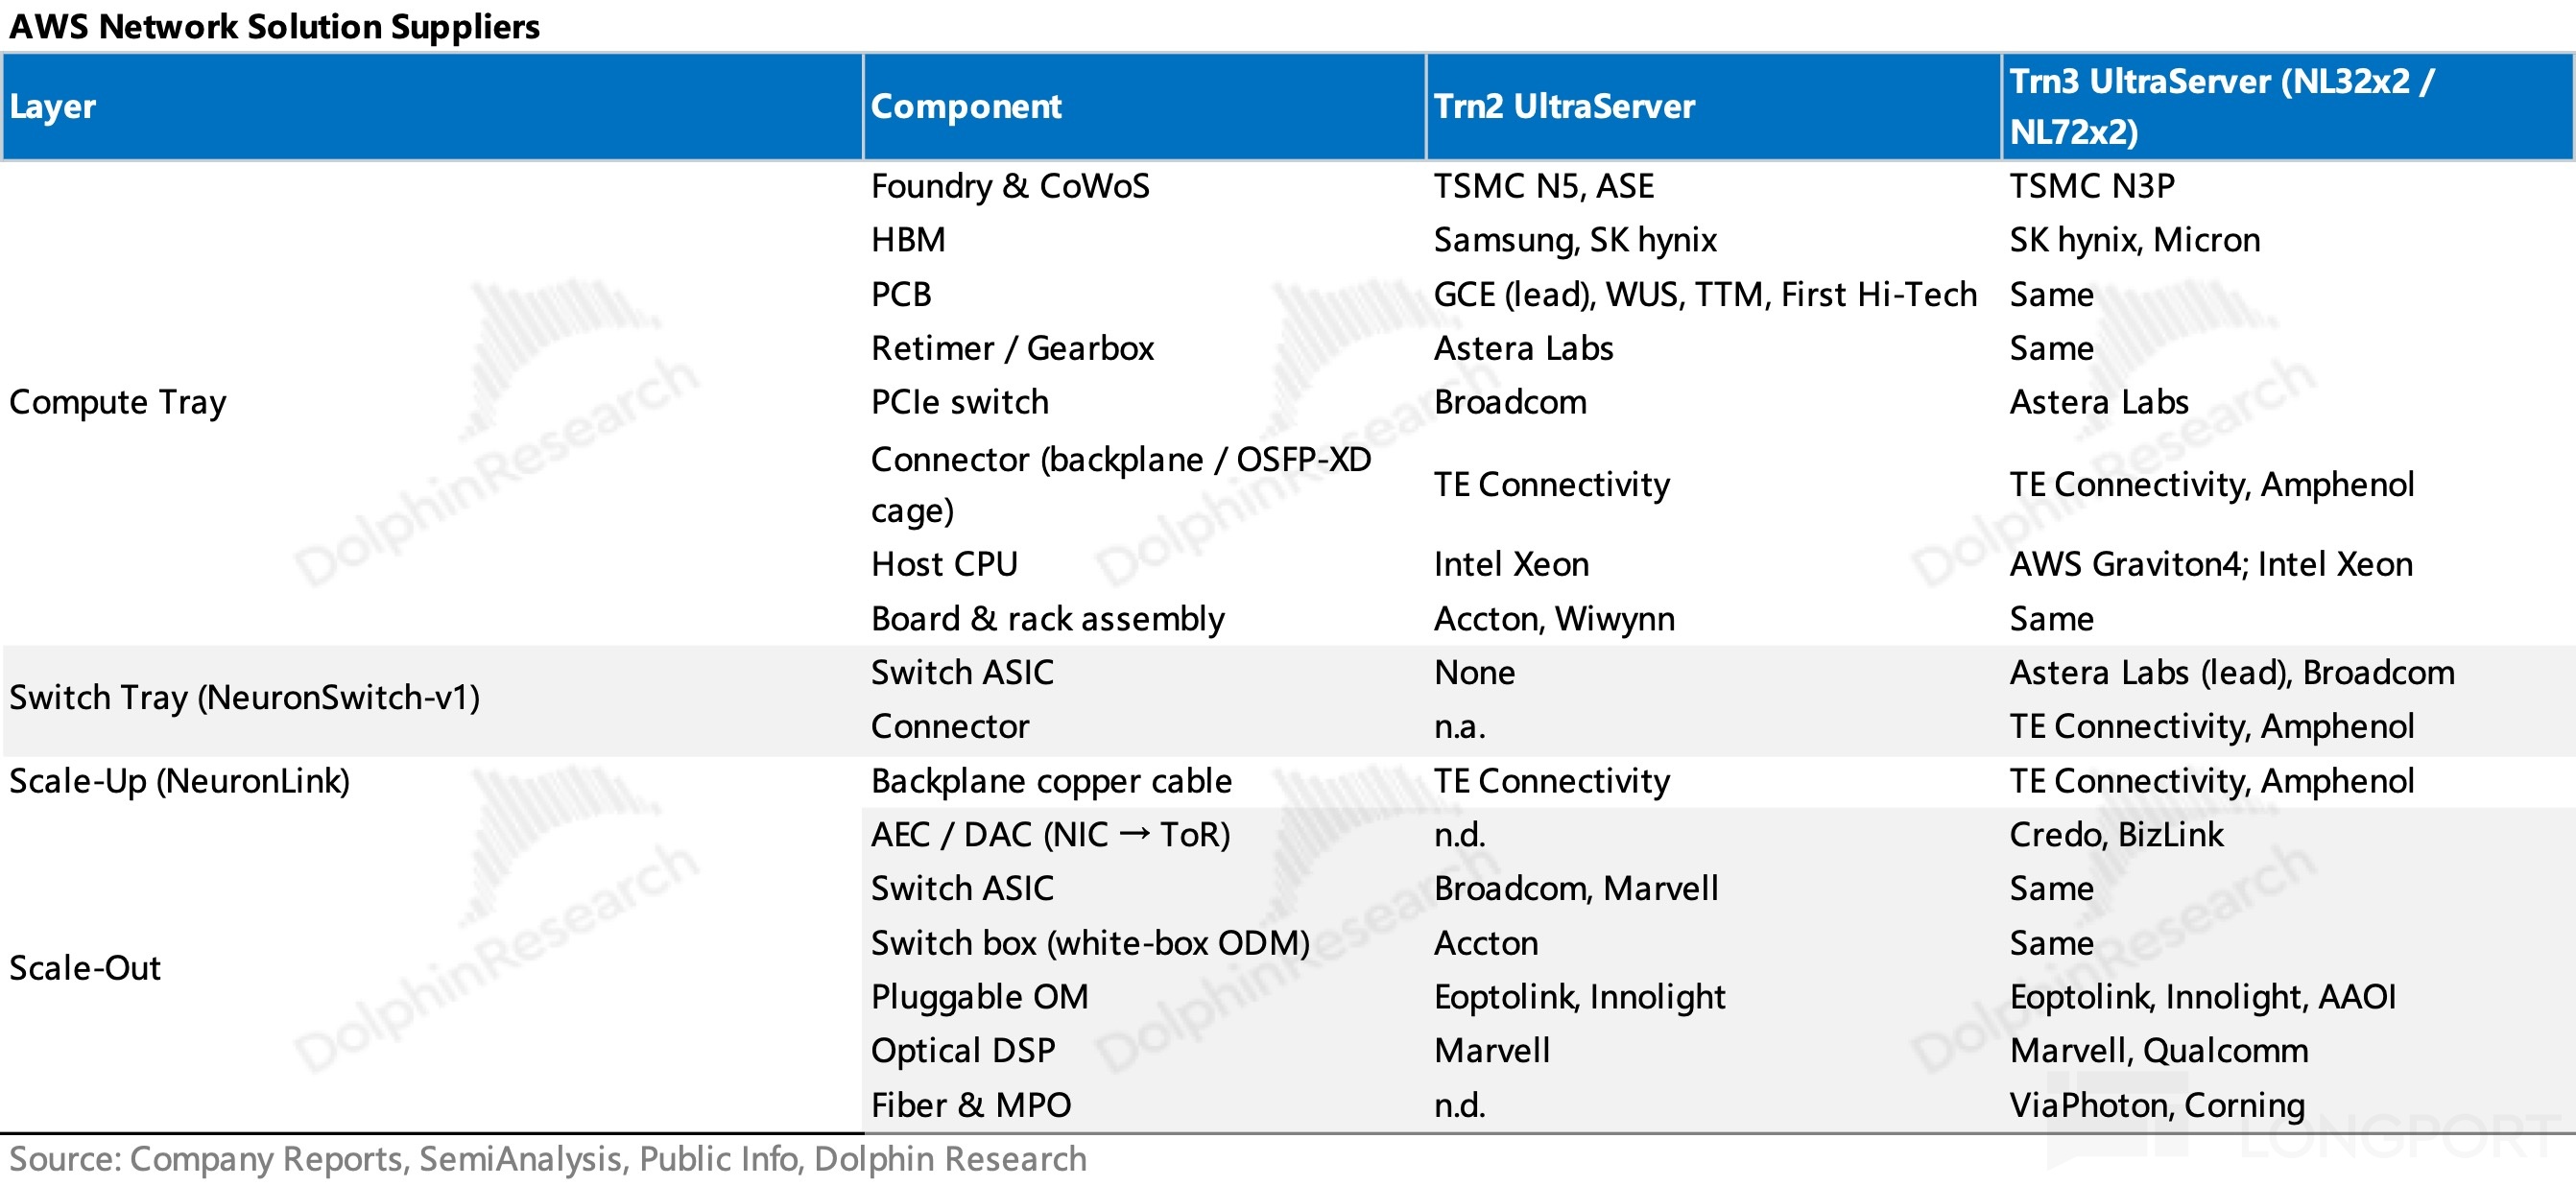
AWS 對標品的採買,除了壓低組網成本,也意味着供應鏈高度多元,因此,鏈條上價值量以及確定性就極其關鍵。
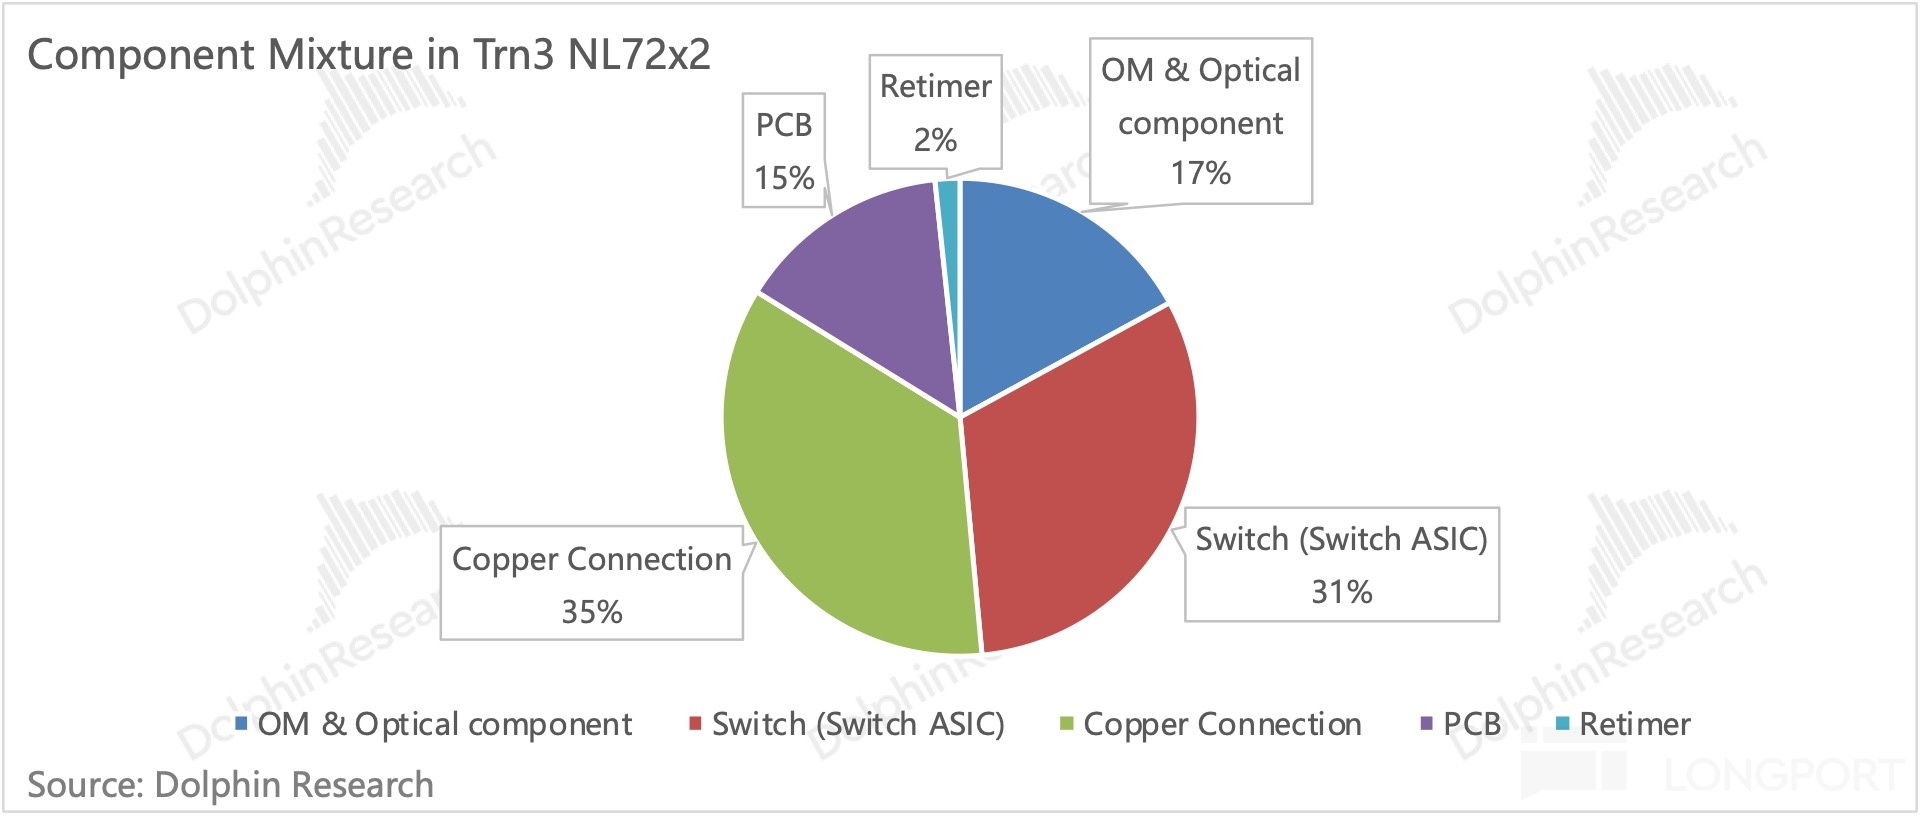
單機櫃的價值量上,銅連接最大,其後依次爲交換、光連接、PCB、PCIe Retimer。
確定性上我們從方案迭代角度考慮:
我們認爲確定性最強的是 PCB。因爲無論 Trn4 走哪條路,板材都需要升級:
- 若繼續走 PCIe,代際迭代會同時抬高板材、Retimer 與 SerDes 的要求,Gen7 對板材壓力更大。但其中只有板材是剛性的:Retimer 並非必需品,SerDes 強的方案(如英偉達)可以不用,PCB 板材增強後亦可能移除部分 Retimer。
- 若轉向 NVLink(Trn4)或 UALink,單通道速率達到 200G,信號需要 M9 乃至更高等級材料,確定性更強。
其次是光連接和銅連接。
- 大規模組網需求下,Scale-Out 使光連接的確定性與價值量雙雙抬升。
- 銅連接仍將以櫃內連接爲主要場景,AWS 在跨櫃組網上是 AEC 的忠實採用方,但無法排除 AWS 趨向行業方案、跨櫃走光的可能性。
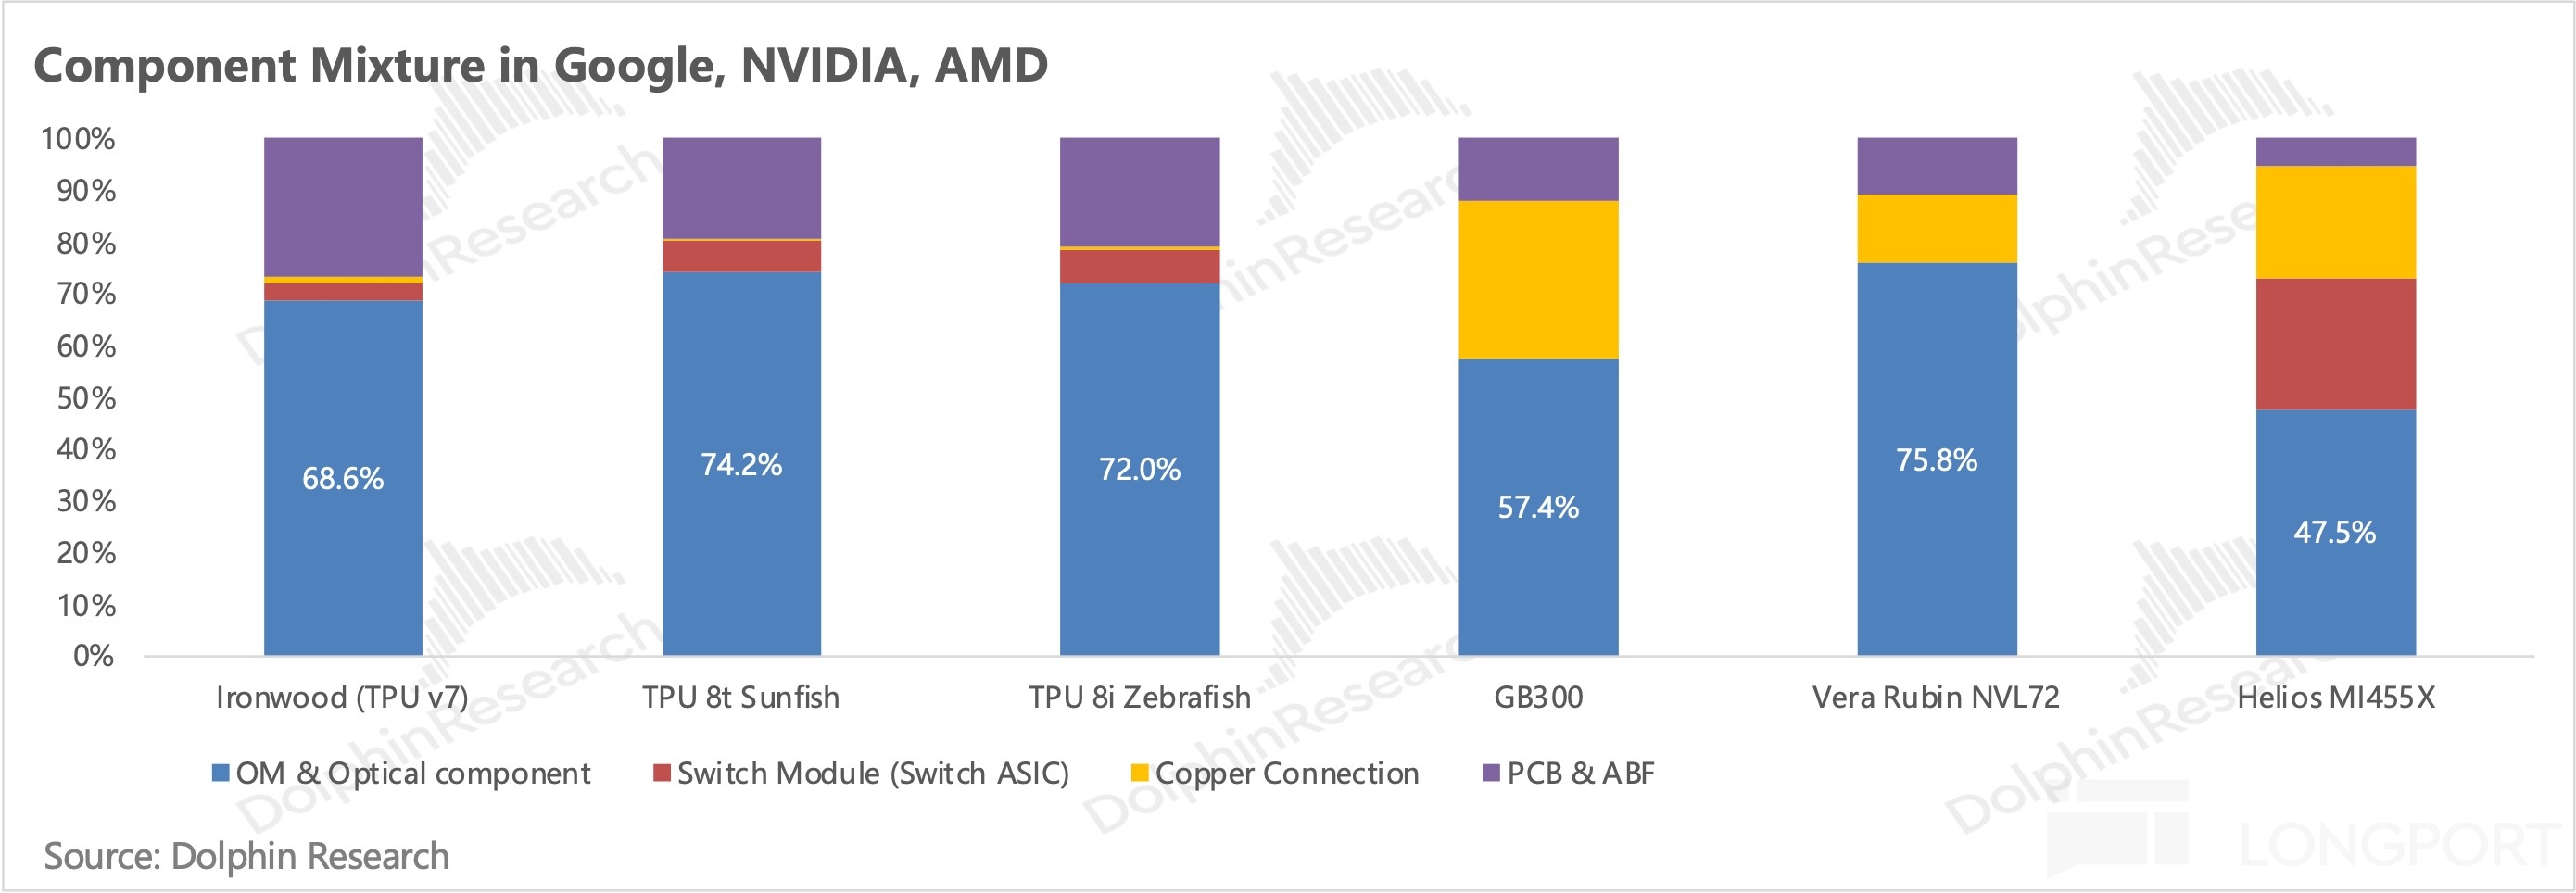
再次是交換。Trn3 生命週期內以採購標品爲主,核心供應商是 $Astera Labs.US ,但在下一代交換芯片(交換托盤內)上,可能會轉向$高通.US ,詳細點評請參見。
而在 Trn4 代際,若走 NVLink Fusion,交換芯片可能依賴 NVSwitch;若走 UALink,也可能讓位於 AMD(芯片在 Marvell 與 ALAB 共同研發中)。
最後是 PCIe Retimer。價值量不高,且存在板材對它的替代,是當前必需、但可能被優化掉的環節。
關於光連接,交換以及 PCB 的產業鏈詳細邏輯可回溯此前的深度。
3、銅連接沒機會了嗎?
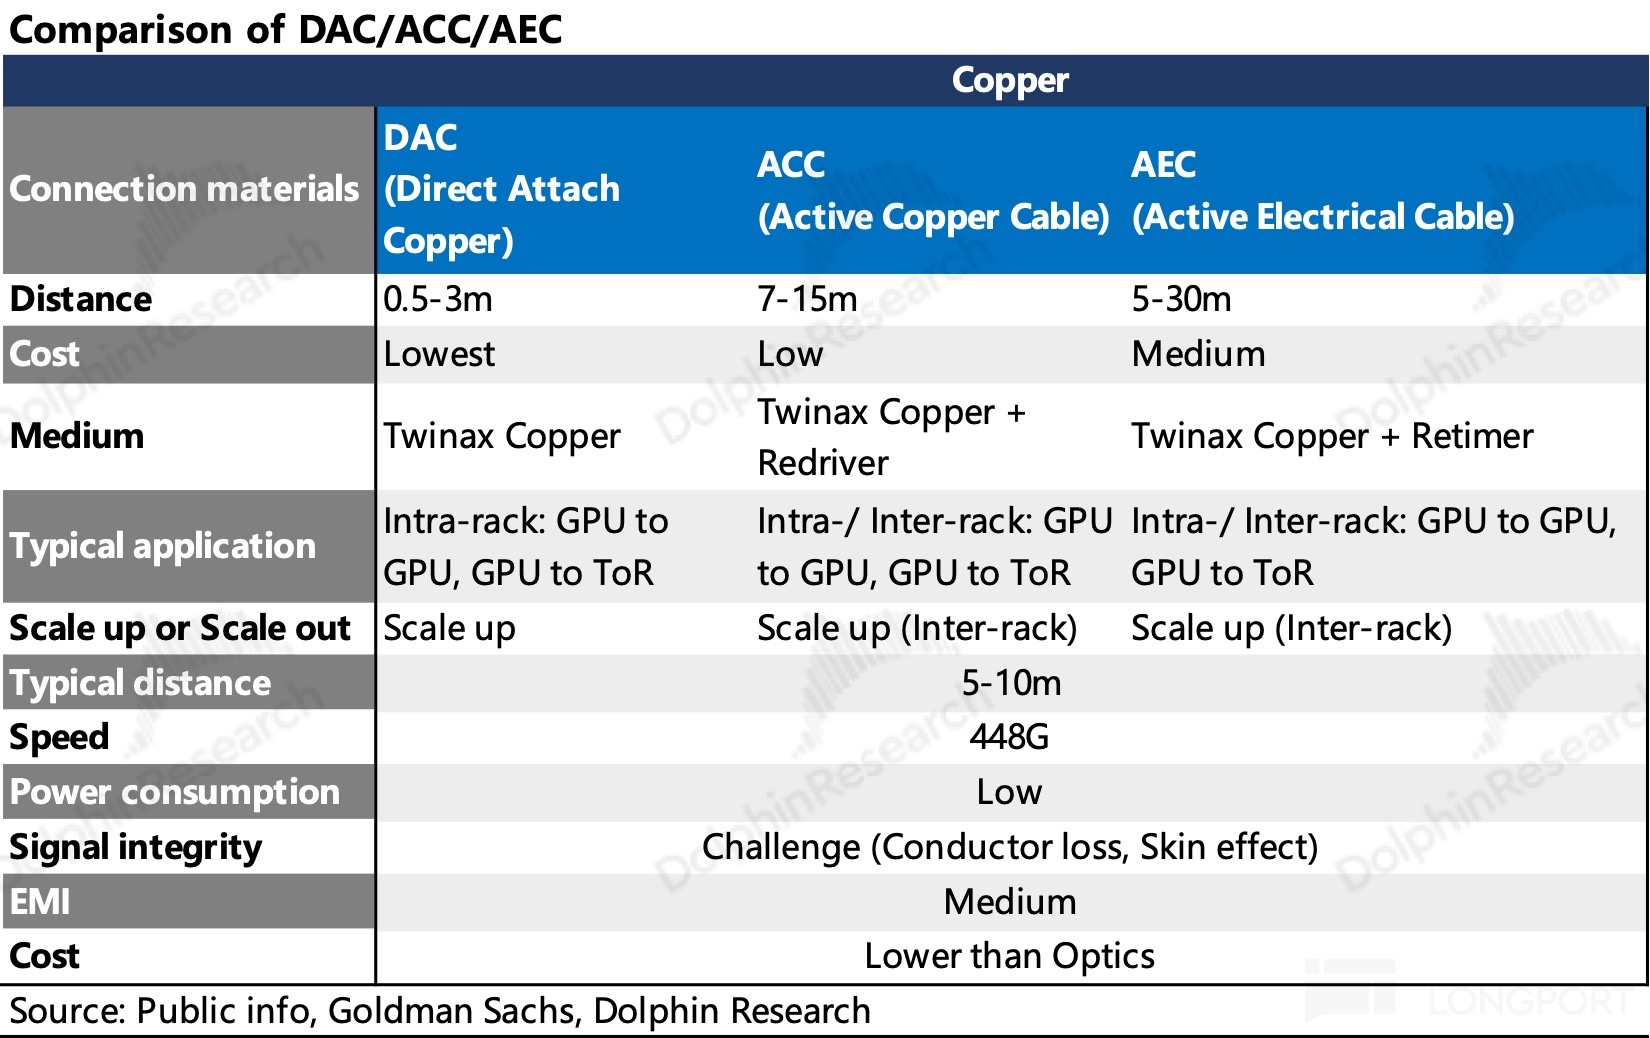
高速銅纜可分爲 DAC、ACC 和 AEC。相比 DAC,ACC 通過在線纜的接收端加入 Redriver 來延長銅纜的傳輸距離;AEC 在線纜兩端引入 Retimer 對電信號進行重定時,補償銅纜損耗的能力更強,傳輸距離進一步延長,正如表中所示,AEC 的傳輸上限長達 30m。
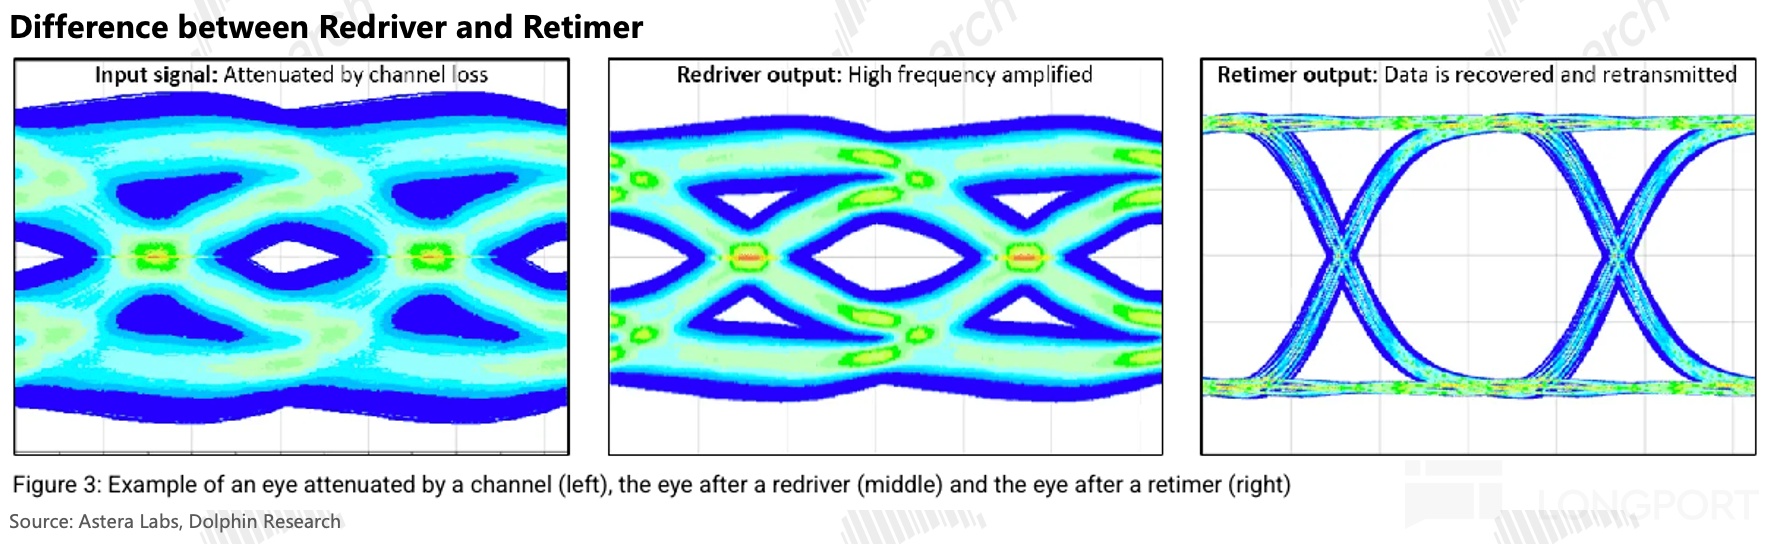
下圖的信號眼圖解釋 Redriver 和 Retimer 的區別:「眼睛」張得越開、越乾淨,接收端越容易分清 0 和 1。信號經走線衰減後,眼睛幾近閉合(左);Redriver 放大衰減的信號,眼睛重新張開,但噪聲也被一併放大(中)。
Retimer 重定時的做法是:把信號收下、重新判斷後再發一遍,輸出一份全新的乾淨信號(右)。
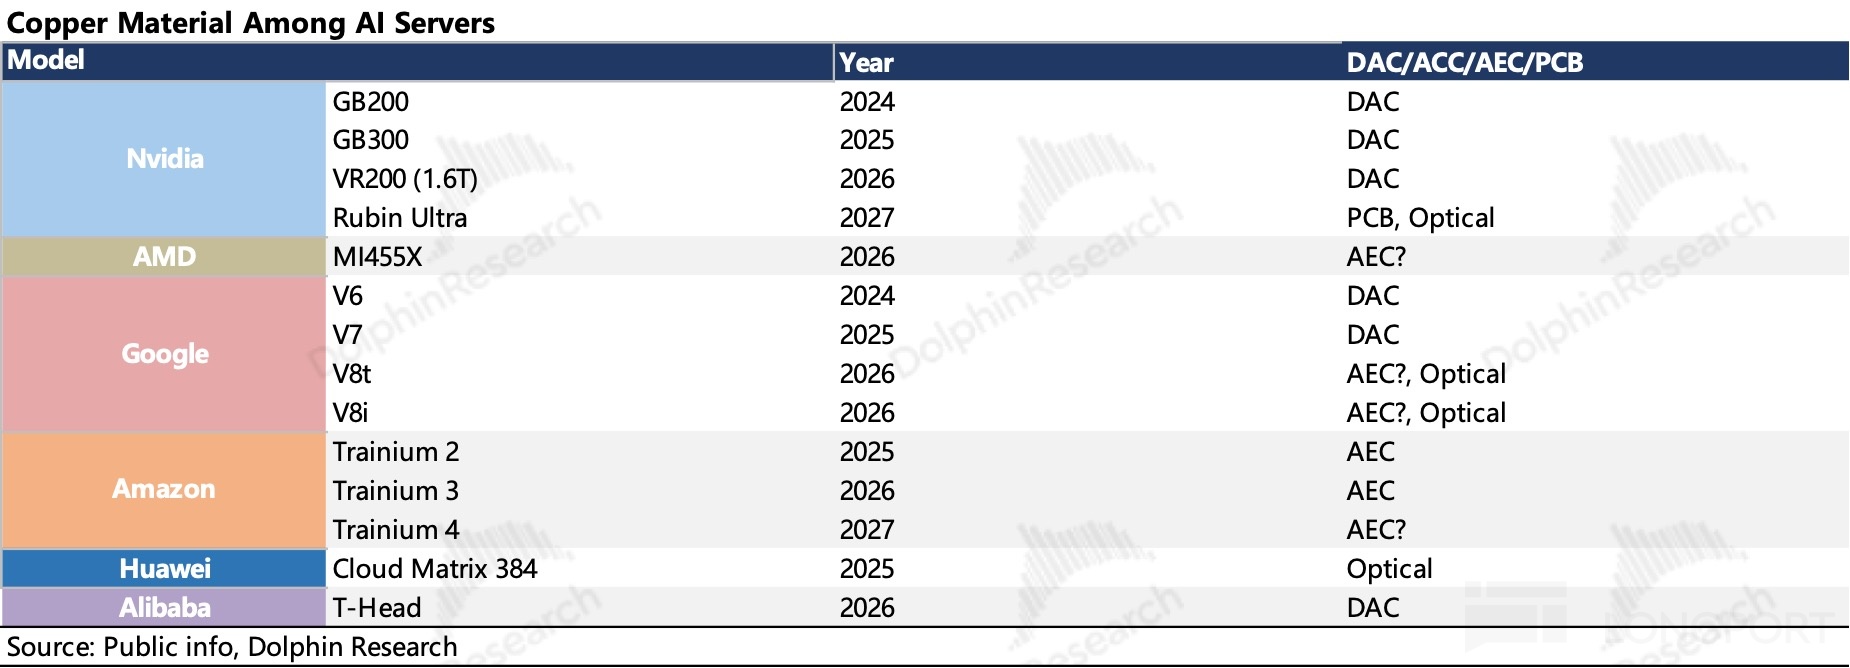
行業而言,Scale-Out 以光爲主,機櫃內部的 Scale-Up 仍以穩定、高效、便宜的 DAC 爲主,銅的基本盤仍在。但這塊基本盤也並不穩定:英偉達 Kyber 機架以 PCB 中板取代櫃內銅纜,對銅纜是利空。
海豚君認爲,銅連接的增量在 AEC,來自兩類場景:
一是 Scale-Up 域開始出櫃,但只跨一兩個相鄰機櫃,距離超出 DAC 的可達範圍,又因功耗與可靠性不值得上光,AWS 的跨櫃方案即屬此類;
二是單通道速率持續提升,DAC 能走的距離越來越短,部分原本用 DAC 的鏈路被迫升級爲 AEC。
中長期看,跨櫃距離再拉長,銅纜將鞭長莫及:Rubin Ultra NVL576 橫跨 8 個機架,已規劃引入光連接。
4、AEC 產業鏈
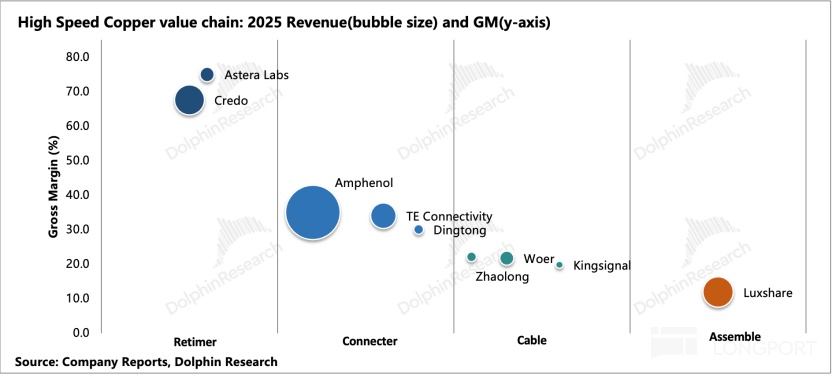
AEC 價值鏈的上游包括原材料(銅與塑料材料)、芯片/線纜/連接器製造。我們推薦關注高價值量的上游 AEC Retimer 芯片以及高速連接器環節。
1)Retimer 芯片:$Credo Tech.US 一家獨大
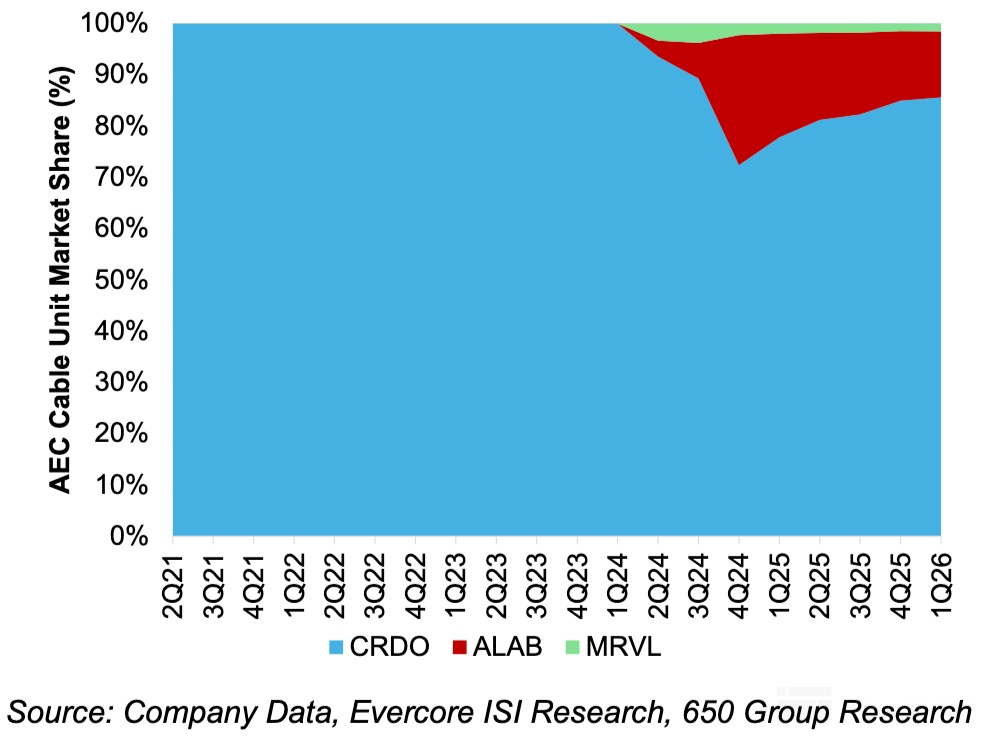
Retimer 芯片是 AEC 價值量最大的部分,而這部分利潤主要歸芯片方所有。Credo 佔據超 80% 的市場份額,其作爲 AEC 的開創者,是目前唯一能夠同時提供芯片 + 成品線纜的垂直整合廠商,先發優勢明顯。Astera Labs 的份額次之,而$邁威爾科技.US 、$博通.US 仍在擴張中。
2)高速連接器:海外巨頭守門,國產加速追趕
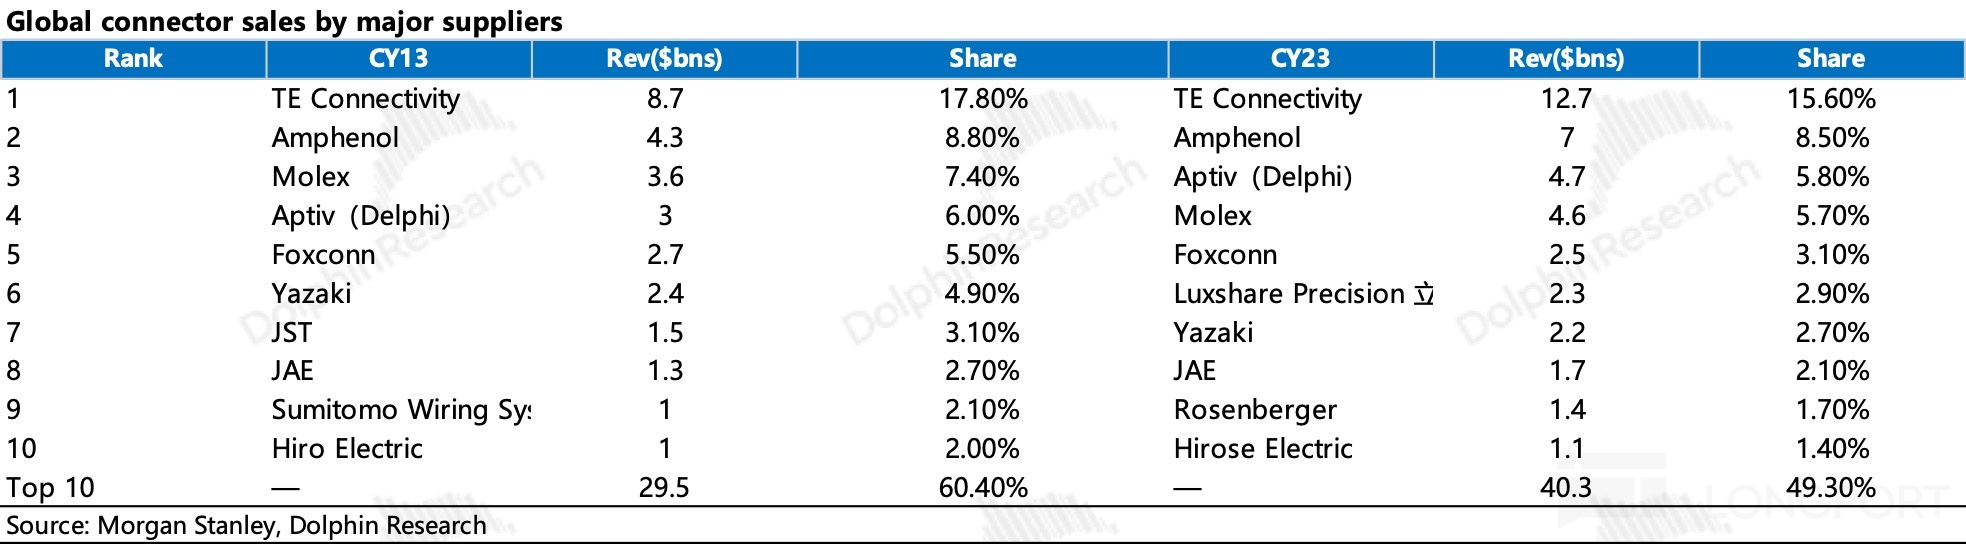
該環節對導電性與機械強度要求嚴苛,傳統連接器巨頭(如$安費諾.US 、$泰科電子.US )長期佔據第一梯隊,憑藉技術積累與芯片廠商(如 Credo)協作,形成從芯片到組裝的完整方案。而面對光進銅退的市場趨勢,行業龍頭安費諾、TE 正通過收購補充光連接的能力。
競爭格局上,連接器市場的 CR10 份額從 2013 年的 60% 下滑至 2023 年的 50%,競爭更爲充分且分散。國產廠商中$立訊精密.HK 進展較快,2023 年的市佔率已升至第六;沃爾核材、兆龍互連正在上量。
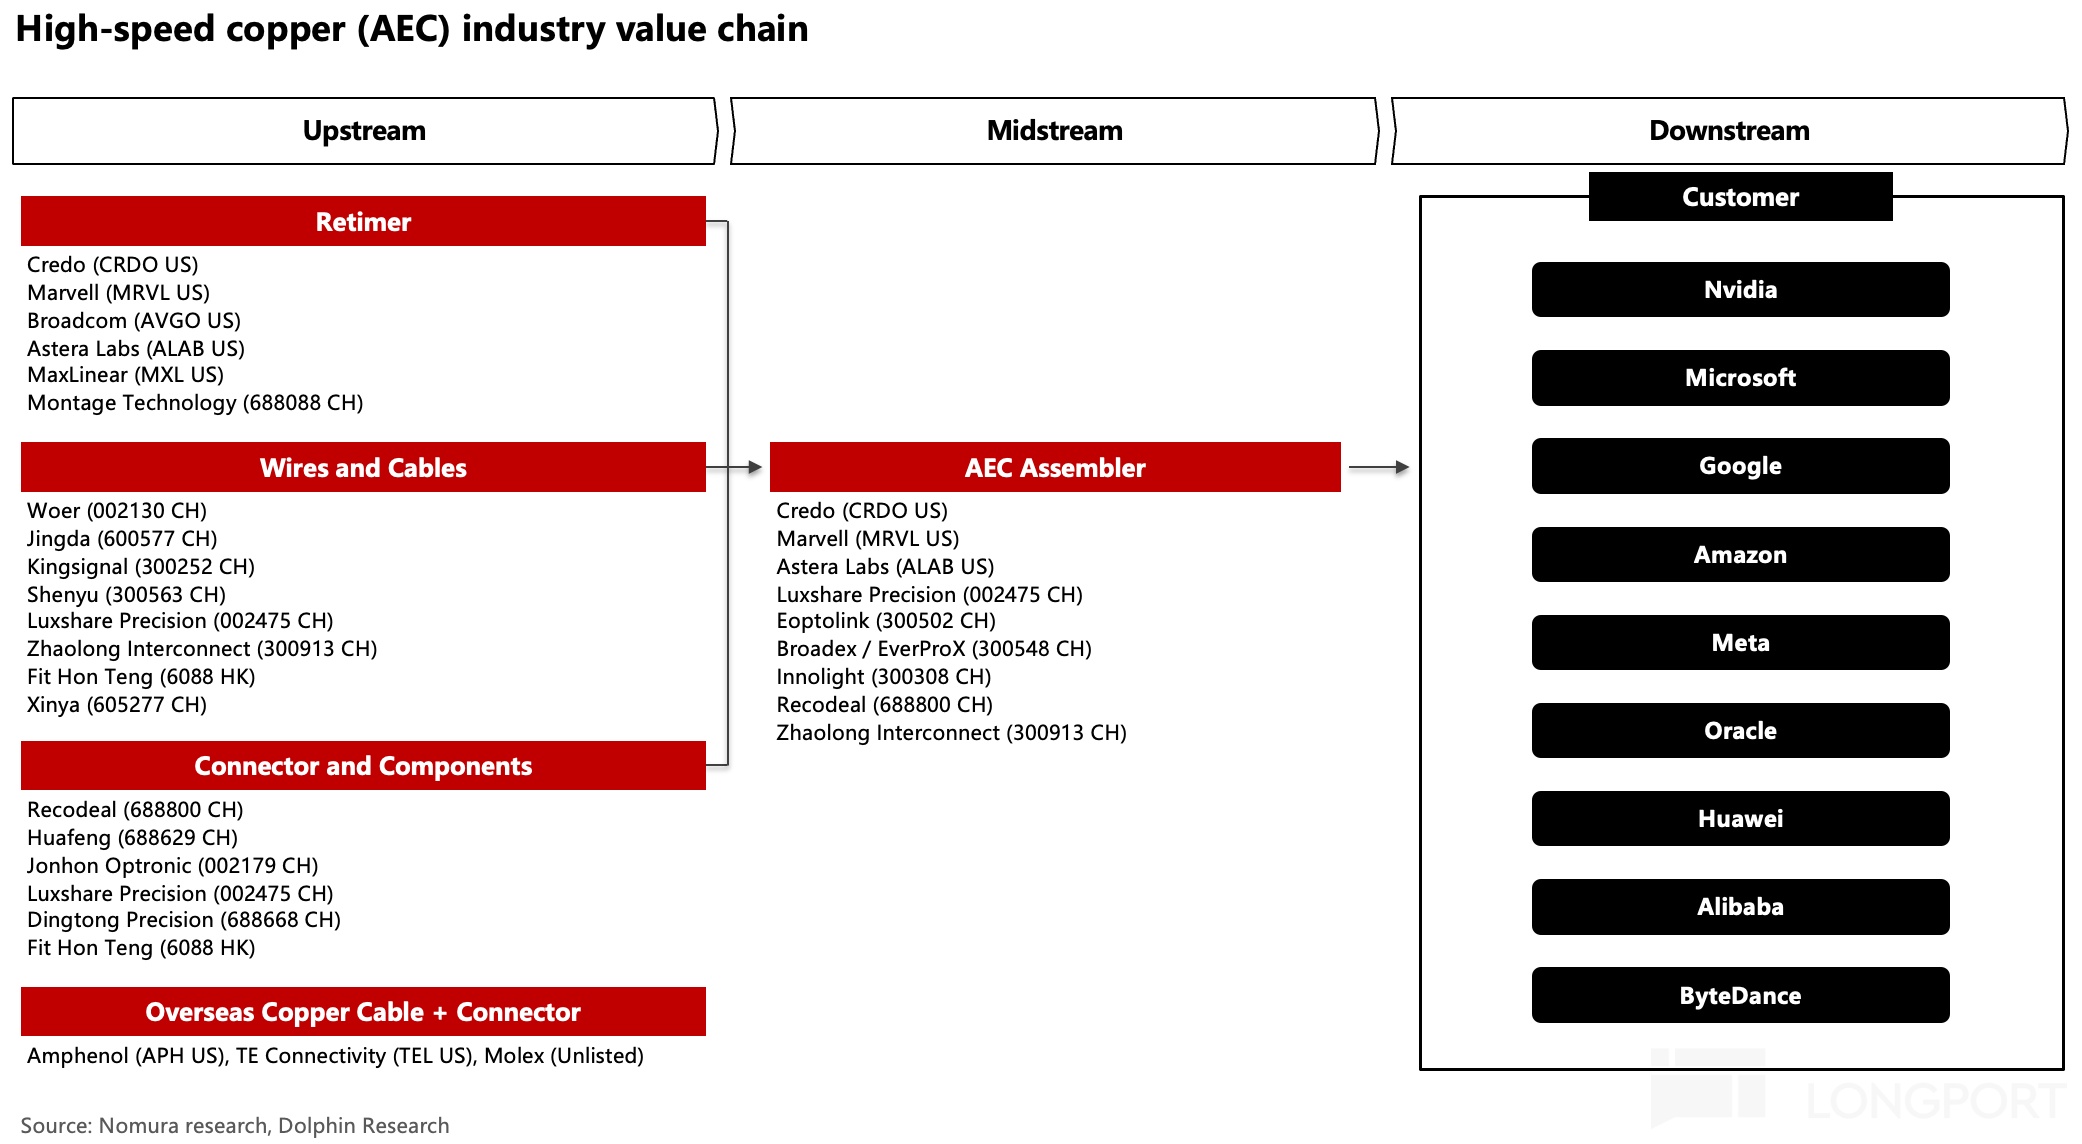
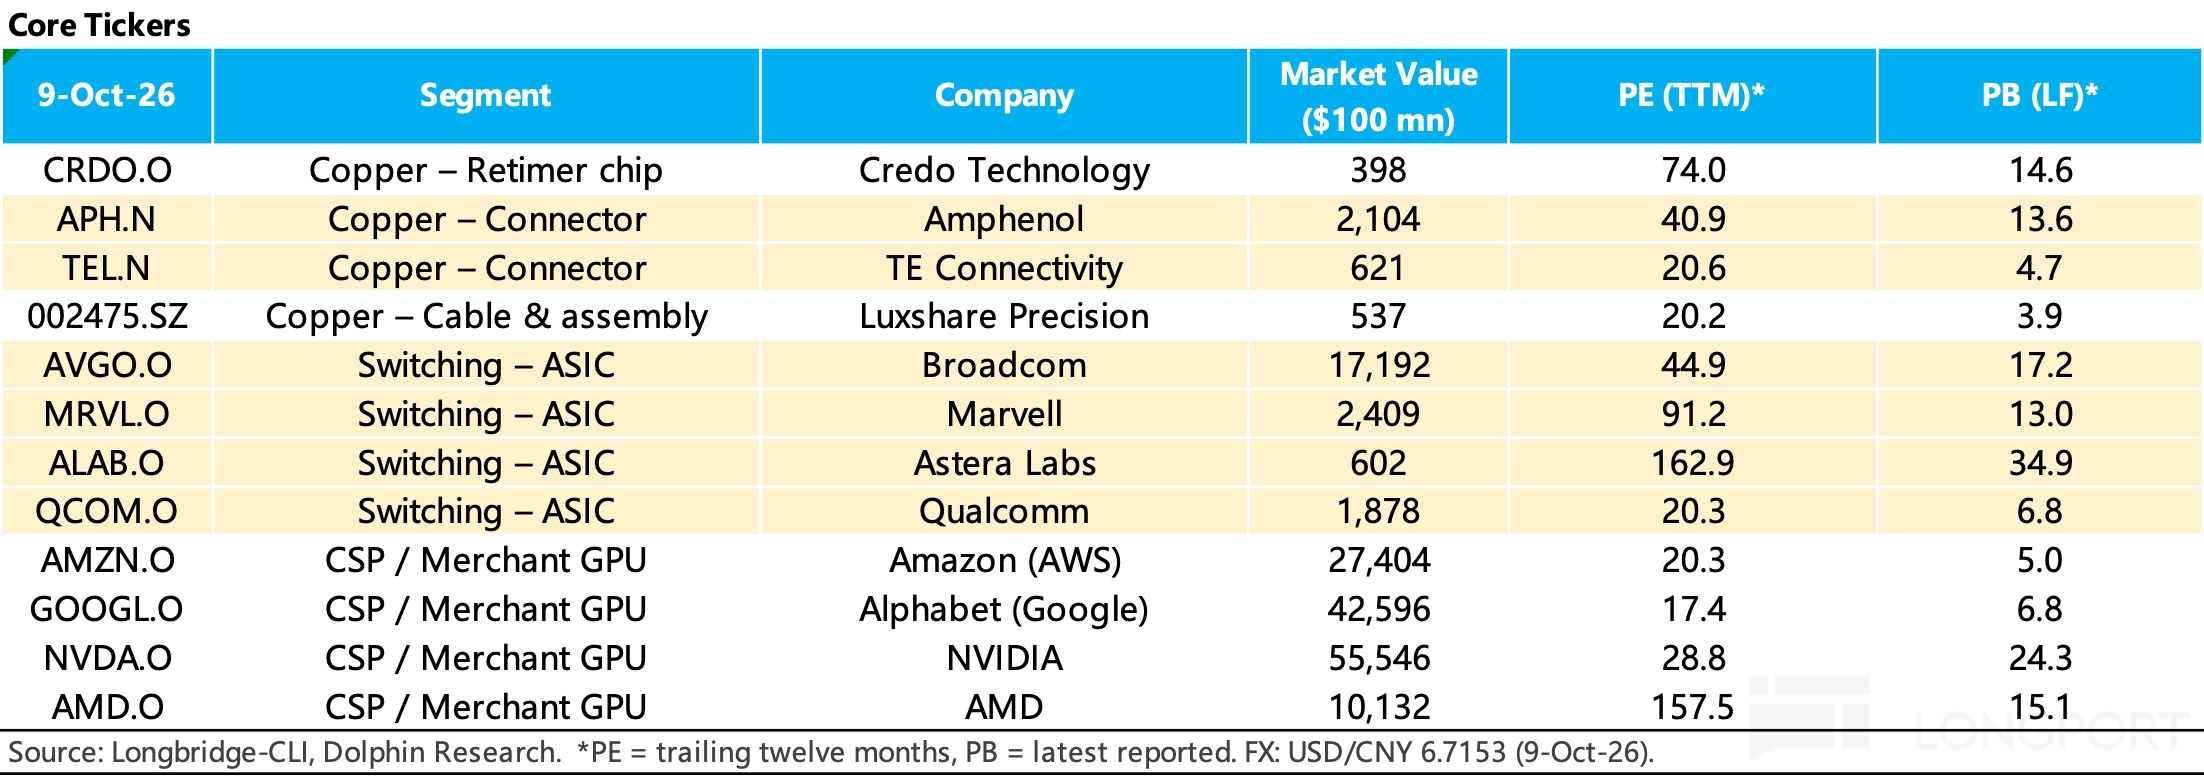
本文提及的核心標的如下(具體可點擊此處:海豚君連接股單),光模塊、CPO、PCB 等其他連接硬件的核心標的請參見此前的深度。
附錄
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
海豚君 AI DC 互聯繫列分析:
CPO 行業
《AI 超連接時代:AI 向 “光” 飛奔?》《“‘銅’ 牛夫人” 不走!CPO:真機會 or 鏡中花?》
組網架構
英偉達組網:《AI 時代 DC 互聯:單芯之上抱 “網” 作戰,真有 “中國” 機會嗎?》
DC 組網之 AMD vs 英偉達:《AMD 跟英偉達 “掰手腕”,Helios 夠格嗎?》
谷歌組網:《叫板英偉達霸權,谷歌 “光網” 憑什麼?》
AWS 組網 (上):《AWS 圖省事:套殼 PCIe,組網能打嗎?》(鏈接 xx)
個股
Lumentum(上):《從光互聯老炮到 “全能賣水人”,Lumentum 憑什麼?》
Lumentum(中):《Lumentum:產能告急,“全能賣水人” 還有什麼看家絕活?》