xAI 的 Grok 4.7 在法律代理工作中以更低的成本超越了 Anthropico 和 OpenAI 的模型。



xAI 於週一發佈了 Grok 4.7。 在法律代理基準測試中,它擊敗了 Anthropic 的 Fable 5.1 和 OpenAI 的 GPT-5.6 Sol,而每個輸入代幣的價格僅爲 Fable 的五分之一。
Anthropic 的 Output 價格爲每百萬個代幣 6 美元,而 Anthropic 的價格爲 50 美元。
xAI發佈的數據顯示,Grok 4.7在Harvey Legal Agent基準測試中得分19.6%,Fable 5.1在同一測試中獲得6.7%,而GPT-5.6 Sol僅獲得2.5%。.
這使得 Grok 4.7 的得分約爲 Anthropic 的三倍,接近 Sol 的八倍。Cryptopolitan Cryptopolitan 報道稱 ,Grok 4.6 的得分已經達到 15.8%,領先於這兩款加密貨幣。
在法律領域,Grok 4.7 的表現遠超其他競爭對手,這在少數幾個領域中實屬罕見。它在 EEBench 電氣工程測試中也輕鬆通過了 Fable 5.1 的測試,並在 DeepSWE 編碼測試中略勝一籌。.
Grok 4.7 的定價爲每百萬個輸入代幣 2 美元,每百萬個輸出代幣 6 美元,與 Grok 4.6 相同。該輸入價格是 GPT-5.6 Sol 的 4 美元的一半,是 Fable 5.1 的 10 美元的五分之一。.
輸出價格爲 6 美元,而 Sol 爲 20 美元,Fable 爲 50 美元,約爲 Anthropic 的八分之一。.
xAI 將 CursorBench 4.0 得分與完成任務的平均成本繪製成圖表,並聲稱該模型處於性價比的前沿。Grok 4.7 在該圖表中得分約爲 46%,每項任務成本約爲 6 美元,而 Claude Opus 5 要達到類似的結果,成本幾乎是其兩倍。.
Fable 5.1 在高預算下表現更佳,在每項任務約 17 美元的情況下,效率最高可達 51.8%。馬斯克在 X 大會上表示,此次發佈是“智能、速度和低成本的tron結合”。.
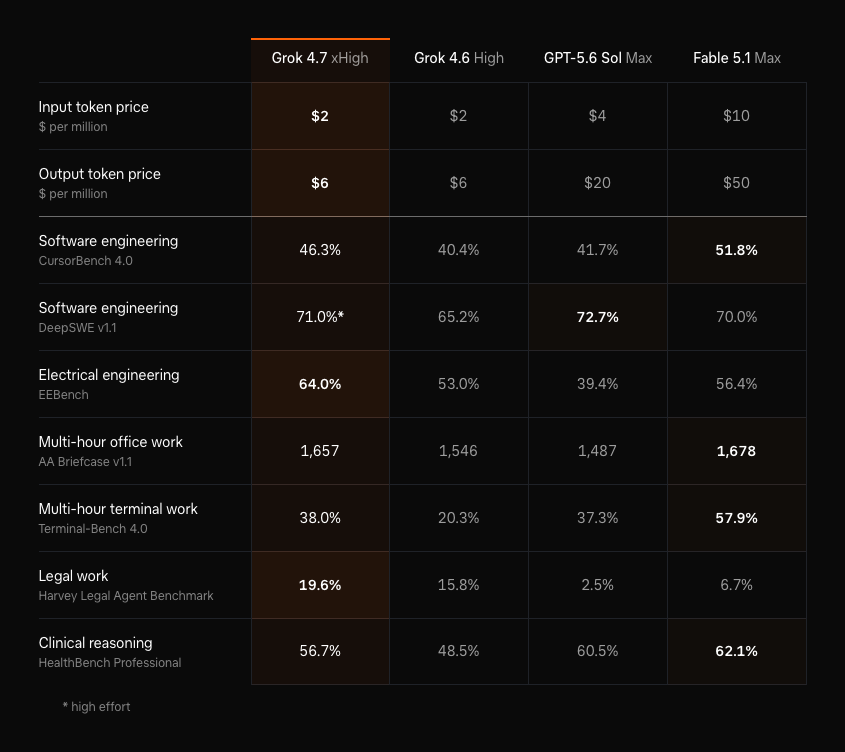
Terminal-Bench 4.0 顯示 Anthropic 以 57.9% 比 38.0% 的優勢領先。
在 GDPval 和 AA Briefcase 辦公任務測試中,Grok 4.7 均位列 Fable 5.1 之後,排名第二。Anthropic 的模型在更長時間的編碼和終端基準測試中保持着明顯的領先優勢。.
差距最大的是 Terminal-Bench 4.0,Fable 5.1 的得分爲 57.9%,而 Grok 4.7 的得分爲 38.0%,相差約 20 分。.
Fable 在 CursorBench 和 HealthBench Professional 臨牀推理測試中也領先,GPT-5.6 Sol 也擊敗了 Grok。.
Grok 4.7 在 GDPval 上的 Elo 得分爲 1,695,該評分系統對模型在律師、護士和金融分析師完成的任務上的表現進行評分,高於 Grok 4.6 的 1,605。這低於 Fable 5.1 的 1,735 分,但高於 OpenAI 最新推出的 GPT-6 Astra 在同一圖表上的 1,542 分。.
Grok 4.7 在七項基準測試中的五項都優於 GPT-5.6 Sol,僅在 DeepSWE 和臨牀測試中落後。.
Grok 4.7 運行在 2.1 萬億個參數上,比 Grok 4.6 的 1.5 萬億個參數多了 40%。xAI 還加入了 SpaceX 的補充訓練數據,包括 Starlink 衛星遙測數據和製造記錄。.
該公司表示,與 Grok 4.6 相比,該模型更有可能花更多時間解決棘手的問題,並仔細檢查自己的答案。.
該 模型 已在 Grok 應用、Cursor、Grok Build 和 xAI API 上發佈,無需等待。
本文所有數據均來自xAI自身的測試。xAI主要使用的測試工具CursorBench由Cursor公司開發,SpaceX已於上月完成對Cursor的收購。.
xAI 與 GPT-5.6 Sol 進行了基準測試,而 OpenAI 的較新 GPT-6 Astra 僅出現在 GDPval、AA Briefcase 和 EEBench 圖表中。.
不要只是閱讀加密貨幣新聞,要理解它。訂閱我們的新聞簡報, 完全免費。