


의료 AI의 정확도 향상 속도가 환자 치료 결과 개선에 대한 증거를 앞지르고 있습니다



2026년에 발표된 수많은 연구들은 의료 AI 분야에서 여전히 존재하는 격차를 보여주고 있습니다. 이러한 시스템들은 의사의 선택에 영향을 미치고 인상적인 진단 결과를 도출할 수 있지만, 환자의 실제 건강 증진을 입증하지는 못하고 있습니다.
이는 이러한 시스템을 구매하는 병원, 그 유용성을 입증하려는 기업, 그리고 AI가 의료 현장에 도입될 때 어떤 증거를 고려해야 할지 결정하는 당국 모두에게 중요합니다.
규제 당국이 면밀히 조사하기 시작한 입증 문제
인공지능의 놀라운 성능과 환자에게 입증된 효능 사이의 격차가 더 이상 간과할 수 없을 정도로 커지고 있는 것 같습니다. 파이낸셜 타임스는 이러한 상황을 다음과 같은 제목으로 요약했습니다.
"의료 AI는 증명 문제를 안고 있습니다."
이 문제는 이제 학술적 논의의 영역을 넘어섰습니다. 미국 식품의약국(FDA)은 인공지능 기반 의료기기의 사용 전후 평가 방법을 모색하면서 동일한 질문들을 제기하고 있습니다. 8월 18일에 발표되어 10월 19일까지 대중의 의견 수렴을 위해 공개된 토론 문서는위험 평가, 시판 전 평가 및 시판 후 모니터링과 같은 문제들을 다루고 있습니다.
FDA는 이 문서가 순전히 논의를 위한 문서일 뿐이며, 지침 초안이나 정책 변경 제안, 또는 향후 규제에 대한 기대치를 나타내는 것이 아님을 분명히 밝히고 있습니다.
이전에 FDA가 실제 성능에 대해 진행한 조사에서는 모델 드리프트 문제와 정적 지표 사용의 한계에 대한 논의가 제기되었습니다. 이는 더 이상 무시할 수 없는 더 큰 질문을 던집니다. 인공지능 솔루션이 연구실 단계를 벗어난 후에는 안전성과 효율성을 어떻게 측정해야 할까요?
케냐에서는 AI 지원이 치료 실패율을 낮추지 못했습니다
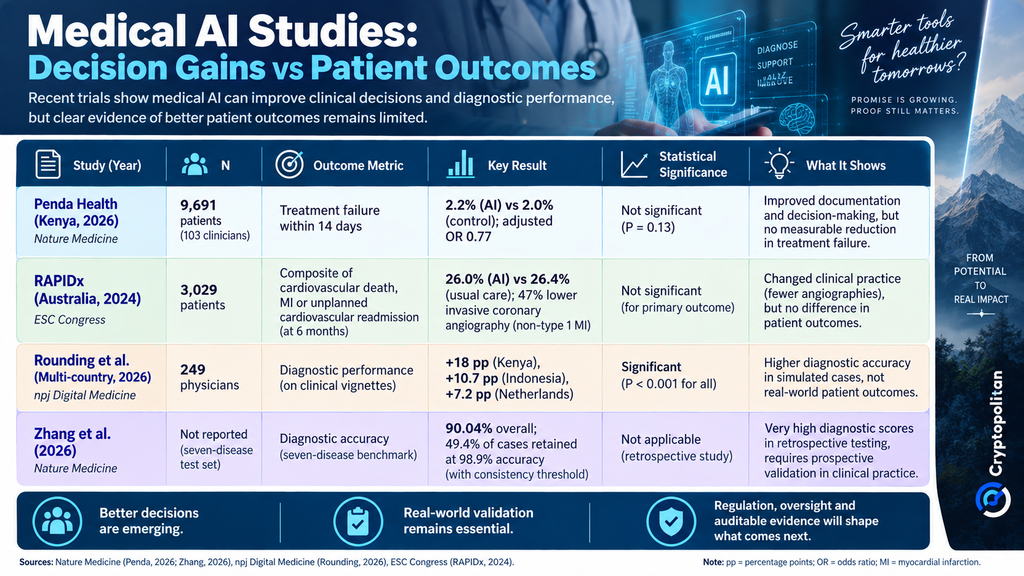
6월 26일 네이처 메디신(Nature Medicine) 저널에 발표된 한 연구에서, 나이로비와 키암부 카운티에 있는 펜다 헬스(Penda Health) 산하 16개 시설의 임상 담당자 103명이 대규모 언어 모델(LLM)을 활용한 의사결정 방식과 그렇지 않은 방식을 비교하여 환자들을 치료했습니다. 등록된 환자 9,691명 중 9,347명이 주요 분석 대상에 포함되었습니다.
14일 후 치료 실패율은 AI 그룹에서 2.2%, 대조군에서 2%였으며, 조정 오즈비는 0.77이었지만 통계적으로 유의미한 차이는 없었습니다(P=0.13). 이번 치료와 관련된 심각한 이상 반응은 발생하지 않았습니다.
AI를 사용한 그룹은 문서화가 더 잘 되어 있었고 진단 및 치료 계획도 더 적절했습니다. 하지만 이 결과의 의미는 프로세스 개선에도 불구하고 환자의 치료 결과가 향상되지 않았다는 점에 있습니다.
이러한 추세는 2024년에 진행된 RAPIDx AI 임상시험 과 유사합니다. 3,029명의 환자를 대상으로 한 1차 분석에서 심혈관계 사망, 심근경색 또는 계획되지 않은 심혈관계 재입원을 포함하는 6개월 복합 결과 발생률은 AI를 사용한 경우 26%, 표준 치료를 사용한 경우 26.4%였습니다. 그러나 1형 심근경색 이외의 환자군 내에서는 AI 지원 치료를 받은 경우 침습적 관상동맥 조영술 시행 빈도가 47% 더 낮았습니다.
점수는 계속 오르고 있지만, 실제적인 증거는 뒤처지고 있다.
여러 국가에서 진행된 무작위 대조 시험에서 GPT-4o는 케냐에서 249명의 의사들의 임상 사례 수행 능력을 18%, 인도네시아에서 10.7%, 네덜란드에서 7.2% 향상시킨 것으로 나타났습니다(P < 0.05).
하지만 이는 실제 상황이 아닌 모의 사례였으며, 대조군 참가자들은 인터넷이나 임상 프로토콜을 사용할 수 없었고, 부작용에 대한 평가도 이루어지지 않았습니다. 이 연구는 통제된 환경에서 AI가 성능을 향상시킨다는 것을 확인시켜 주지만, 환자의 치료 결과에 대해서는 아무런 정보를 제공하지 않습니다.
Li Zhang, Jakob Nikolas Kather 및 동료 연구진이 Nature Medicine에 발표한 또 다른 연구 결과에 따르면, 7가지 질병을 기준. 이 연구에서는 일관성 임계값을 도입하여 현장 진단 에이전트가 전체 사례의 49.4%를 98.9%의 정확도로 적중시켰으며, 나머지 사례는 전문가의 검토를 거쳐야 했습니다. 그러나 연구진은 실제 임상 환경에서의 추가 검증이 필요하다고 지적했습니다.
사정을 잘 아는 의사가 왜 이 문제를 해결하지 못하는 걸까요?
조이 쉬, 저스틴 코, 조셉 크베다르가 작성한 증거 지도 에 따르면 , 에이전트형 AI는 이제 행정 업무뿐 아니라 진단, 관리 및 기타 의료 업무에서도 사용되고 있으며, 따라서 이러한 시스템을 관리하고 감사할 수 있는 능력의 중요성이 점점 더 커지고 있습니다.
NPJ 디지털 의학 논평의 또 다른 부분은 임상의가 단순히 존재한다는 것만으로는 적절한 감독과 관리가 보장되지 않는다고 지적합니다. 자동화 편향은 사람들이 결함 있는 권고를 더 쉽게 받아들이도록 만들 수 있으며, 효과적인 감독에는 시스템에 이의를 제기하고 개입할 수 있는 충분한 지식, 시간 및 권한이 필요합니다.
저자들은 그러한 조건이 충족되지 않으면 인간의 감독은 단순한 책임 회피 수단에 불과하게 될 것이라고 경고합니다
임상의들이 오류를 잡아내야 한다는 책임이 그들에게 전가될 수 있는데, 그들은 그러한 오류를 감지하거나 수정하기에 적절한 위치에 있지 않다… 이는 도덕적 붕괴 지대가 될 수 있다.
이는 논쟁의 초점을 인간이 기술적으로 "시스템에 관여"하는지 여부에서, 필요할 때 그 사람이 실제로 시스템에 의문을 제기하고, 시스템을 변경하고, 중단시킬 수 있는 능력을 갖추고 있는지 여부로 옮깁니다.
신중함의 배경에는 상업적 이해관계가 있다
MarketsandMarkets는 의료 AI 시장이 2026년 366억 7천만 달러에서 2031년 1,947억 9천만 달러로 성장할 것으로 전망하며, 이는 연평균 39.7%의 복합 성장률에 해당합니다. 이러한 성장이 현실화된다면, 병원들은 AI 도입을 더욱 적극적으로 고려하게 될 것이지만, AI와 환자 치료 결과 간의 연관성에 대한 근거는 여전히 불확실한 상태일 것입니다.
이는 경쟁 압력을 마케팅하기는 더 어렵지만 공급자에게는 더 가치 있는 영역, 즉 실제 감사가 가능한 사전 검증, 현지 성과 모니터링 및 감독으로 전환시킬 수 있습니다.
암호화폐 분야의 최고 전문가들이 이미 저희 뉴스레터를 구독하고 있습니다. 함께하고 싶으신가요? 지금 바로 참여하세요.
추천 기사










코멘트 (0)
$ 버튼을 클릭하고, 종목 코드를 입력한 후 주식, ETF 또는 기타 티커를 연결합니다.