


AI 入口大戰 2.0:騰訊、阿里、字節,誰是 AI 辦公的隱形冠軍?


$騰訊控股(00700.HK) $阿里巴巴-W(09988.HK)
過去一年,AI 行業最確定的一筆錢來自寫代碼,程序員成了第一批心甘情願爲 AI 掏錢的白領。
但核心編碼場景滲透率已70%左右,市場開始期待下一個場景在哪裏。程序員之外,全球還有約10億知識工作者。
那麼AI辦公(也有人叫 Co-work、工作 Agent)能不能接住 Coding 的接力棒,成爲下一個滲透率大幅提升、商業模式真正跑通的場景?
本文海豚君主要討論AI辦公,圍繞四點進行分析:
1、入口爲什麼從聊天框轉向 Agent?
2、Agent 靠什麼實現?技術能不能成爲壁壘?
3、個人 Agent 和工作 Agent 誰先落地?
4、以中國市場爲例,如何看核心玩家各自贏面?
以下詳細分析:
一、AI入口之變:從“陪你聊”到“替你幹活”
AI入口爭奪一直伴隨AI的底層技術發展,但由於算力成本不像傳統互聯網時代那邊邊際用戶的服務成本幾乎爲零,以往互聯網時代巨頭先補貼再養用戶習慣,再收割的“純流量打法”,至少在當下已經不再適用。
相反,迫於成本壓力,掌握技術、生態、流量優勢的平臺巨頭們開始算經濟賬。C端堪比“知識付費”水平的低付費率,和短到很難釋放足夠廣告庫存的日均時長,都讓最先滲透普及的AI Chatbot商業化之路走得異常艱難。
相比而言,以任務完成爲導向的Agent出來後,企業端付費力反而被激發,尤其是科技公司和IT從業者。Stack Overflow在2026年4月和10月的抽樣調查顯示,Agent使用率達到了59%,每天使用比例也升至37%;而使用AI工具的開發者裏面,66%在用Coding Agent,其中73%的人每天使用。
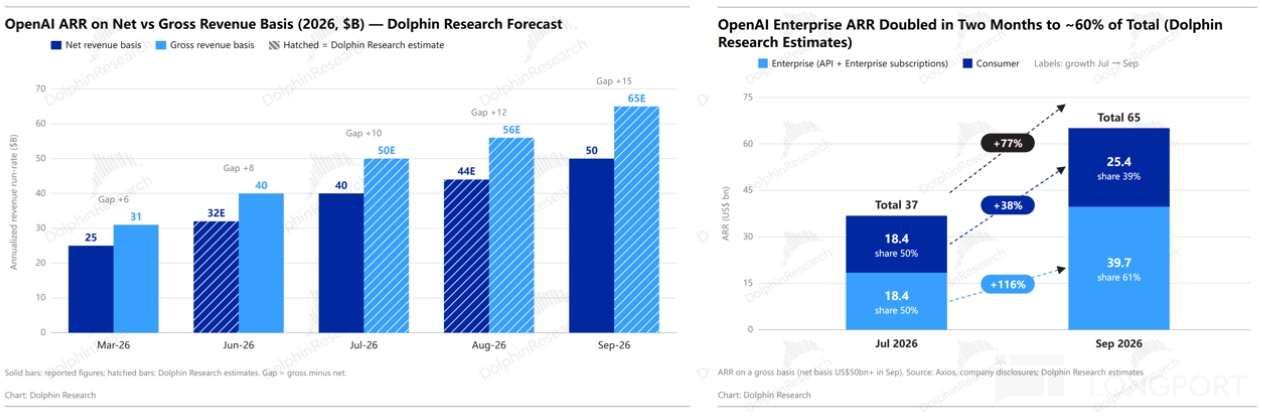
今年7月,OpenAI的B端付費規模(API、Enterprise訂閱)已經超過C端(4月佔比還是40%),年化200億+美元,到9月底增長翻倍,按照650億的整體ARR規模(毛口徑,淨口徑爲500億+),B端收入佔比超60%。
與此同時的C端付費,倒算下來9月底規模約莫250億美元的ARR,相比7月只增長了不到40%。
廣告變現上,年初OpenAI信心十足進軍市場,一邊招兵買馬,一邊攜手多個第三方生態。
但隨着轉化率持續不佳,CPM報價一降再降,從灰測期間的60美元/千次曝光,降至15-25美元區間,看齊成熟數字廣告平臺報價。與此同時自助投放平臺的最低消費門檻,也從5萬美元直接抹成零門檻。
目前最新的進展是,8月底ARR爲10億美元,但這是已經覆蓋了數萬家廣告主、40多個國家地區的成績。
爲什麼Chatbot付費變現這麼困難?
海豚君認爲,問題不在於AI沒用,而在於Chatbot這種交互形式,天然讓用戶算不清賬、認不清AI價值。進一步細分來看,AI的價值包含兩方面,一個是可驗證有效性,一個是可衡量帶來的收入擴張或成本優化。
但Chatbot交付的是“建議”,不是“結果”。它省了多少時間、省了多少錢,大多數場景是算不清的(無法量化價值),。因此結果好壞,只能“感覺”(無法自我驗證),用戶要確認效果,還得自己再走一遍流程。
當驗收成本升高,用戶對AI的信任度就無法穩定建立,因此使用場景就愈發停留在淺層的問答,而這裏面所產生的無反饋、簡單基礎的用戶數據,對大模型本身的後訓練迭代作用不大,平臺需要額外購買/標註高質量數據+驗證環境。若要提升模型,還得花更高的成本從用戶日常問答的數據中洗出高質量內容。
與此同時,越是不信任、只交互簡單任務,越是無法沉澱下有價值的數據資產。這導致用戶的切換成本也很低,一旦有更高性價比的Chatbot,可以絲滑切換。所以Chatbot能把“用戶數”做到極致,卻很難同步推高體現用戶高粘性、忠誠度的“付費率”。
Coding爲什麼能第一個跑出來?
相比於聊天框的內容輸出,Agent是以完成任務爲目標,這與企業的普遍訴求一致。而在AI價值公式中,對可驗證+可衡量的兩個關鍵因子也都能落地:
Coding是知識範圍固定、對錯可驗證的場景(能否走通可自動驗證);與此同時帶來的增量價值也很好衡量——可以直接對應IT人才較高的薪資。
這種能夠被用戶快速驗收、同時單個任務的經濟價值又很高的場景,除了Coding,還有財務對賬、法務合規審查、數據分析、金融投資、銷售策略等場景。
更大的市場來自上述場景的合併和延伸——成爲企業背後的統一辦公平臺。在深入企業業務流程,提供傳統辦公軟件功能的同時,能夠通過AI幫助企業客戶實現更多業務增長,而非只停留在“員工降本”上。
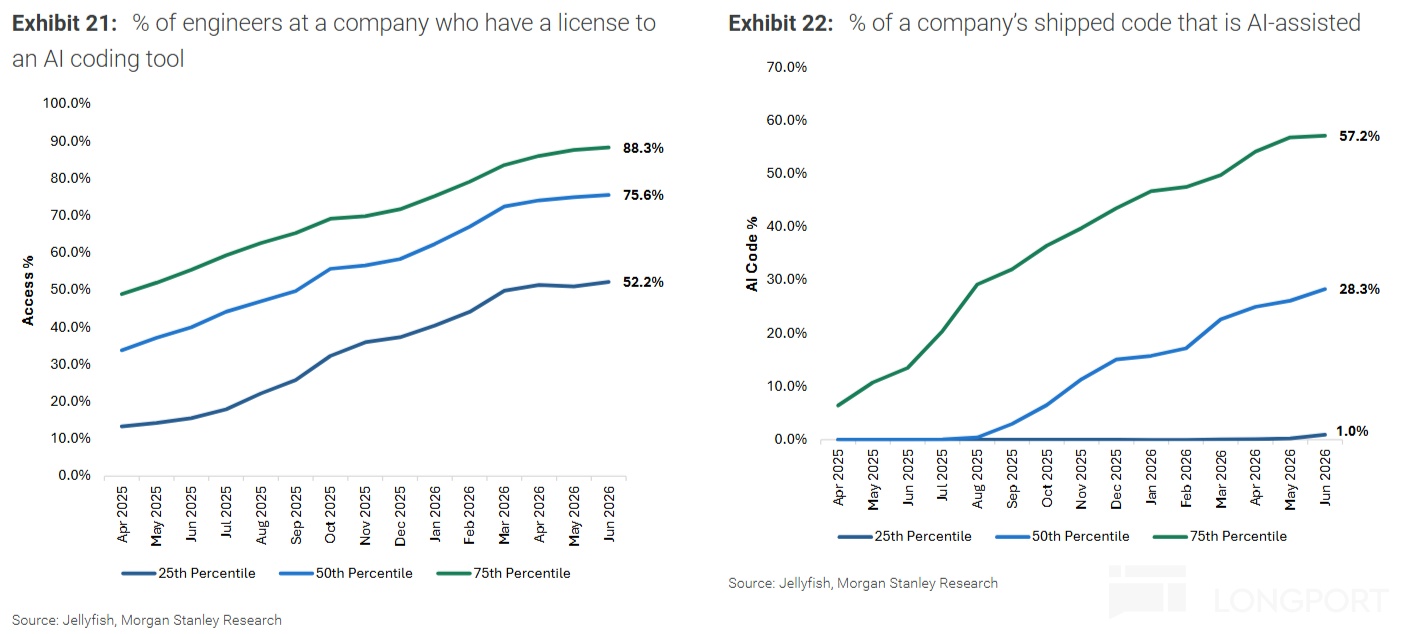
不過統一的辦公平臺場景不是Coding場景的簡單複製,其發展道路並非像Coding這麼順(一年時間就將IT人員中的AI Coding採用率拉高到了70%以上,AI輔助代碼佔比近30%)。
關鍵在於三個影響因素:
(1)驗收標準更模糊、複雜,有些工作成果不好自動驗收,而需要真人主觀判斷質量高低;
(2)任務鏈更長,卡在任何小環節都可能造成整條任務的停滯,比如月末對賬需要同時接觸網銀、稅務系統以及企業ERP系統,所以單看細分環節的容錯率會更低;
(3)出於網絡安全考慮,企業肯定是更希望私有化部署,這個過程則需要AI辦公平臺派出FDE團隊入駐企業客戶。
因此,企業決定是否替換/升級成AI辦公平臺,這個採購決策鏈要比AI Coding明顯更長,自然發展進度沒有Coding那麼順暢。
二、Agent競爭,技術會是核心壁壘嗎?
1. Agent=LLM+Harness
要看Agent是否具備持續性的技術壁壘紅利,我們先來看看Agent的運作原理。
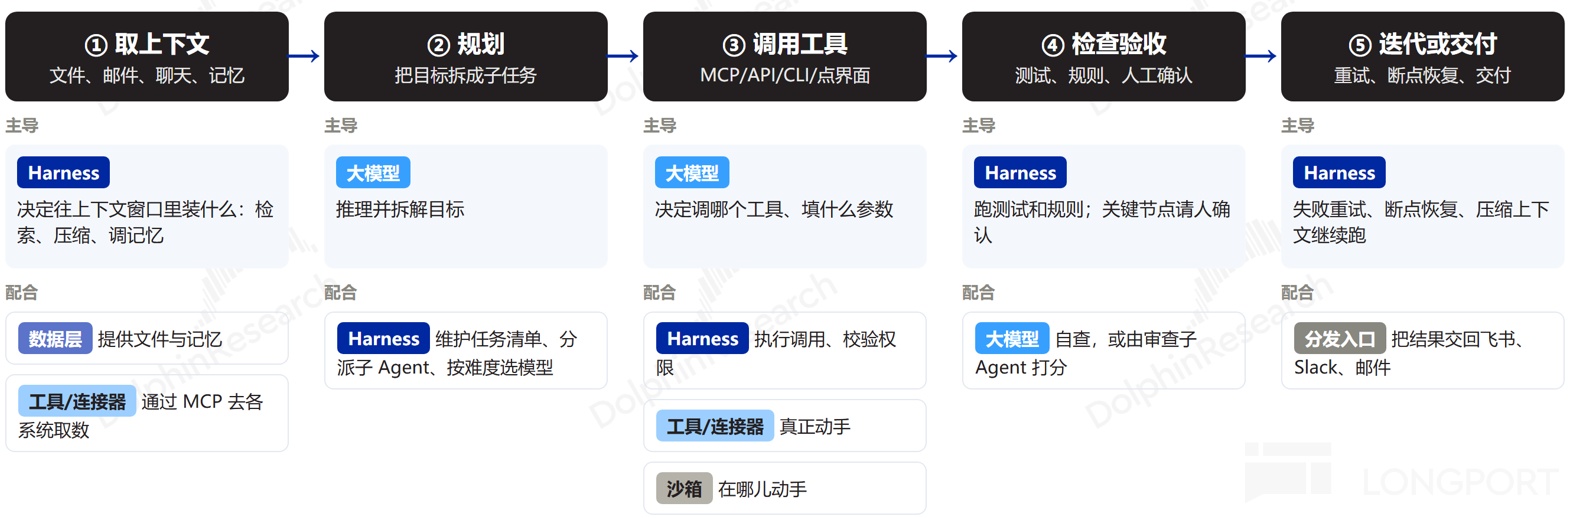
Agent要完成一個工作,主要包含5個關鍵步驟,每個步驟又涉及到不同層的軟件工具。其中兩個核心技術分別是大模型層和Harness層,總體而言,大模型負責思考後做出決策/提出要求;Harness負責穩定安全的執行、驗收。
2. 真正的壁壘在“數據”
從Agent的運作原理可以看出,一個Agent要能夠穩定執行並完成交付工作,需要大模型做準確判斷,同時還需要一個靠譜的Harness來穩定執行。
那麼領先的Agent,它的技術壁壘來源於大模型還是Harness?
(1)Harness本質是一個技術套殼
首先Harness的設計思路和底層工程代碼都非常成熟且通用,屬於運行基礎設施——日誌、權限、沙箱、存檔、界面等。
其次Harness外接應用生態的連接協議MCP、Skills等,也成爲了開放標準。OpenAI 把 Codex Harness 直接開源,Dots 就跑在它上面;開源的 OpenClaw 也成了微軟 Autopilot 和 Meta Muse 的靈感來源。
所以Harness本身並不構成技術壁壘,與此同時,模型還在喫掉Harness的功能。也就是很多原本靠Harness補的能力,也正在被嘗試訓練進模型。
a.Agent調度執行納入大模型(適用並行任務)
典型的例子就是Kimi,自K2.5首次推出Agent Swarm,讓模型自己決定拆任務、分派子Agent開始,K2.6、K3就延續這條設計思路,把越來越多的Agent協作直接訓練進模型,不再靠外部Harness串行調度。
不過目前頭部模型廠的主流路線還是將Agent的調度執行框架,交給Harness去做,大模型只是被訓練得很會用“拆分子任務”這個工具,當真正需要時,再通過Harness的子Agent工具派出若干個子Agent並行執行。
b.上下文、糾錯規劃納入大模型
除此之外,各家大模型的上下文窗口都在向1M看齊,規劃、自我糾錯越來越成爲模型自身的能力,這也使得負擔了上下文管理、壓縮、檢查糾偏的Harness,其本身的重要性有所下降。
(2)模型收斂,且並不用追求持續用前沿模型
大模型是坐鎮大後方的決策層,底層大腦的差距太大,確實會影響用戶的終端體驗。但目前前沿模型各家的領先優勢普遍在3-6個月,在年中開源大模型大幅追趕、縮小與閉源頭部的差距之後,近兩個月北美閉源頭部也咬得非常緊,相繼推出新版本。
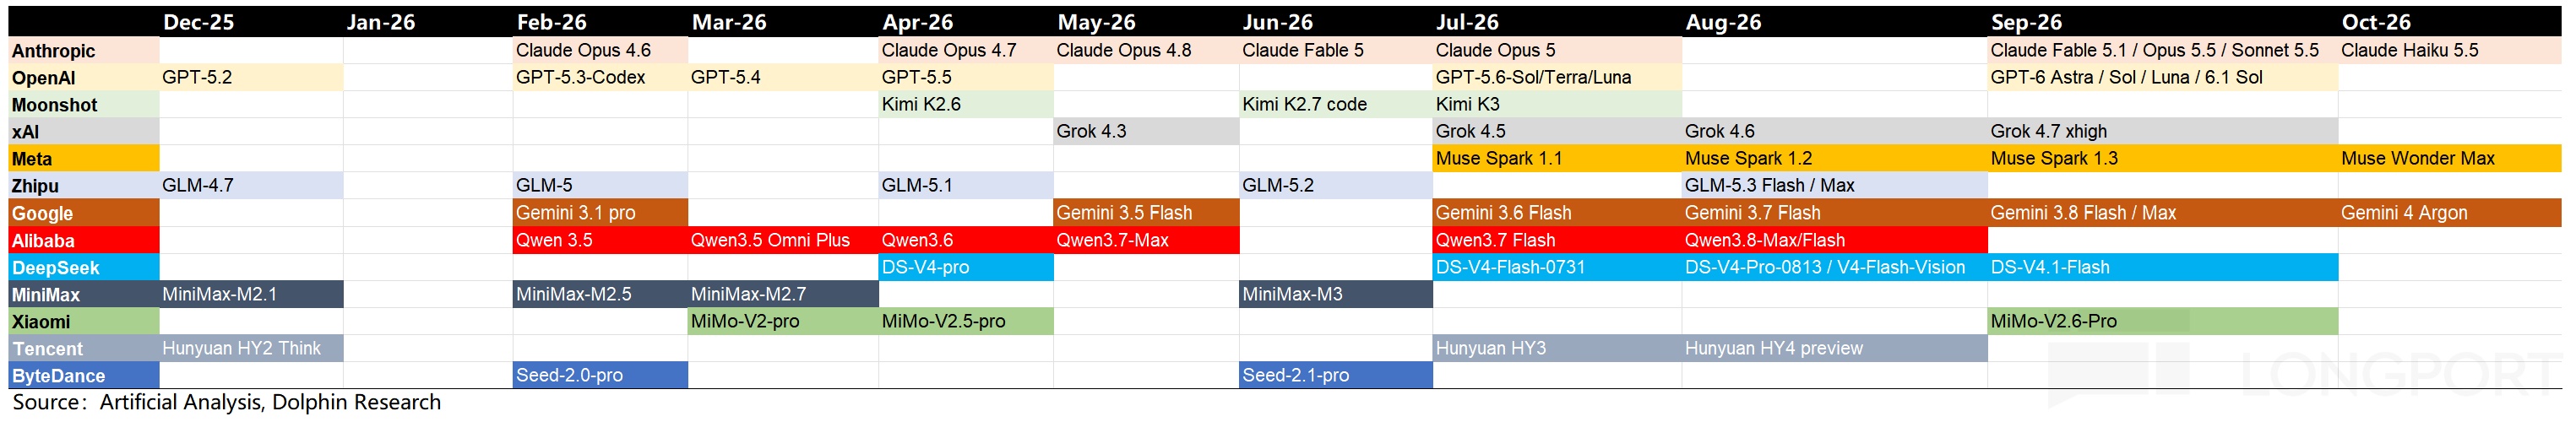
儘管閉源模型通過封鎖思維鏈,嚴防死守同行對其做蒸餾,但追趕者們仍然可以通過不斷完善訓練環境(具備有效反饋驗證的數據回流),也就是進行更多的後訓練來實現大模型性能的迭代提升。
與此同時,在“能做事”這條及格線上,模型之間的差距已經在收斂。
閉源模型在不斷降價的同時(甚至不惜走下神壇,以性價比更高的小模型來與中國開源模型直接打擂臺,是一種產品矩陣的打法),仍然擋不住原來的大客戶正反過來成爲它們的競對。以下幾例無一不說明,“純模型層”的客戶鎖定很弱。
a. Meta 先用 Claude Code 開發 Muse,再用自研 Muse Code 替換 Claude code;
b. 微軟讓 Copilot 的自動路由默認走更便宜的 OpenAI 模型;
c. 阿里7 月棄用 Claude Code,改推自家 Qoder。
(3)真正難抄的是“用戶使用數據”留存
既然大模型和Harness都不具備絕對的技術壁壘,那麼拋開價格,爲什麼用戶認爲Codex和Claude Code總比其他Harness明顯更聰明呢?
這裏面的“聰明”說到底主要表現爲——Codex和Claude Code能快速理解用戶意圖,同時對過往的經驗能夠主動吸收並運用到下一次的任務交付中,綜合來說,其實就是上下文能力。
一個具備較深上下文能力的Agent,能夠沉澱用戶使用數據並在未來任務中調取,更好地執行任務。這些數據包括聊天信息、文件、郵件、權限,特定行業Know-how、企業內部規範、組織架構、業務流程記錄,尤其是用戶每一次糾錯、批准、拒絕不同反饋的執行軌跡,都能夠回流去對底層大模型進行後訓練強化學習。
這也是爲什麼擔當入口的Harness,即便承載的是第三方模型,反而能夠通過收集用戶使用軌跡數據,來反哺訓練自家模型。
如下圖,按照Agent的運作流程,底層大模型和Harness對用戶使用軌跡數據的觸達能力,有着明顯差異:Harness層能看到的用戶使用數據明顯更多,尤其是海豚君圈出來的“人工確認與交付”環節,大模型層幾乎完全看不到用戶的驗證與反饋,喪失了可以用於後訓練的最佳原料。
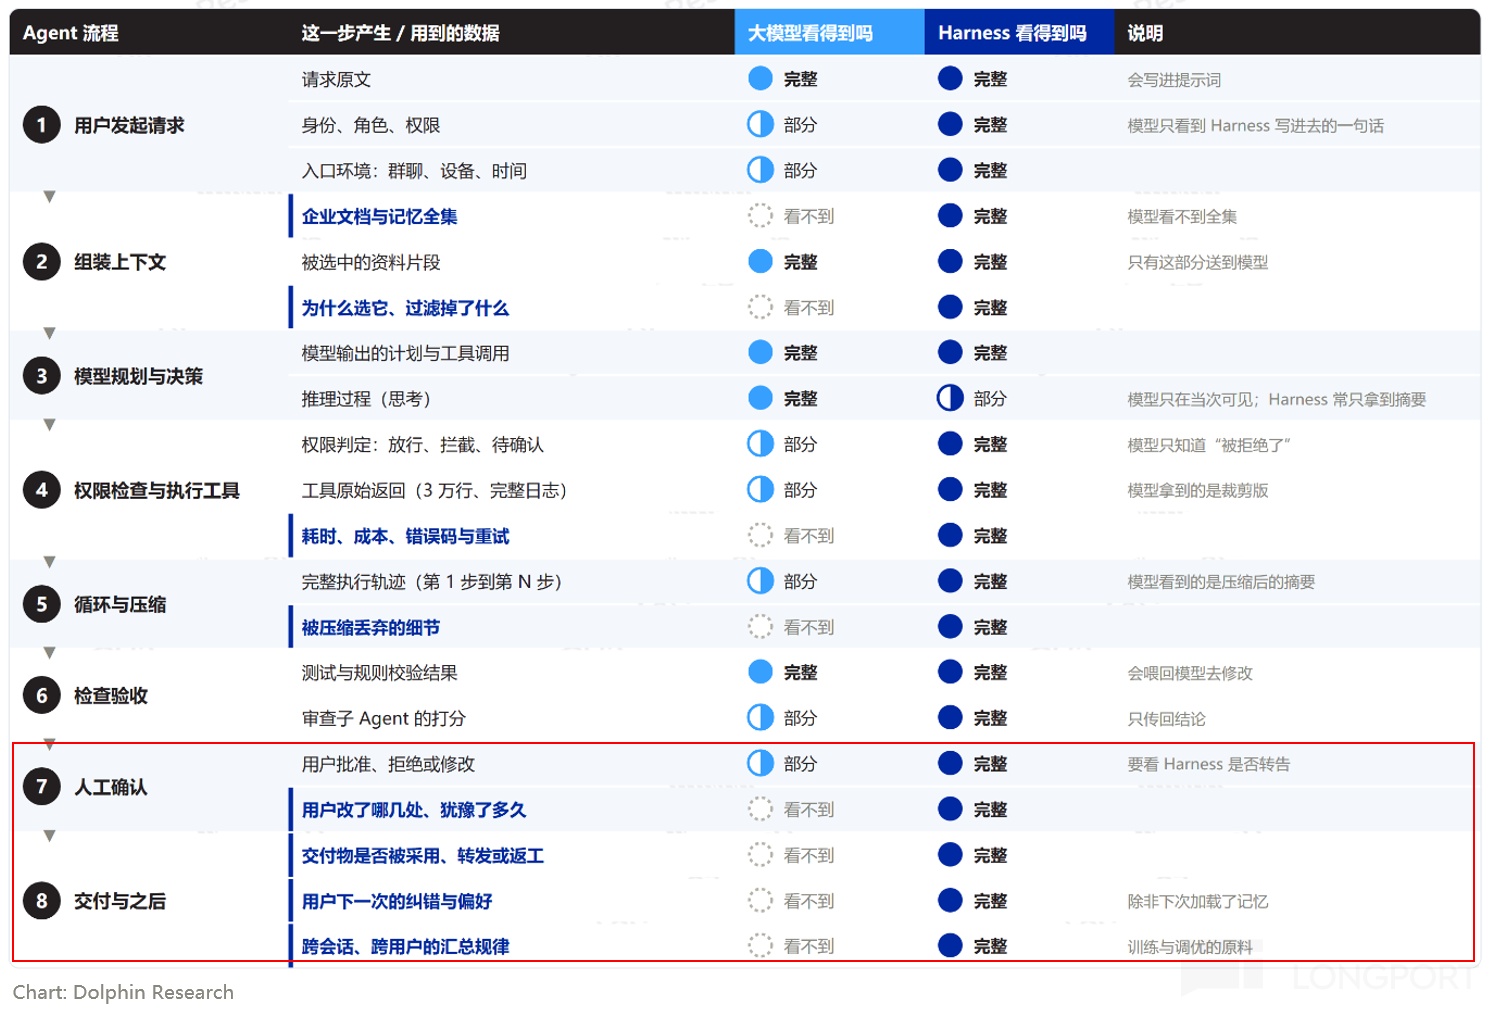
因此若大模型和Harness入口平臺不是同一家企業,那麼數據回流對原大模型的後訓練優化也要打折扣。反之,提供Harness入口的平臺,則可以利用這裏的用戶使用軌跡數據,來對自己的落後大模型進行快速優化。
當然,最佳的方案則是,大模型和Harness均來自同一家公司,那麼這家公司就能得到完整的用戶使用數據。不斷通過後訓練的優化,產品體驗上讓用戶覺得“越用越聰明”。
3. 自有生態是另一種起跑線優勢
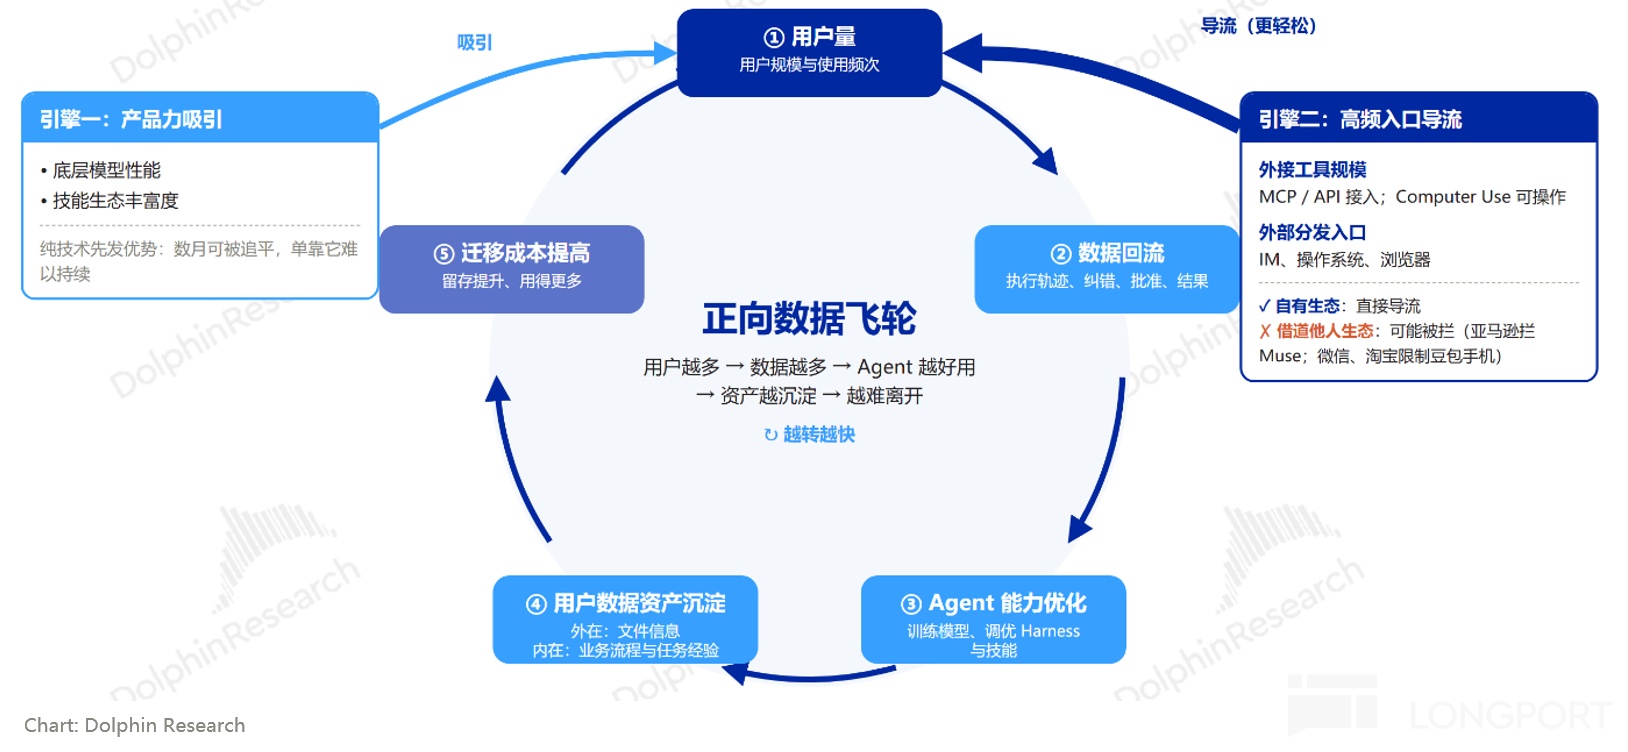
但數據回流的規模大小,又與用戶量息息相關。用戶可以是由產品功能吸引(底層模型性能、技能生態豐富度),也可以是由其他高頻入口導流——即外接工具規模(MCP/API接入,或Computer use可操作),和外部分發入口(IM、系統、瀏覽器等)。
而無論是外接工具還是分發入口,都不得不與傳統互聯網打交道。在巨頭生態各自爲政的情況下,哪一家擁有更多的自有生態、擁有鉅額流量優勢的IM入口,都算贏在起跑線上。它們對Agent的入口分發作用,比靠技術硬實力的先發優勢來得更輕鬆。
三、個人Agent vs 辦公Agent:長期理想 vs 短期現實
如果類比互聯網,消費互聯網的價值遠大於產業互聯網。
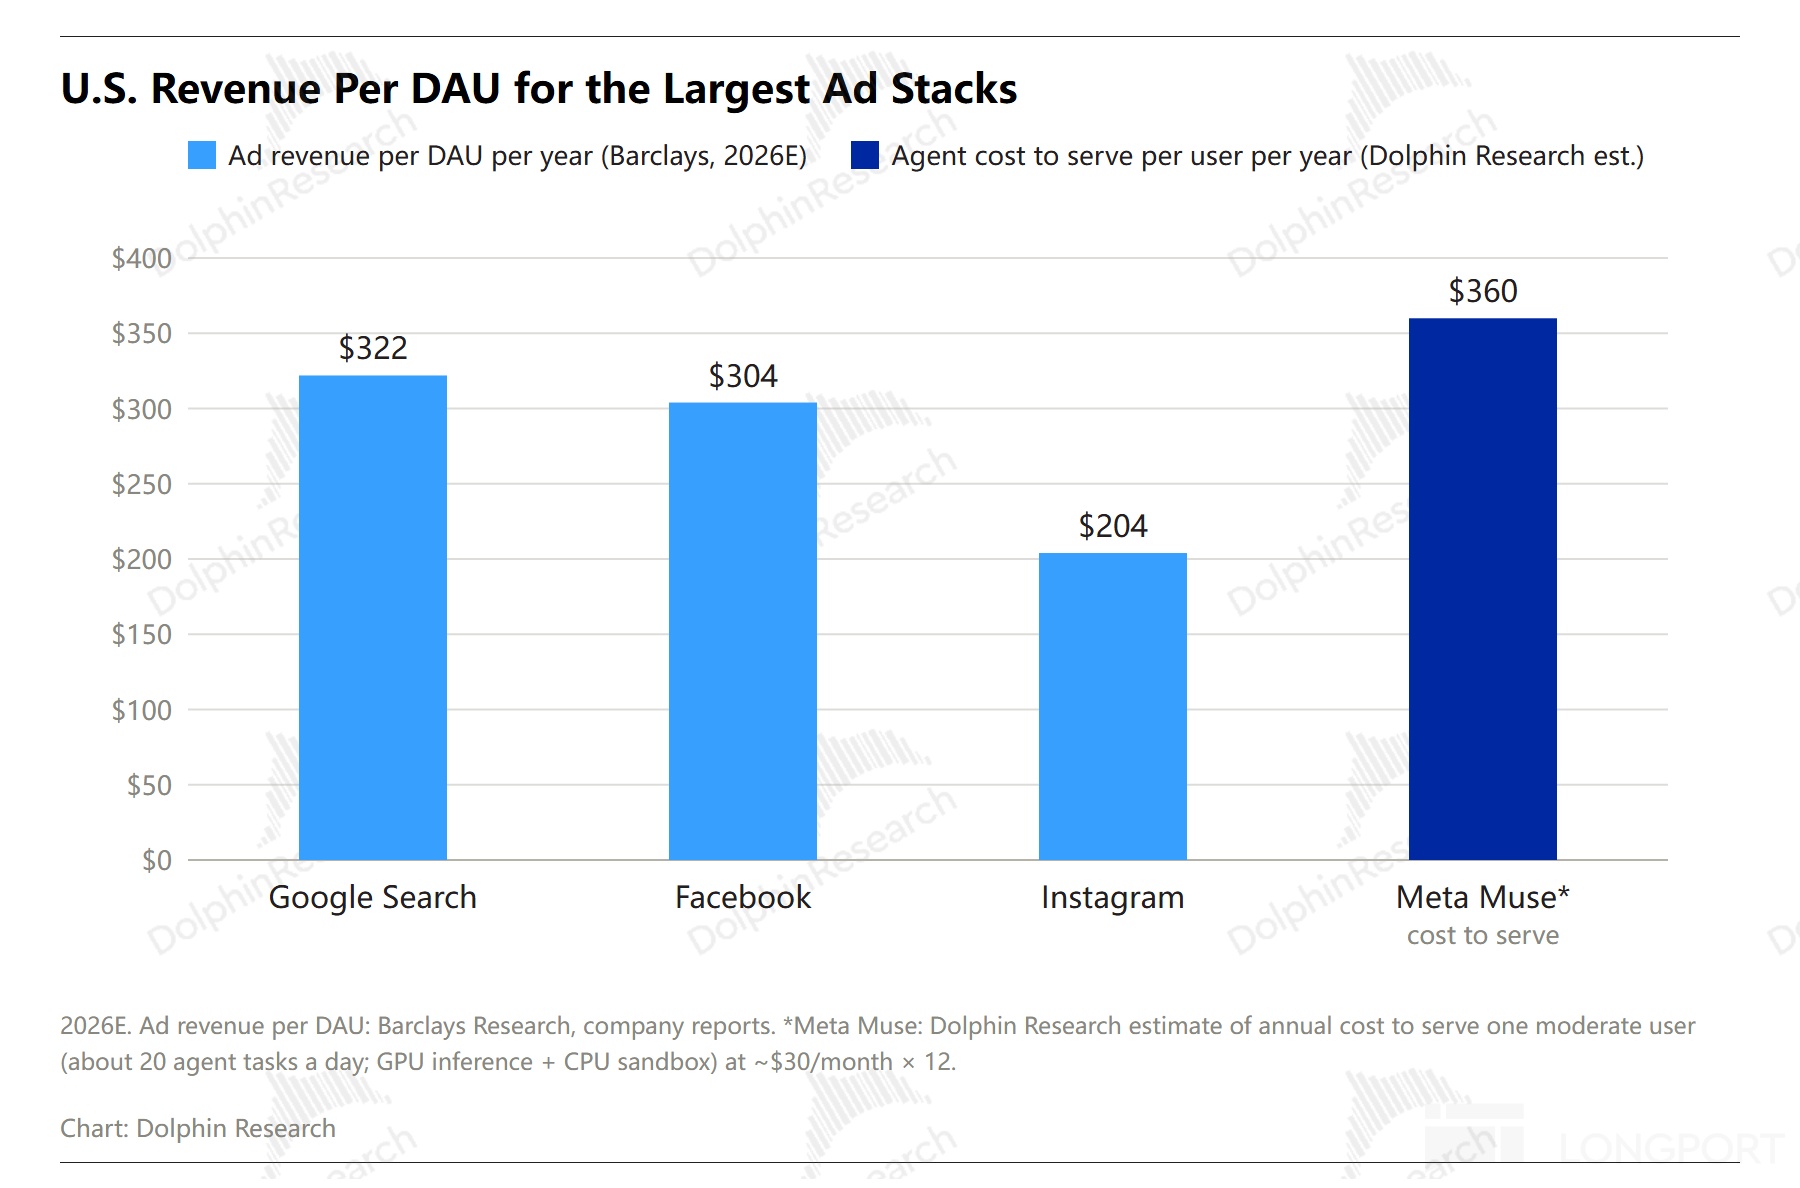
個人Agent面向幾十億人,一旦成了電商購物+OTA的總入口,廣告和交易佣金的想象空間是巨大的——2026 年美國每個日活用戶能貢獻約 300 美元廣告收入。
但眼下有三堵牆:
(1)生態牆:通過Agent調用第三方生態平臺的服務,會跳過開屏廣告和推薦流,從而讓外部平臺錯失廣告和佣金,因此AI原生入口往往會遭到傳統互聯網平臺的抵制。
這個問題放在中國市場可能更加凸顯。最典型的案例就是豆包手機上線,遭到了微信、淘寶、支付寶和多家銀行App的“圍剿”,而9月發佈的Meta Muse在北美同樣遇到了Amazon的跳轉封禁。
(2)隱私牆:個人 Agent 要拿銀行登錄、聊天記錄、支付權限。Muse 上線後接連出了“未授權讀取消息”“人工代打電話沒充分披露”等事件,而它承諾的“加密虛擬機”要到年底才上線(但普通隔離虛擬機已經上線);開源的 OpenClaw 暴露了 13.5 萬個公網實例和上千個惡意 Skill,Gartner 直接建議企業封禁。
沒有深入用戶生活,個人Agent就很難提供真正有效的AI服務。
(3)成本牆:目前大衆用戶對個人Agent的實際粘性(時長和使用頻次)都不算特別高。比如還在營銷勢頭上的Muse,上線一個月後的用戶粘性數據,就算有了社交平臺的加持導流,DAU/MAU也只是ChatGPT水平,離真正的助理水平(至少看齊社交平臺)還有差距,這也意味着Muse的商業化至少在短期是個問題。
但Muse的成本不低:它爲用戶單獨配備了虛擬機,同時還要負擔免費、低檔付費用戶的Token成本。據MS測算,以每天用戶讓Agent幹10-20件事(包括後臺一直運行的agent),每用戶每月總服務成本爲15~37美元區間(CPU沙箱+GPU算力)。
同時通過另一渠道的專家調研估算,單人單月成本也是大約在30-50美元。我們以30美元/月爲參考值,那麼意味着全年單人服務成本爲360美元。但Meta旗下兩大平臺Facebook、Instagram目前的單用戶廣告價值,還不到360美元。而上述20件事的Token用量還在免費套餐額度之內,用戶不需要額外購買Muse的付費套餐。
反觀面向企業辦公場景的Agent,長期TAM至少可以從效率提升、侵蝕傳統軟件兩個角度,找到相對清晰的承接來源。
智譜在1H26業績會上,給出的Co-Working全球TAM展望爲5萬億美元(對比Chat的1000億、Coding的5000億,是數倍大的市場)。
另一種思路是直接拿office作爲參照,以office的付費滲透率情況(46%=4.6億席位/10億知識工作者)作爲基數,每人40美元/月的付費標準,得出總市場空間2160億美元。
海豚君認爲上述兩個展望都不合理:
5萬億佔到了目前全球10億白領以上員工薪酬的1/5、SaaS市場的3-4倍,若全部都是可觸達的替代空間,這對現有的生產方式是一個巨震;
而2000多億美元的估算假設中,不僅算少了office的基數(遺漏了破解版部分的需求),同時也低看了AI實際能承接的工作價值(不只是文字處理工具)。
海豚君選擇從人員降本提效、侵蝕傳統軟件兩個角度來做一下估算,供大家參考:
(1)個人提效&員工降本
首先從人工替代的角度去計算價值空間,通過估算Agent能夠承接的工時佔比,算出理論上可節省的員工薪資。
同時考慮到線下溝通成本、遷移成本、ESG等社會責任壓力,企業可能更願意讓員工開展更多業務,而不是隻有裁員這一個選項,所以我們增加一個廠商分成比例的係數,來代表企業最終的付費意願。
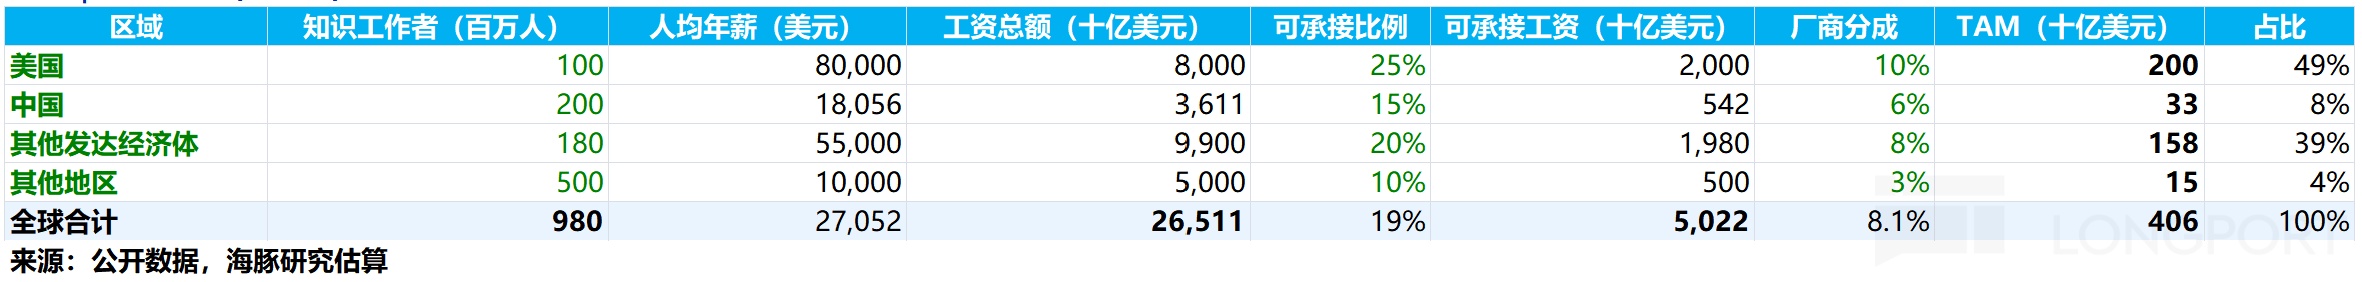
最終空間大小=知識工作者的工資總額 × Agent 能承接的工時比例 ×Agent廠商可獲分成比例。
按照不同市場,海豚君對上述因子的假設和估算結果如下圖,最終預估各地區TAM加總爲4060億美元。
(2)企業軟件替代
另一個TAM的承接來源是現在的傳統企業軟件被替代,或者沒被完全替代,但在整個企業IT預算中的份額變少了。
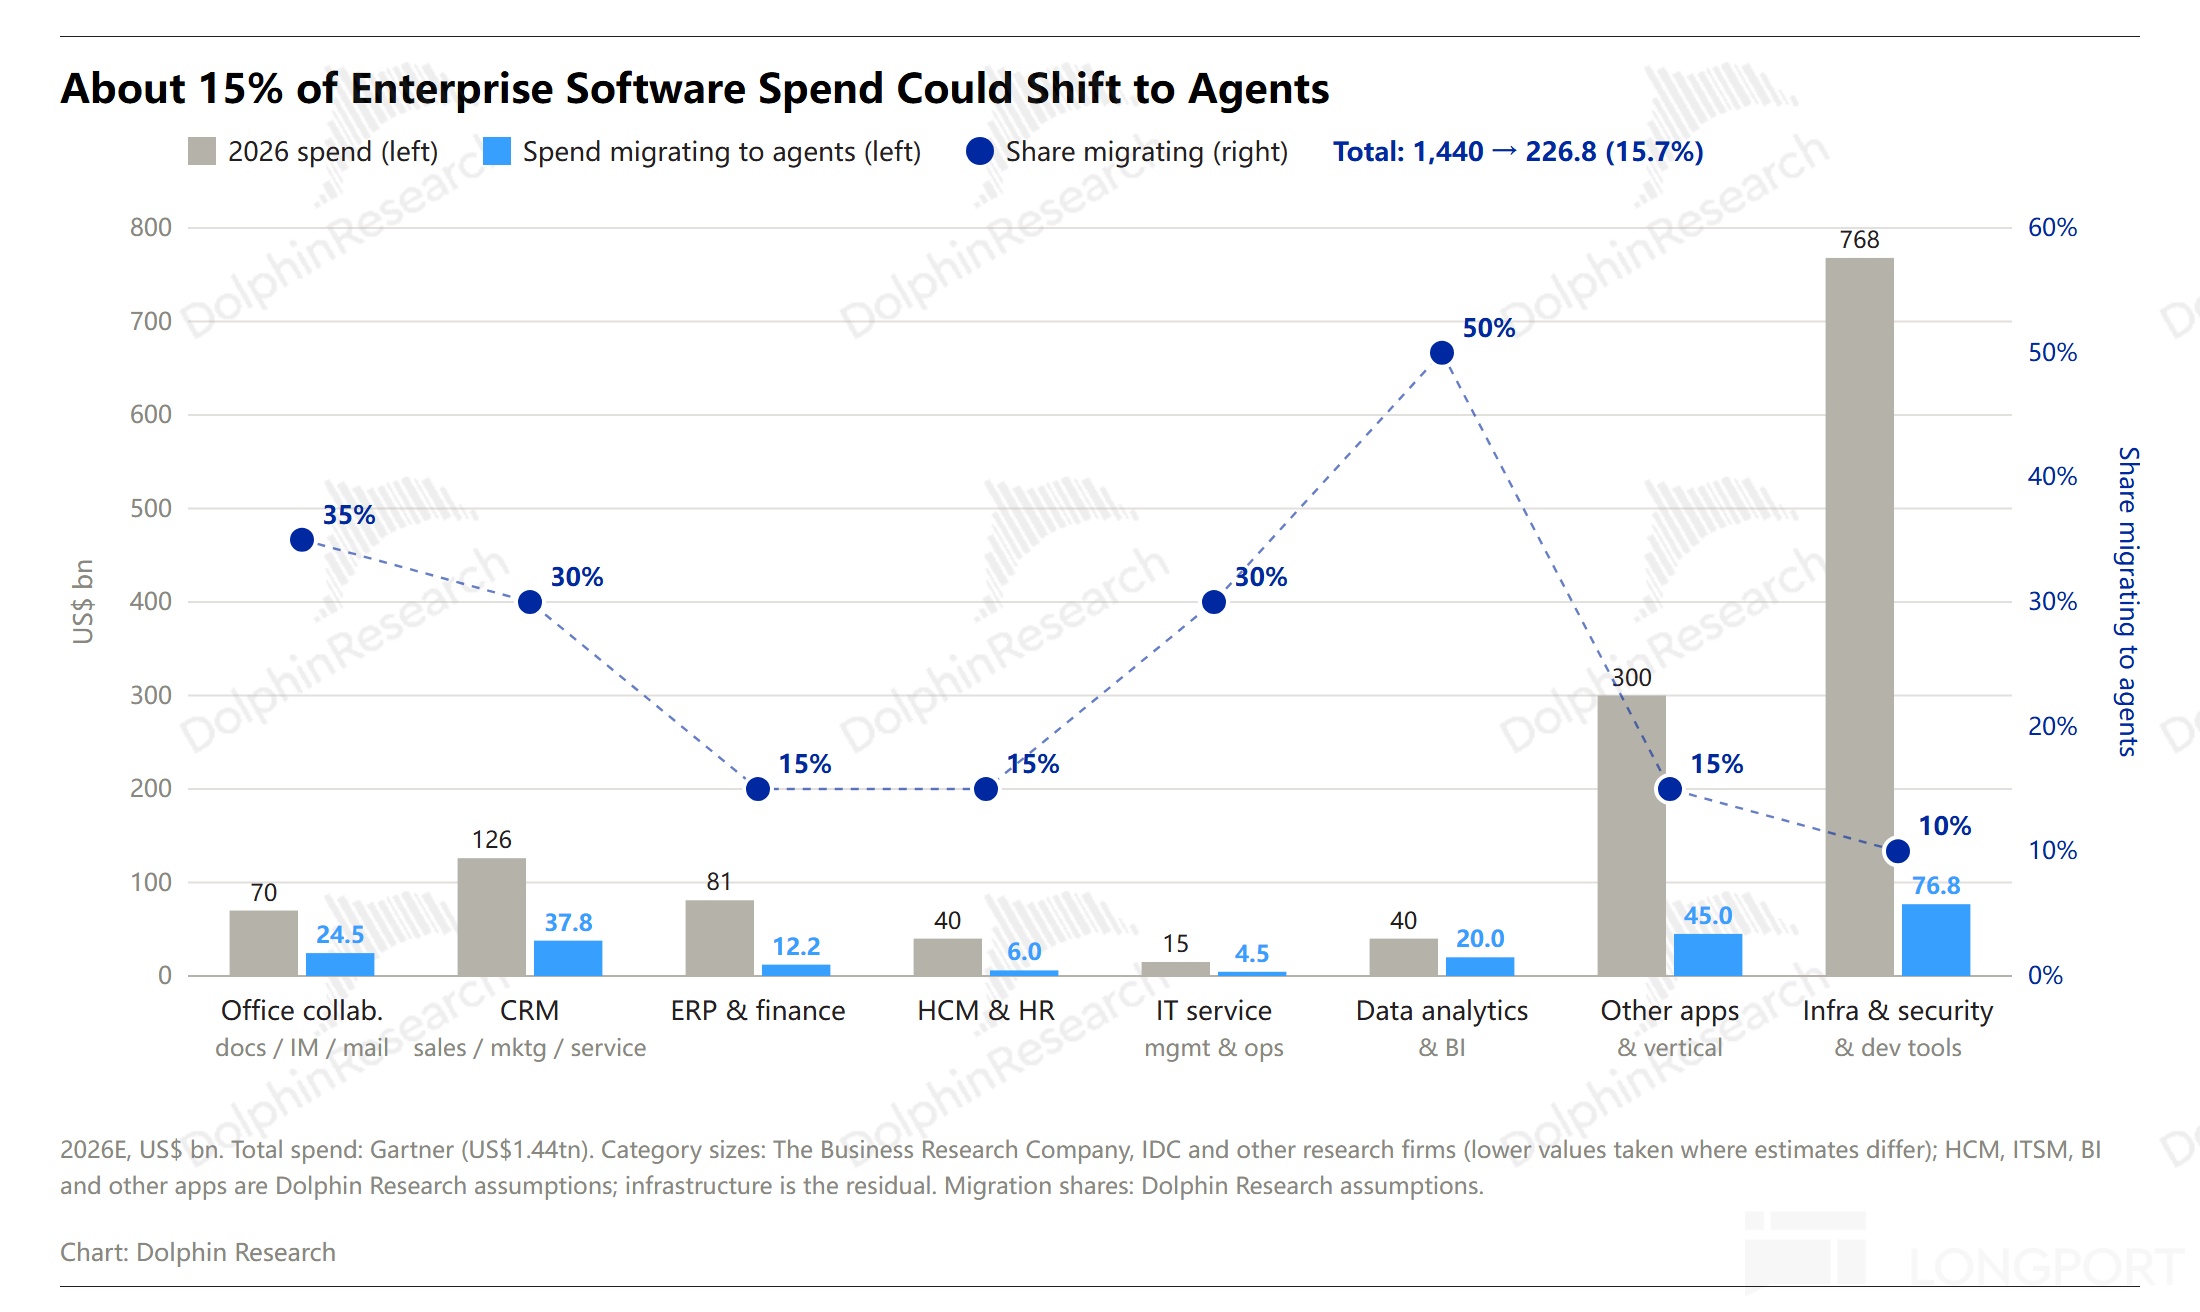
Gartner給了一個參考值,到2030年,Agent有望侵蝕掉傳統SaaS軟件支出(2026年預計1.44萬億美元,按CAGR 12%的增速算到2030年爲2.3萬億美元)約10%,也就是2300億美元。
不過海豚君認爲Gartner的估算可能偏保守,我們按照企業軟件的品類對應的遷移難易度,最終估算下來相比Gartner要高一些,整體侵蝕率16%,按2026年算TAM爲2270億美元,按2030年算TAM爲3560億美元(軟件總市場規模增速按Gartner的預期來估算)。
其中辦公協作、數據分析與BI遷移最容易,我們假設有40%-50%;基礎設施工具則替代率最低爲10%,這並非因爲難度大,而是更多被Agent拿來即用。
(3)加總後的全球TAM
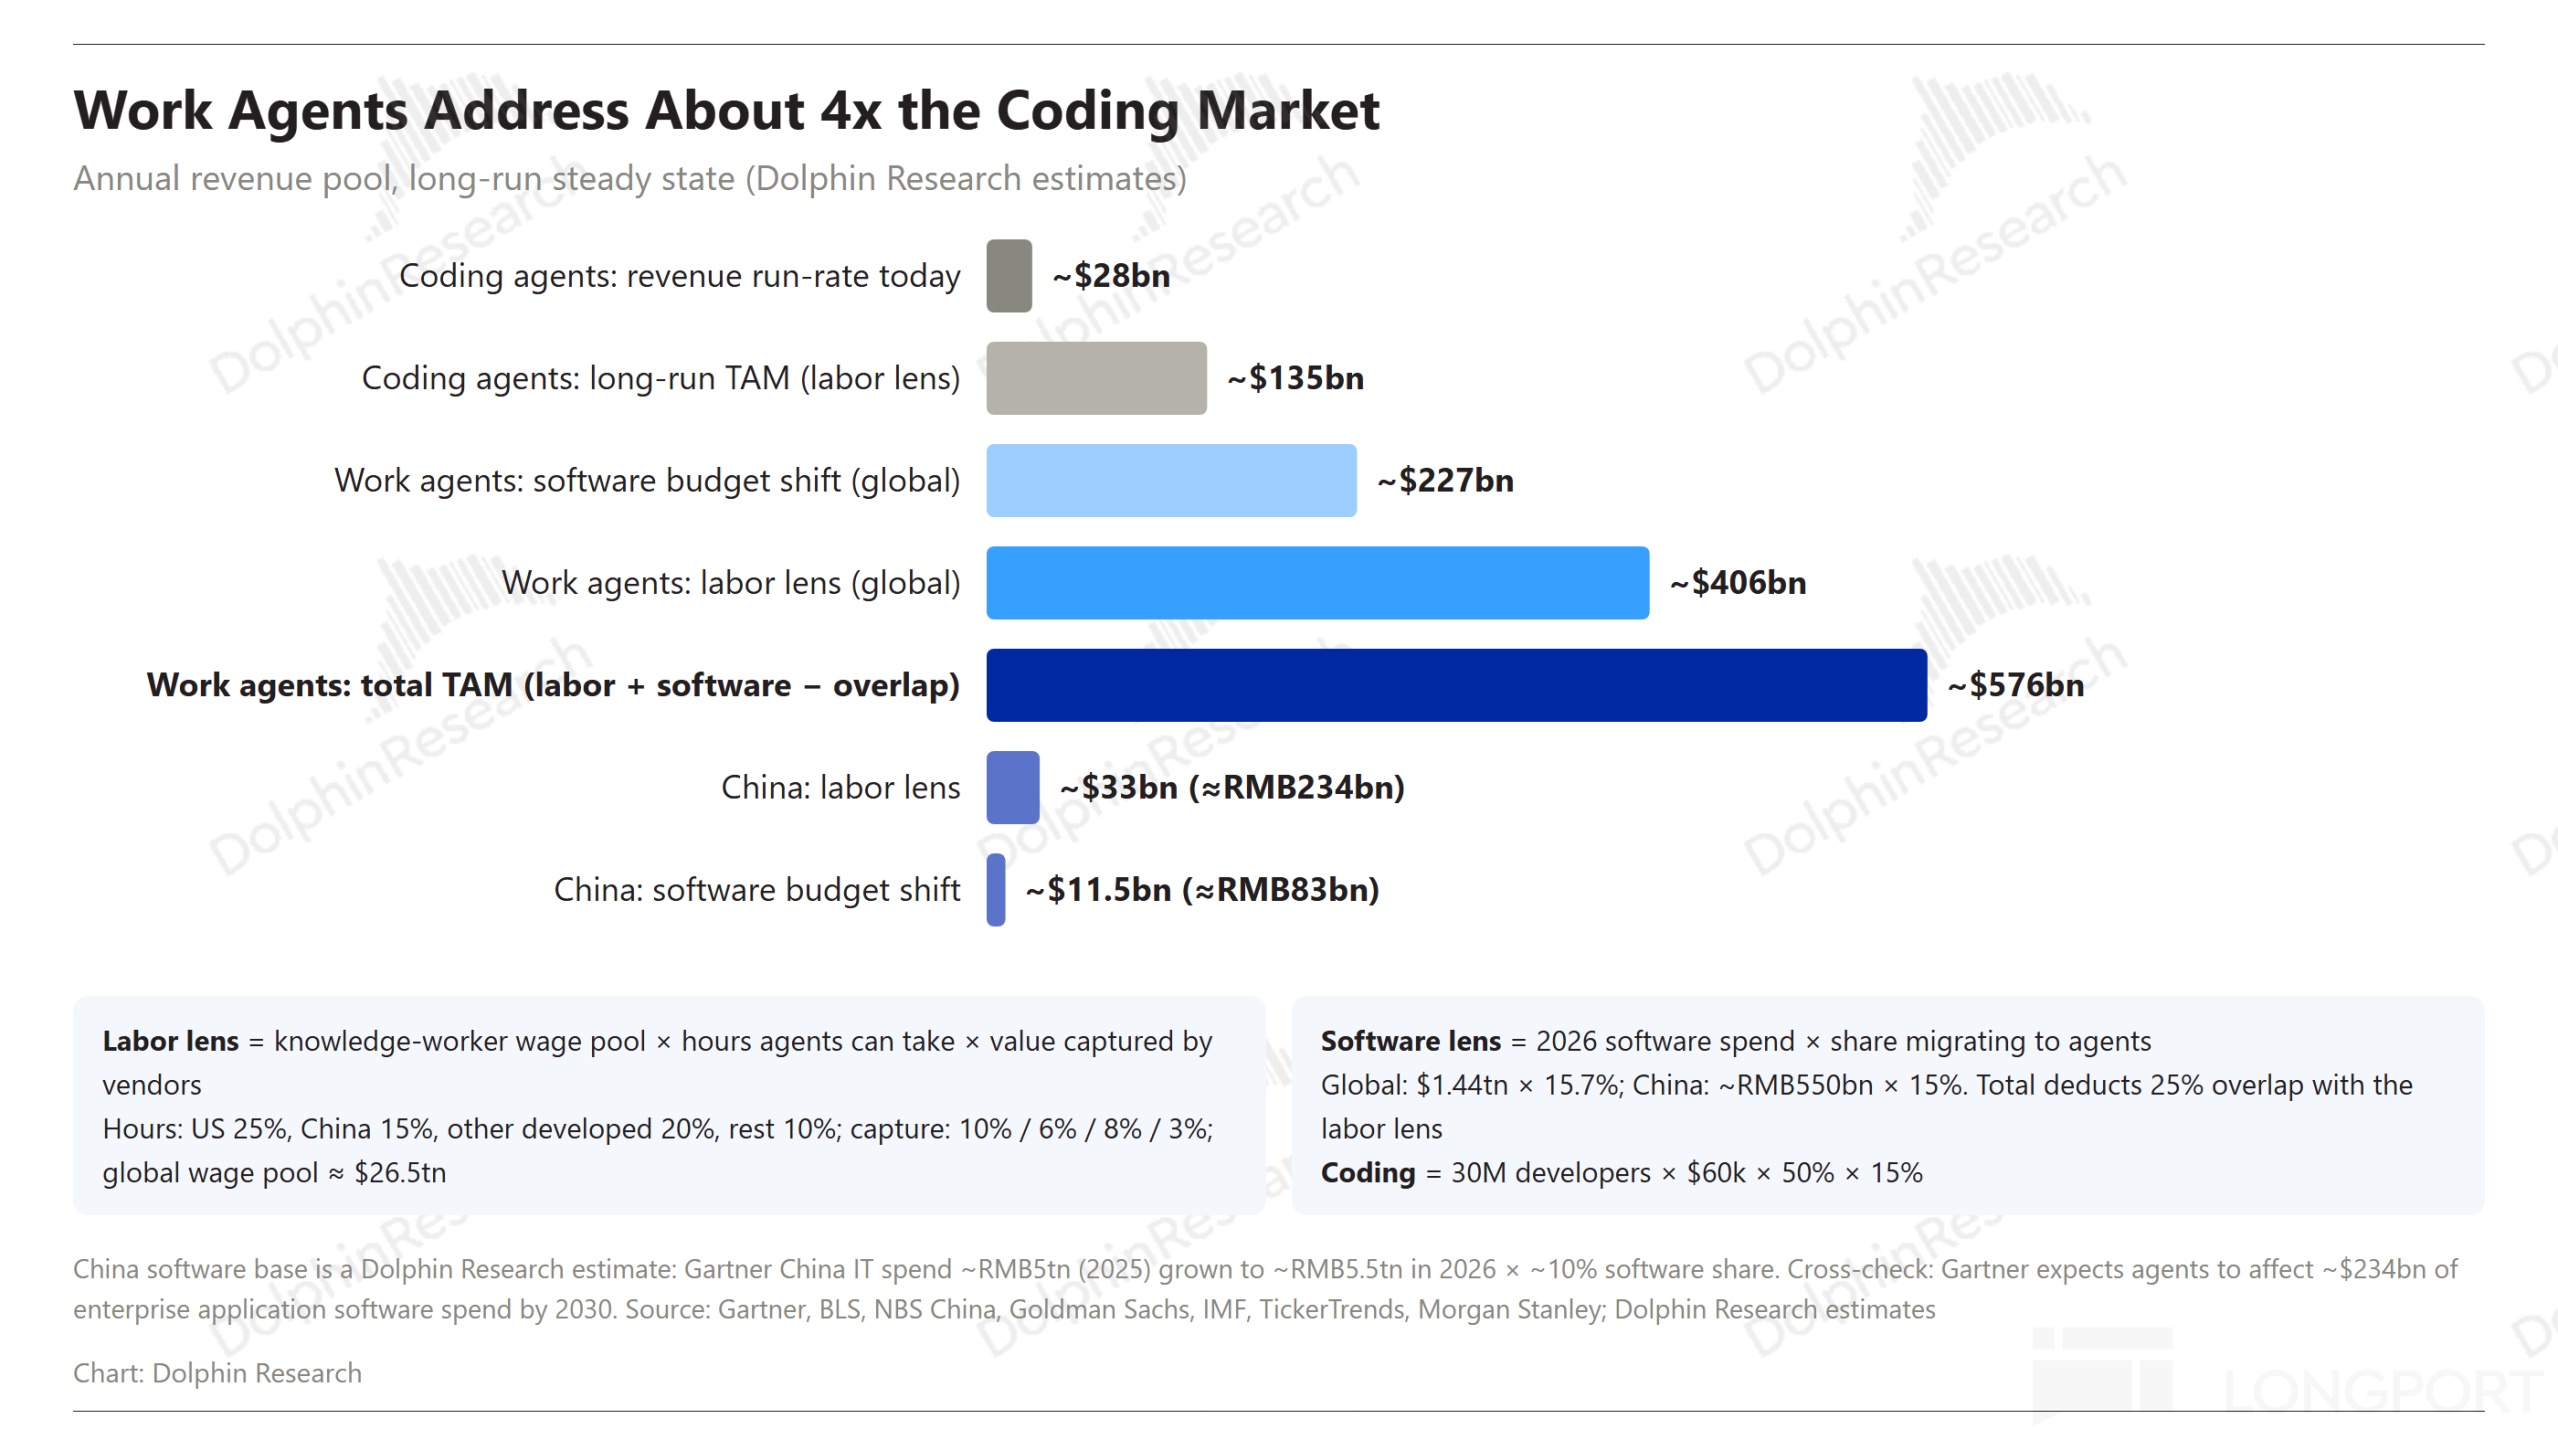
以2026年的基數算,人員降本+軟件侵蝕的TAM爲4060+2268=6328億美元,這個口徑的估算值位於office參考計算的2160億美元保守預期和智譜展望的5萬億美元樂觀預期之間。
值得一提的是,這其中可能會有一些重複計算——對企業來說,同一筆IT預算扣減傳統軟件的成本,也可以從員工身上減出來,但基本上仍然有望達到5000億美元左右的市場規模。
按同樣的思路計算中國市場,人員降本330億元+115億元合計445億美金,合3200億人民幣的TAM。
四、AI辦公對比,誰最有希望坐穩“工頭位”?
以中國市場爲例,最後我們再來聊一聊這個賽道的核心玩家(騰訊Workbuddy、字節豆包工作、阿里千問辦公,以及模型廠代表的智譜Zcode)。
作爲一個更有希望將巨頭重金囤下的算力有效變現的應用方向,海豚君認爲各頭部平臺相比年初的Chatbot入口爭奪,競爭只會更加激烈且持續。
但巨頭會減少純撒幣的舊獲客範式,轉而利用自身的傳統生態位和渠道優勢、疊加產品推陳出新的速度比拼,最快觸達用戶並實現高留存,持續積累企業、用戶的核心數據資產,從而率先擁有強者恆強的正向飛輪。
因此年中才敲鑼打鼓全面開戰的AI辦公市場,當下仍然是一個談終局贏家尚早的時期。但通過我們前文的梳理邏輯,也可以稍加評判一下目前各玩家的贏面。
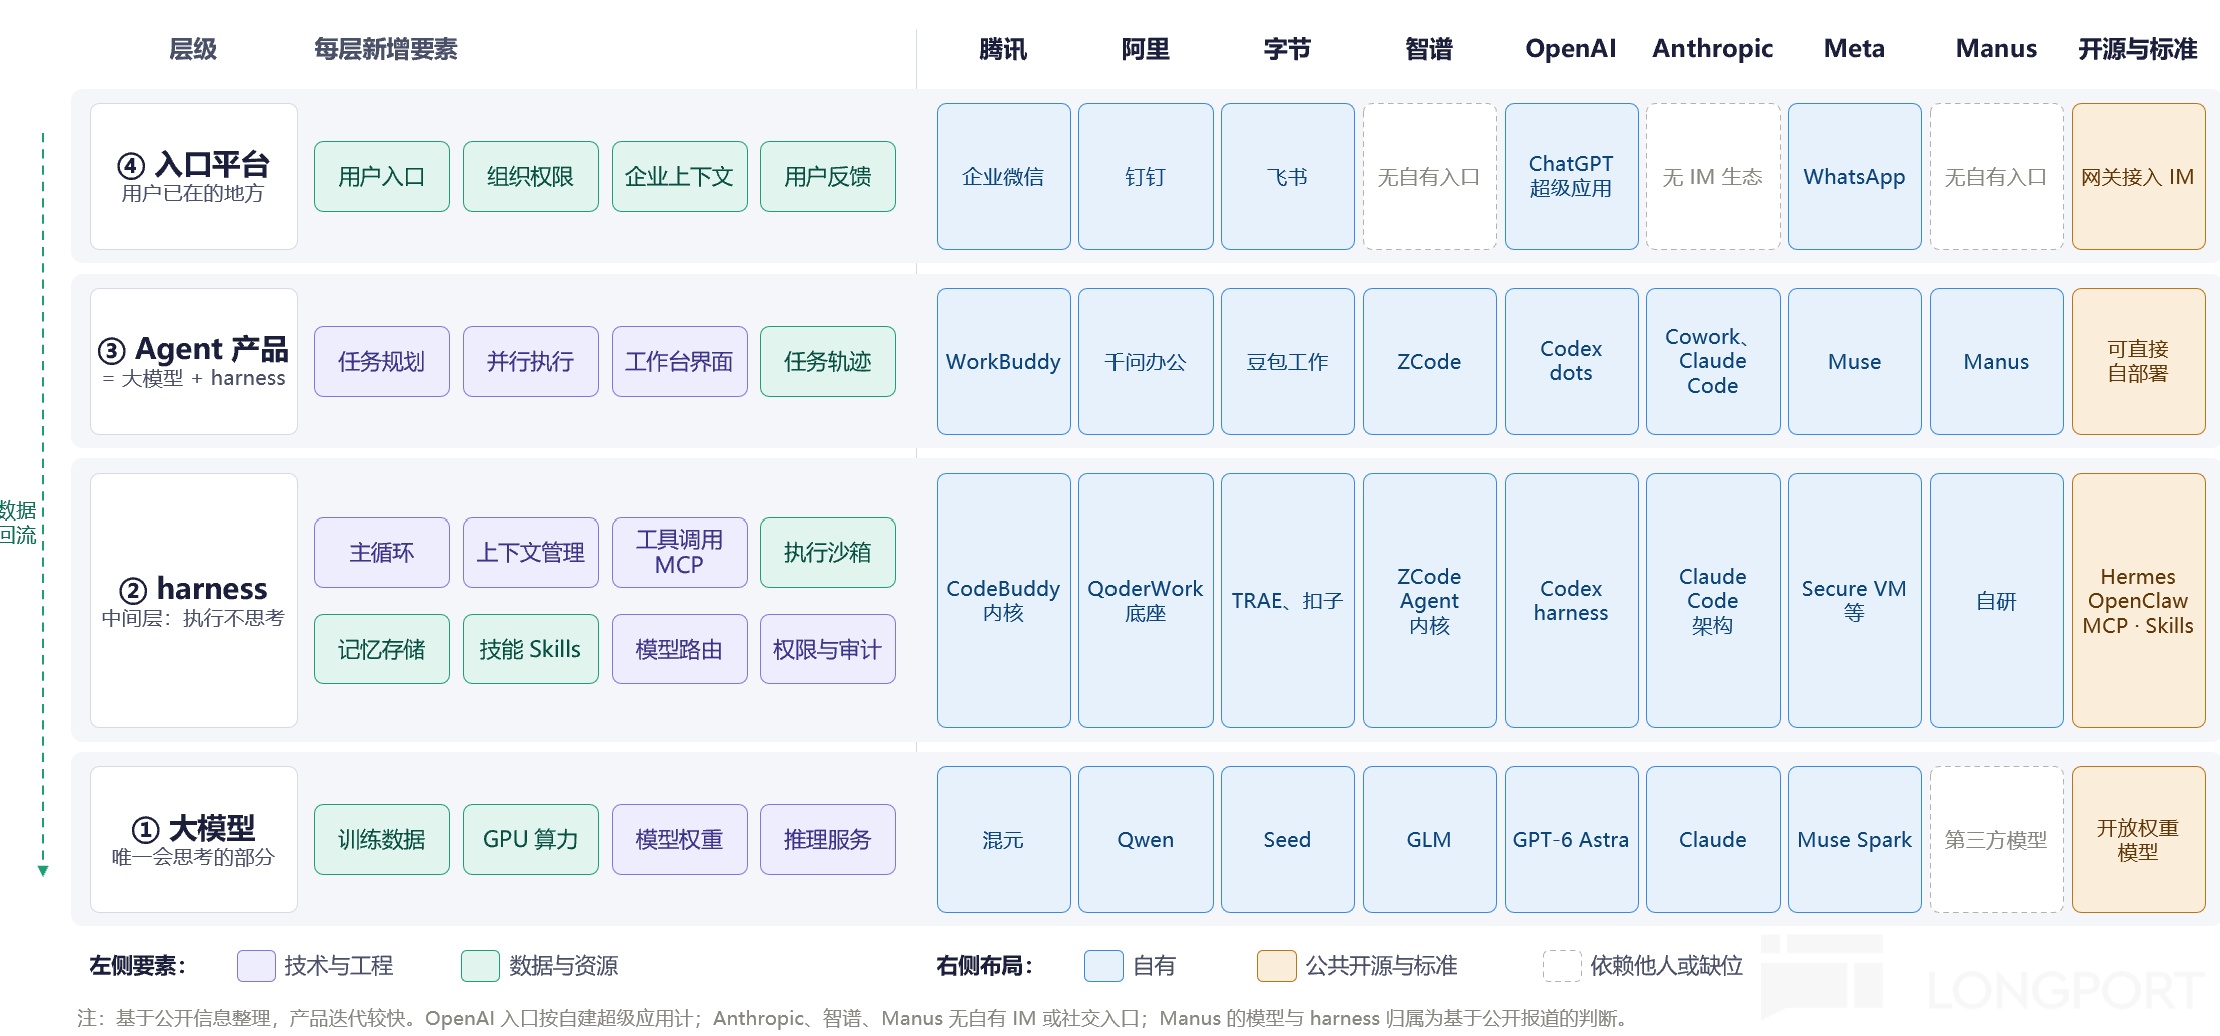
下圖是各AI辦公平臺運作的關鍵四層生態佈局,從完善度上,騰訊、字節、阿里都是全佈局生態。智譜缺乏一個上億流量的入口級產品進行導流,相對喫虧。
目前幾家AI原生的辦公Agent平臺,Workbuddy用戶規模暫時領先,但這裏面有騰訊在C端的流量優勢以及HY系列免費Token的性價比優勢加持。
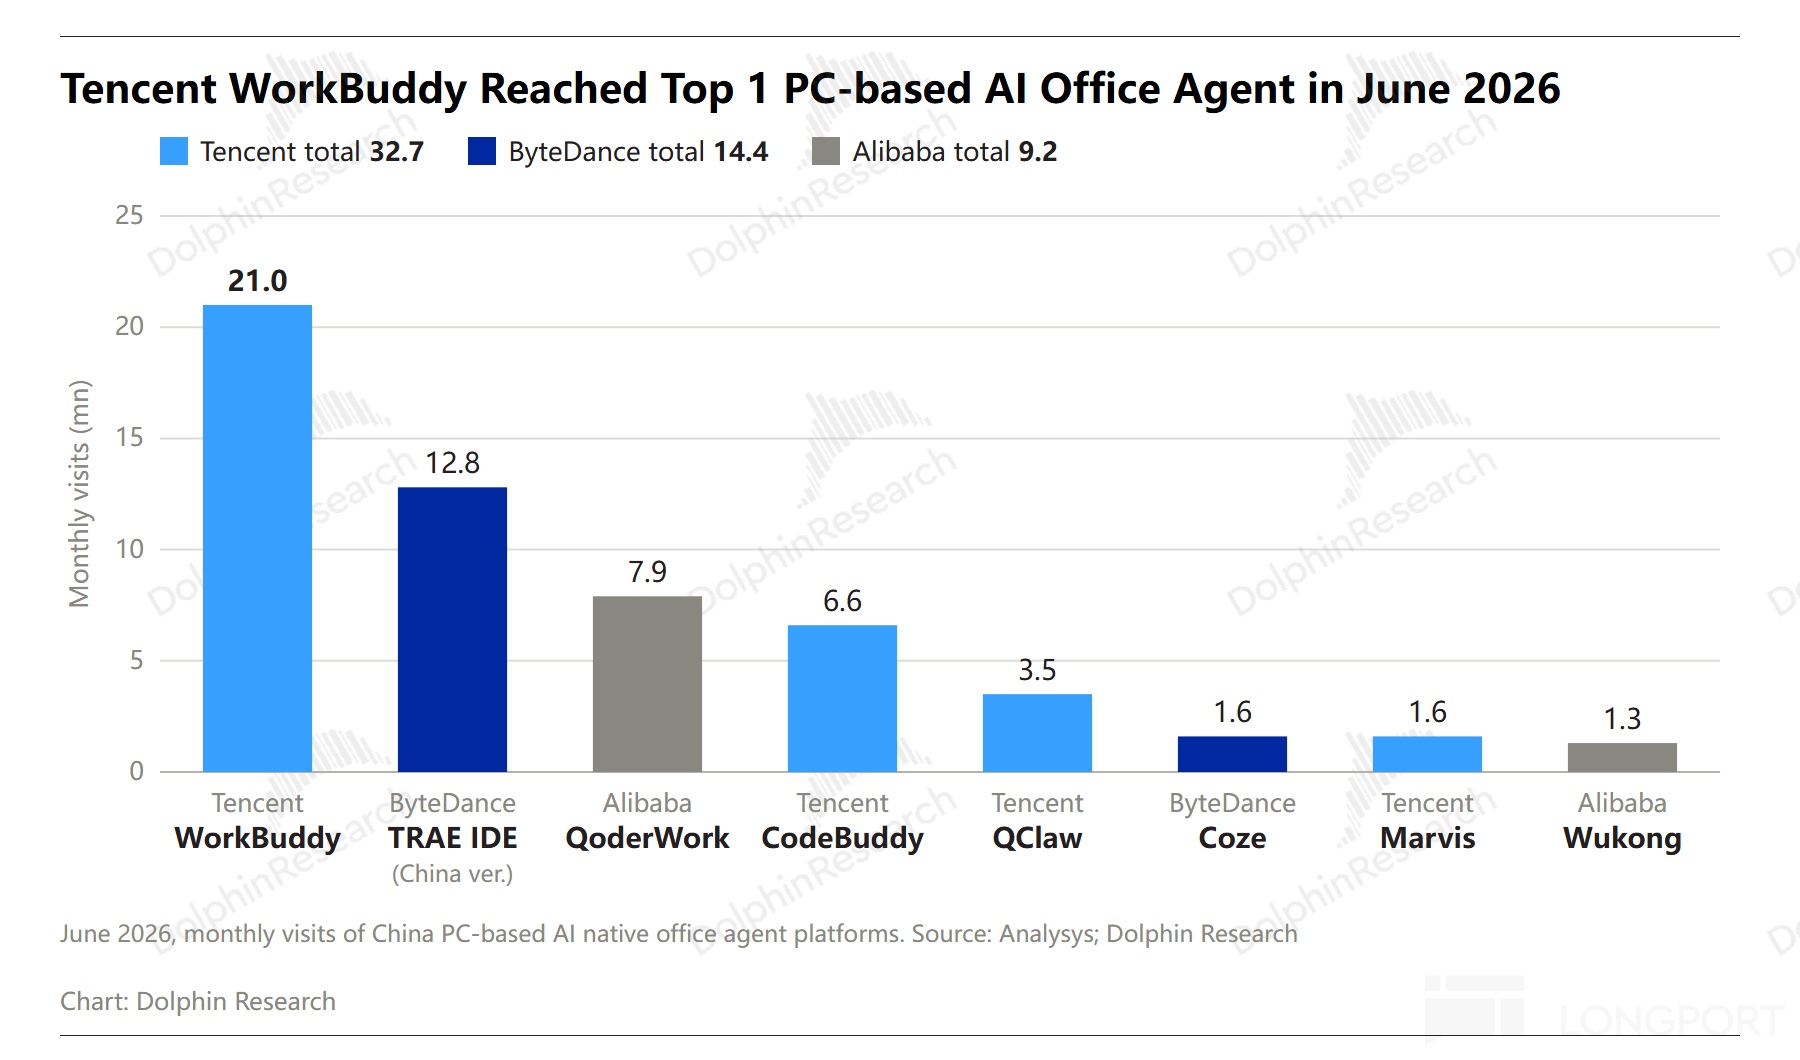
那麼後續的演進會如何發展?下面海豚君從前文總結的關鍵要素來進一步比較:
1. 上下文優勢
上文我們梳理的結論,純技術不構成絕對的壁壘,一個合格的、能做事的大模型只是入局的門票。不需要基準評分TOP的前沿模型,只需在穩定幹完長任務、單任務成本更低上跑出一定的優勢就行。在中國這個模型更便宜、追得更快的市場,技術更難成爲持續的壁壘。
但用戶使用數據的積累是關鍵,不僅能夠作用在底層大模型的後訓練上,同時也能更好地總結經驗並儲存,以及深入理解企業的業務流程,讓用戶使用體驗更佳,同時增加用戶的遷移成本。
而要擁有更多的上下文,要麼有生態內的高頻入口導流,直接積累更多的用戶使用軌跡;要麼就是本身擁有很多行業know-how的知識儲備,或者接入更多的行業方案。
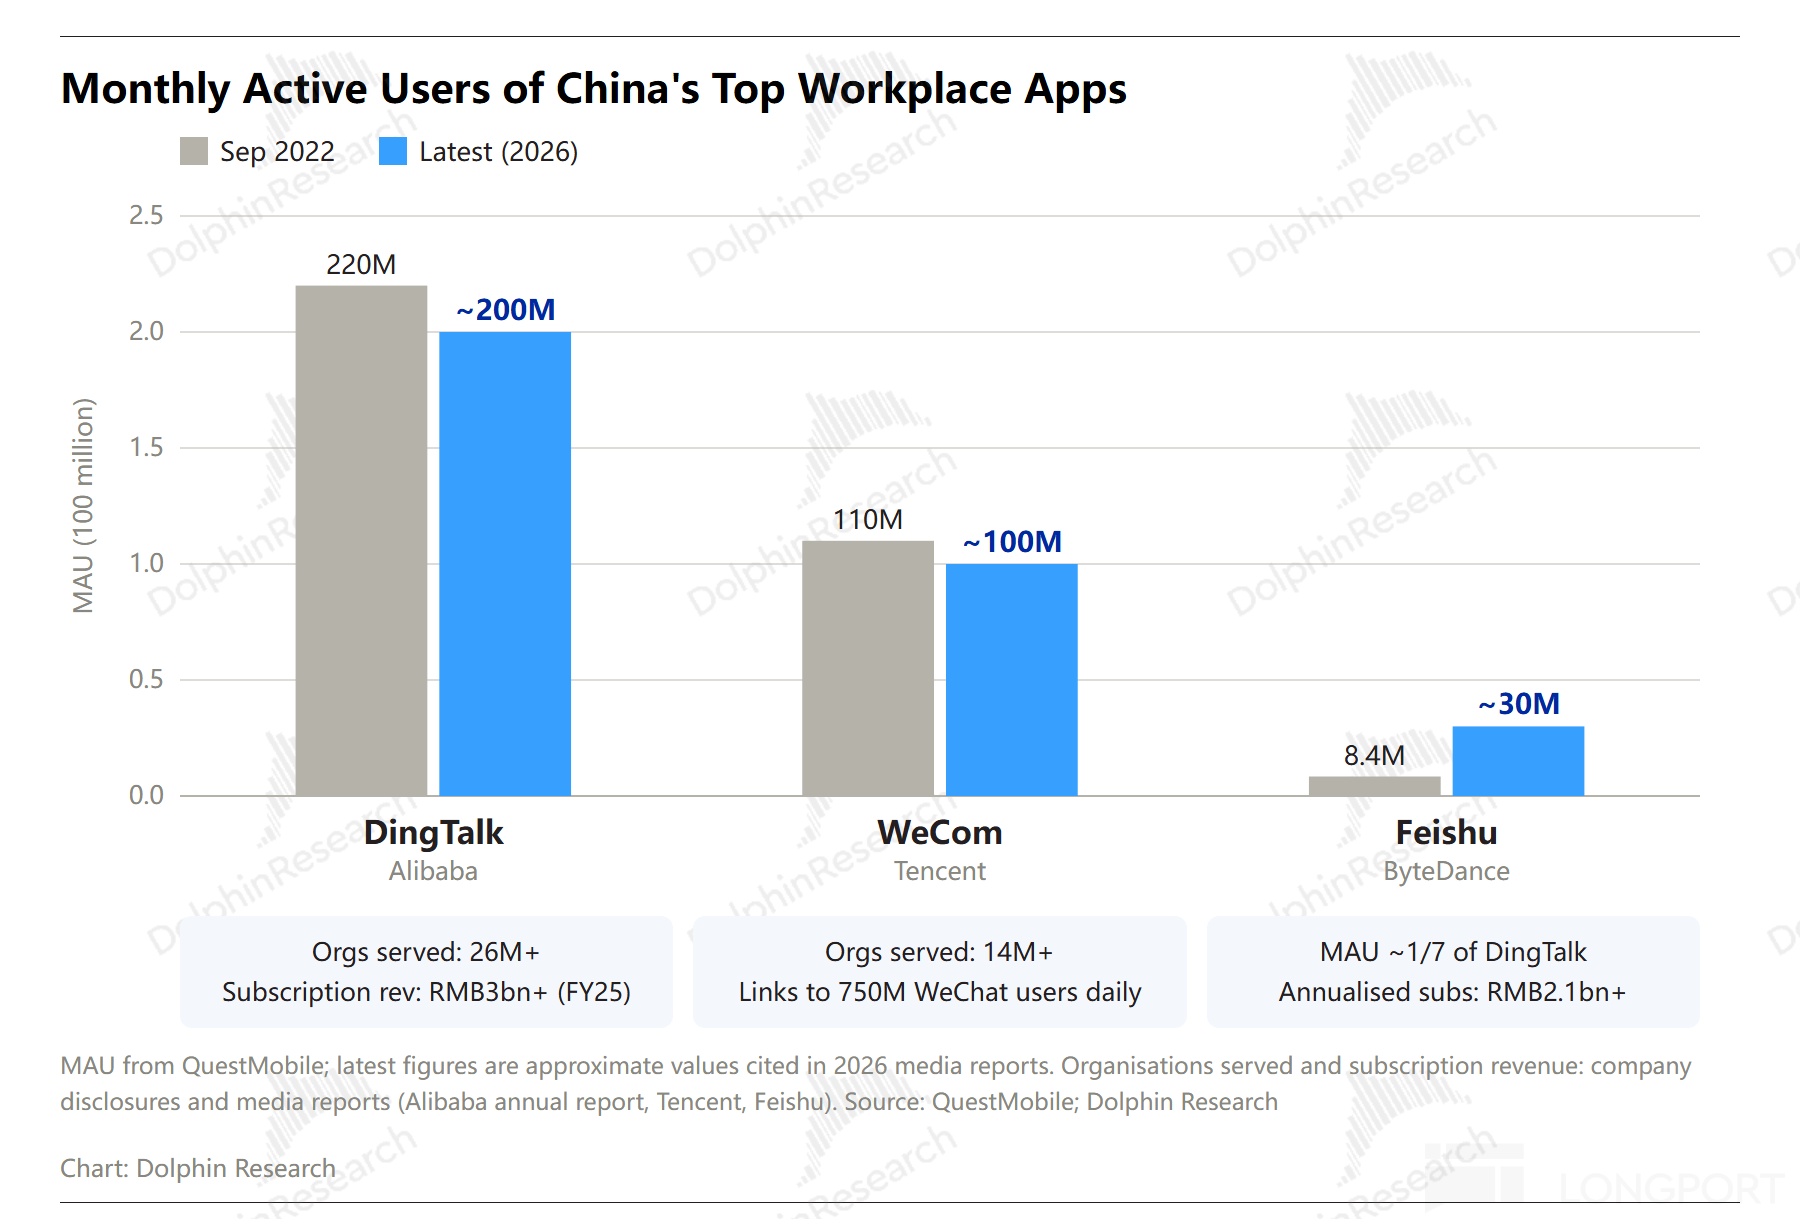
關於上下文優勢的對比,海豚君認爲:阿里>字節>=騰訊。
(1)阿里最優,目前具備入口的流量優勢+行業know-how。
釘釘服務全國2600萬家+組織,傳統行業、政府、教育的滲透是三家裏最深的。這些組織的審批流、組織架構、考勤規則都長在釘釘上,是最天然的“企業上下文”。
千問辦公順勢把這些上下文進行產品化,形成了25項企業模塊、20多個連接器,再加上MuleRun的專家網絡和Skill市場。
但小侷限是,釘釘客戶中小企業多、行業分散,單個行業做不深,其次know-how 主要分佈在通用流程(審批、考勤、報銷),專業領域的深度不如飛書的頭部客戶。
(2)字節居中,客戶質量更高
飛書的客戶集中在互聯網、新能源車、新消費、先進製造等“管理先進”的企業。這些客戶願意把核心業務流程搬上飛書,例如新能源車企的研發協同、茶飲品牌的門店管理,沉澱的是高價值、可複製的行業最佳實踐。
字節在“駐場交付”上的投入最大。據調研,目前FDE團隊60–70人規模,不只幫客戶內部降本,還做面向市場的獲客方案。
豆包工作目前已經按行業形成方案:智駕、AI模型公司、AI 教育、AI 製藥、AI for Science等標杆案例。
侷限在於入口借力有限,飛書月活只有釘釘的約1/7,行業覆蓋窄。因此豆包工作的企業方案深度綁定飛書,跨生態就打折扣,這等於限制了企業的多平臺選擇。
(3)騰訊目前更依賴開放生態,但流量優勢正在積累數據資產
雖然Workbuddy在原生AI辦公平臺上跑得最快,結合最新的調研信息,9月日活已經跑超600萬,但平心而論,騰訊在可以藉助的入口流量和行業知識積累上,都不佔優。
企業微信本身更偏對外溝通和客戶管理,嵌入企業內部流程較淺,業內也評價它在三家裏“企業專屬模塊最弱、生態最中立”。
因此騰訊的打法相比阿里、字節會更加開放,是“我出Agent、模型、分發,夥伴出行業數據和 know-how”,又開始了熟悉的開放生態玩法:
a. 在入口補充上,Workbuddy接入了30多個硬件品牌,覆蓋智能眼鏡、錄音卡、麥克風、耳機等10+品類;
b.在行業know-how上,Workbuddy 開放平臺首批接入了100多家生態夥伴,橫跨20多個行業,其中深度合作的企業超過30家。
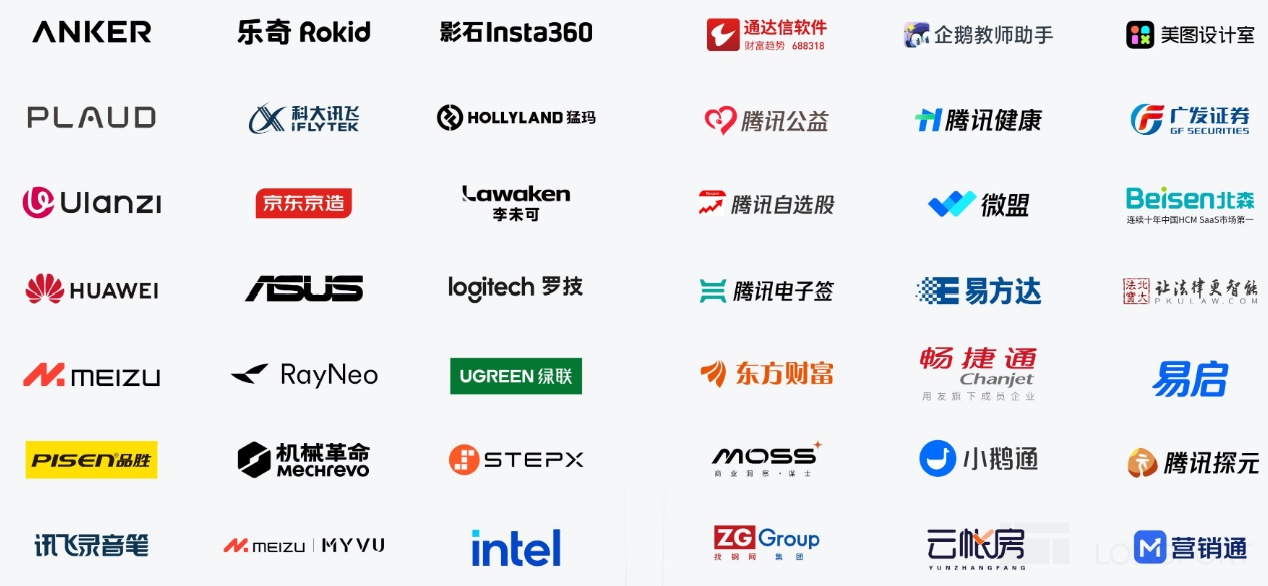
目前Workbuddy的優勢主要在金融營銷、零售私域這類“對外”場景裏(企業微信能直接觸達微信用戶),know-how和數據是另外兩家沒有的。
值得一提的是,如果過度依賴外部生態合作,也有一個弊端。這裏的合作關係並不一定具備排他性,因此外部夥伴同樣可以選擇接入釘釘和飛書。
不過海豚君認爲,Workbuddy的機會在長期發展上會更加明顯:C端用戶使用數據的持續性積累,以及基於騰訊生態的獨特優勢——個人Agent數據與工作Agent數據打通,同時受益於AI時代下,OPC(一人公司)等單人生產力的社會發展趨勢。
2. 商業模式差異
各家生態的優劣勢差異,也使得AI辦公平臺的商業變現存在不同。目前因爲產品滲透率還不夠,雖然都保留了訂閱模式,但國內暫時還沒有一家指望單純靠辦公Agent賺錢,而是都要靠生態、傳統產品的捆綁。
目前來看,海豚君認爲,藉助現有商業模式更容易絲滑變現AI辦公價值的是:字節>阿里>騰訊。
但隨着更多數據資產的積累和上下文能力的提升,長期可看3000億元的國內AI辦公市場,仍然有望成爲互聯網巨頭在AI時代的低摩擦成本轉型的潤滑劑。
(1)阿里:變現最終落到“雲釘+MaaS”
阿里更偏向從已掌握的企業端採購部門入手,用雲產品捆綁+釘釘渠道,自上而下的拿下客戶,核心是提高釘釘用戶留存,然後通過賣企業席位、後端消耗Token和阿里雲資源等方式賺錢。
(2)騰訊:變現最終落到“生態抽佣+雲”
而騰訊的優勢就是C端流量,因此Workbuddy的導流不只靠企業微信,微信等其他生態也都是宣傳入口,同時目標白領用戶的外部投流也不少。正因“散客”用戶佔多數,Workbuddy更偏向訂閱,以及開放生態中的抽佣。
(3)字節:變現最終落到“企業IM+雲”
字節則採取中間路線,在將AI功能同時縫合進飛書做強原入口的同時,也採取了C端投流獲客的方式。在變現上,選擇與飛書、火山引擎的捆綁——飛書負責企業上下文和席位收入,火山負責算力和 Token 收入,豆包工作夾在中間提高客單價和粘性。
組織架構也順勢調整:飛書產品併入豆包,飛書銷售併入火山。一如火山的銷售風格,整體豆包工作的銷售策略也偏激進,購買火山算力的企業可以免費使用三週、100席以上的額度,隨後再進一步轉化爲付費用戶。
總結:AI辦公,傳統互聯網巨輪轉向的關鍵舵手
AI辦公市場足夠大(海豚君看遠期全球5000億美金+、中國450億美金的TAM),得益於AI能力的不斷延伸和滲透,相比個人助理可能更能迅速變現Token的價值。
現有互聯網巨頭,無論是出於短期AI ROI的壓力,還是出於長期轉型的需要,應該都不會放過這個領域的份額爭奪。
現階段,Workbuddy暫時擁有先發優勢。不過海豚君認爲,從核心要素層面(上下文、生態、商業模式)考慮,Workbuddy仍要補功課(模型性能+行業know-how),來延緩被追趕的時間。
千問辦公、豆包工作擁有不可小覷的追趕甚至超越能力,這不僅僅是比較用戶數,更多的是體現在與企業的深度捆綁。誰能積累更多的工作流程經驗等數據資產,誰才能擁有真正的持續性壁壘。
Workbuddy的獨特優勢則在於個人生活數據和工作數據的打通,但這個涉及到複雜的數據隔離、權限安全等軟硬件技術,因此更偏向長期的壁壘機會。
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露







