


OpenAI與微軟的版權之爭成爲對人工智能商業模式的一次考驗。



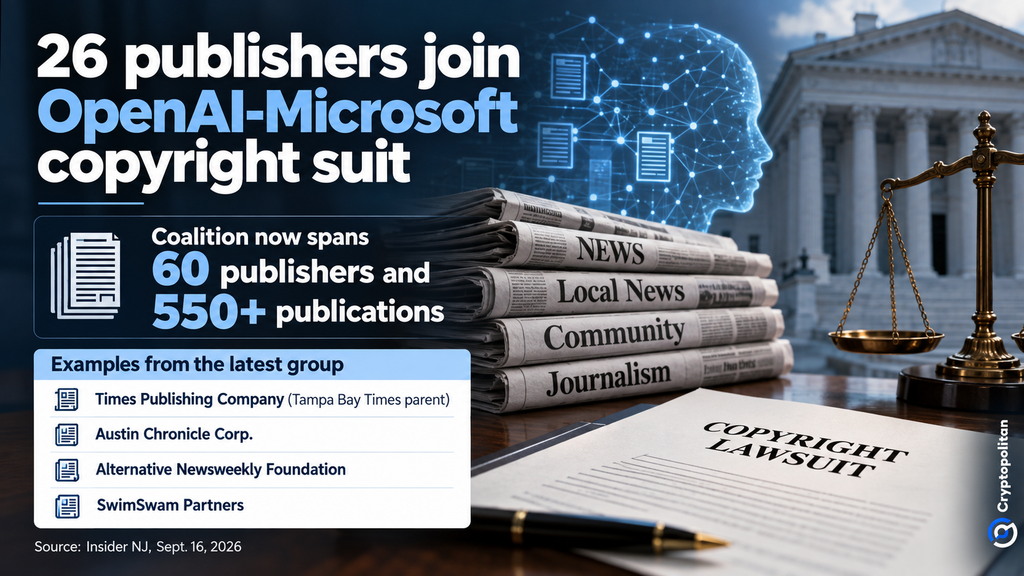
又有 26 家出版商 加入針對 OpenAI 和微軟的訴訟,使加入該聯盟的出版商總數超過 550 家,這使得此案成爲一起大規模案件,決定了生成式人工智能公司如何獲取和支付用於創建其產品的內容。
本案的核心問題是一個可能改變人工智能領域遊戲規則的根本性問題:在訓練大型語言模型時,如何界定使用受版權保護的材料纔算合理?答案可能影響許可成本、獲取高質量訓練數據的途徑,並最終決定哪些公司能夠參與競爭。.
一個不斷壯大的聯盟
據普拉特金律師事務所(Platkin LLP)稱,該事務所目前在訴訟中代表60家出版商。最新加入的出版商包括《坦帕灣時報》的母公司時代出版公司(Times Publishing Company)、奧斯汀紀事報公司(Austin Chronicle Corp.)、另類新聞週刊基金會(Alternative Newsweekly Foundation)以及SwimSwam Partners。.
出版商指責OpenAI和微軟未經許可或未支付任何經濟補償,擅自使用他們的作品開發盈利性人工智能產品,並刪除了版權數據,包括作者姓名和版權聲明。普拉特金認爲,這一聯盟的出現表明,出版商開始將這些行爲視爲不僅對版權保護的威脅,而且對新聞業本身的經濟也構成威脅。.
“這個聯盟的規模應該敲響警鐘。” ——馬特·普拉特金,普拉特金律師事務所合夥人
如今,這個問題在更多案件中被放大。Richner Communications 的案件已與 OpenAI 的訴訟合併,成爲一系列訴訟案中的一起,而其他出版商也在單獨提起訴訟。例如, 《西雅圖時報》和《新聞日報》起訴 OpenAI 和微軟,指控其未經授權使用其網站上的內容,包括用於 ChatGPT、Microsoft Copilot 和 Bing AI 等產品的付費內容。
爲什麼9月4日如此重要
9月4日,OpenAI公司版權侵權訴訟案中,雙方就簡易判決請求展開了激烈的辯論。版權所有者聲稱,OpenAI公司爲創建其模型而進行的複製行爲不能被歸類爲合理使用,並且會對現有市場和潛在的未來市場造成負面影響。而OpenAI和微軟則表示,根據人工智能與數字政策中心(Center for AI and Digital Policy)的。
如今,同樣的合理使用問題也引起了trac各方的意見。負責審理此案的紐約南區聯邦地區法院法官西德尼·H·斯坦邀請各方在10月16日前提交法庭之友意見陳述。 美國司法部 已於9月2日發表聲明,表示支持在人工智能訓練領域對“合理使用”一詞進行廣泛解釋,並警告稱強制許可可能會給小型公司帶來障礙。
並非所有裁決都與人工智能相悖。
法律形勢依然複雜。9月16日,OpenAI和微軟 在GitHub Copilot開發者訴訟案中取得部分勝利,上訴法院駁回了其中一項版權管理信息理論,但保留了其他訴訟請求。
美國 版權局 表示,人工智能訓練中的合理使用需視具體情況而定,取決於所使用的素材、獲取方式、複製原因及其對版權市場的影響。即使裁決有利於人工智能公司進行訓練,也未必能解決關於盜版或來源不當素材的爭議。
許可費用是多少?
版權所有局傾向於在國會考慮強制許可之前,先讓自願許可市場發展起來,同時承認大規模人工智能訓練材料的許可可能會帶來巨大的財務和後勤負擔。.
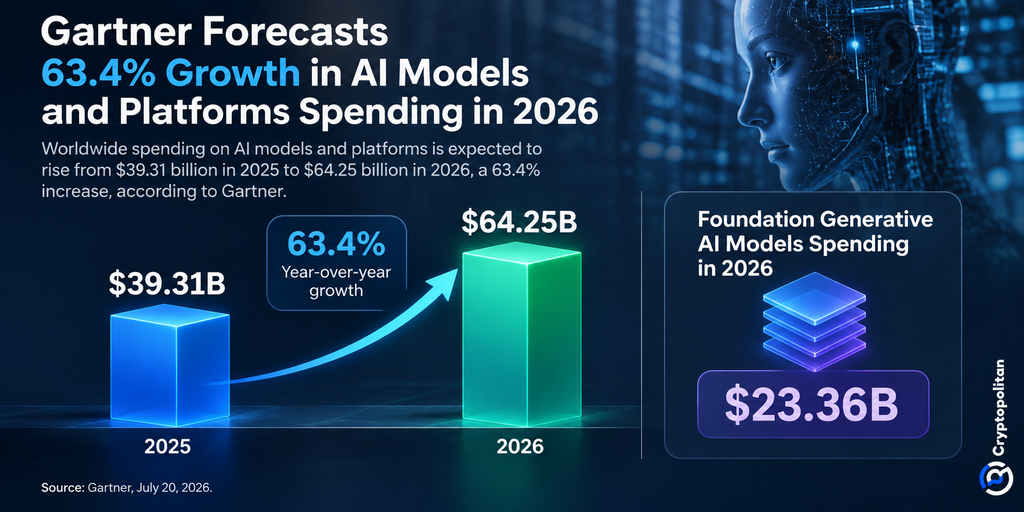
正因如此, Gartner 的預測 才顯得尤爲重要。全球人工智能模型和平臺的支出預計將從 2025 年的 393.1 億美元攀升至 2026 年的 642.5 億美元,增幅高達 63.4%。僅基礎生成式人工智能模型一項,預計支出就將達到 233.6 億美元。因此,任何轉向付費獲取培訓資料的舉措都將衝擊這個快速增長的市場,而數據成本在其中所佔的比例可能會大幅增加。
這些成本可能不會對所有人造成同等影響。 經合組織 表示,人工智能市場依然充滿活力,但警告稱,對數據、計算能力和雲基礎設施的集中獲取可能會增強現有企業的實力。受版權保護的訓練數據可能成爲另一項成本高昂的投入,而大型開發商更有能力承擔這部分成本。
這個問題也正變得日益全球化。在歐洲,歐盟的 通用人工智能法典 爲履行《人工智能法》的版權義務提供了一個框架。
挑戰在於如何在提高創作者報酬的同時,避免模型開發成本上升。法院如何劃定這tron界限,不僅將決定人工智能公司如何獲取訓練數據,還將決定這些成本究竟會擴大還是縮小能夠構建下一代模型的公司範圍。.
不要只是閱讀加密貨幣新聞,要理解它。訂閱我們的新聞簡報, 完全免費。








