拿 DSec 来套?Muse 如何真正撬动 CPU 需求


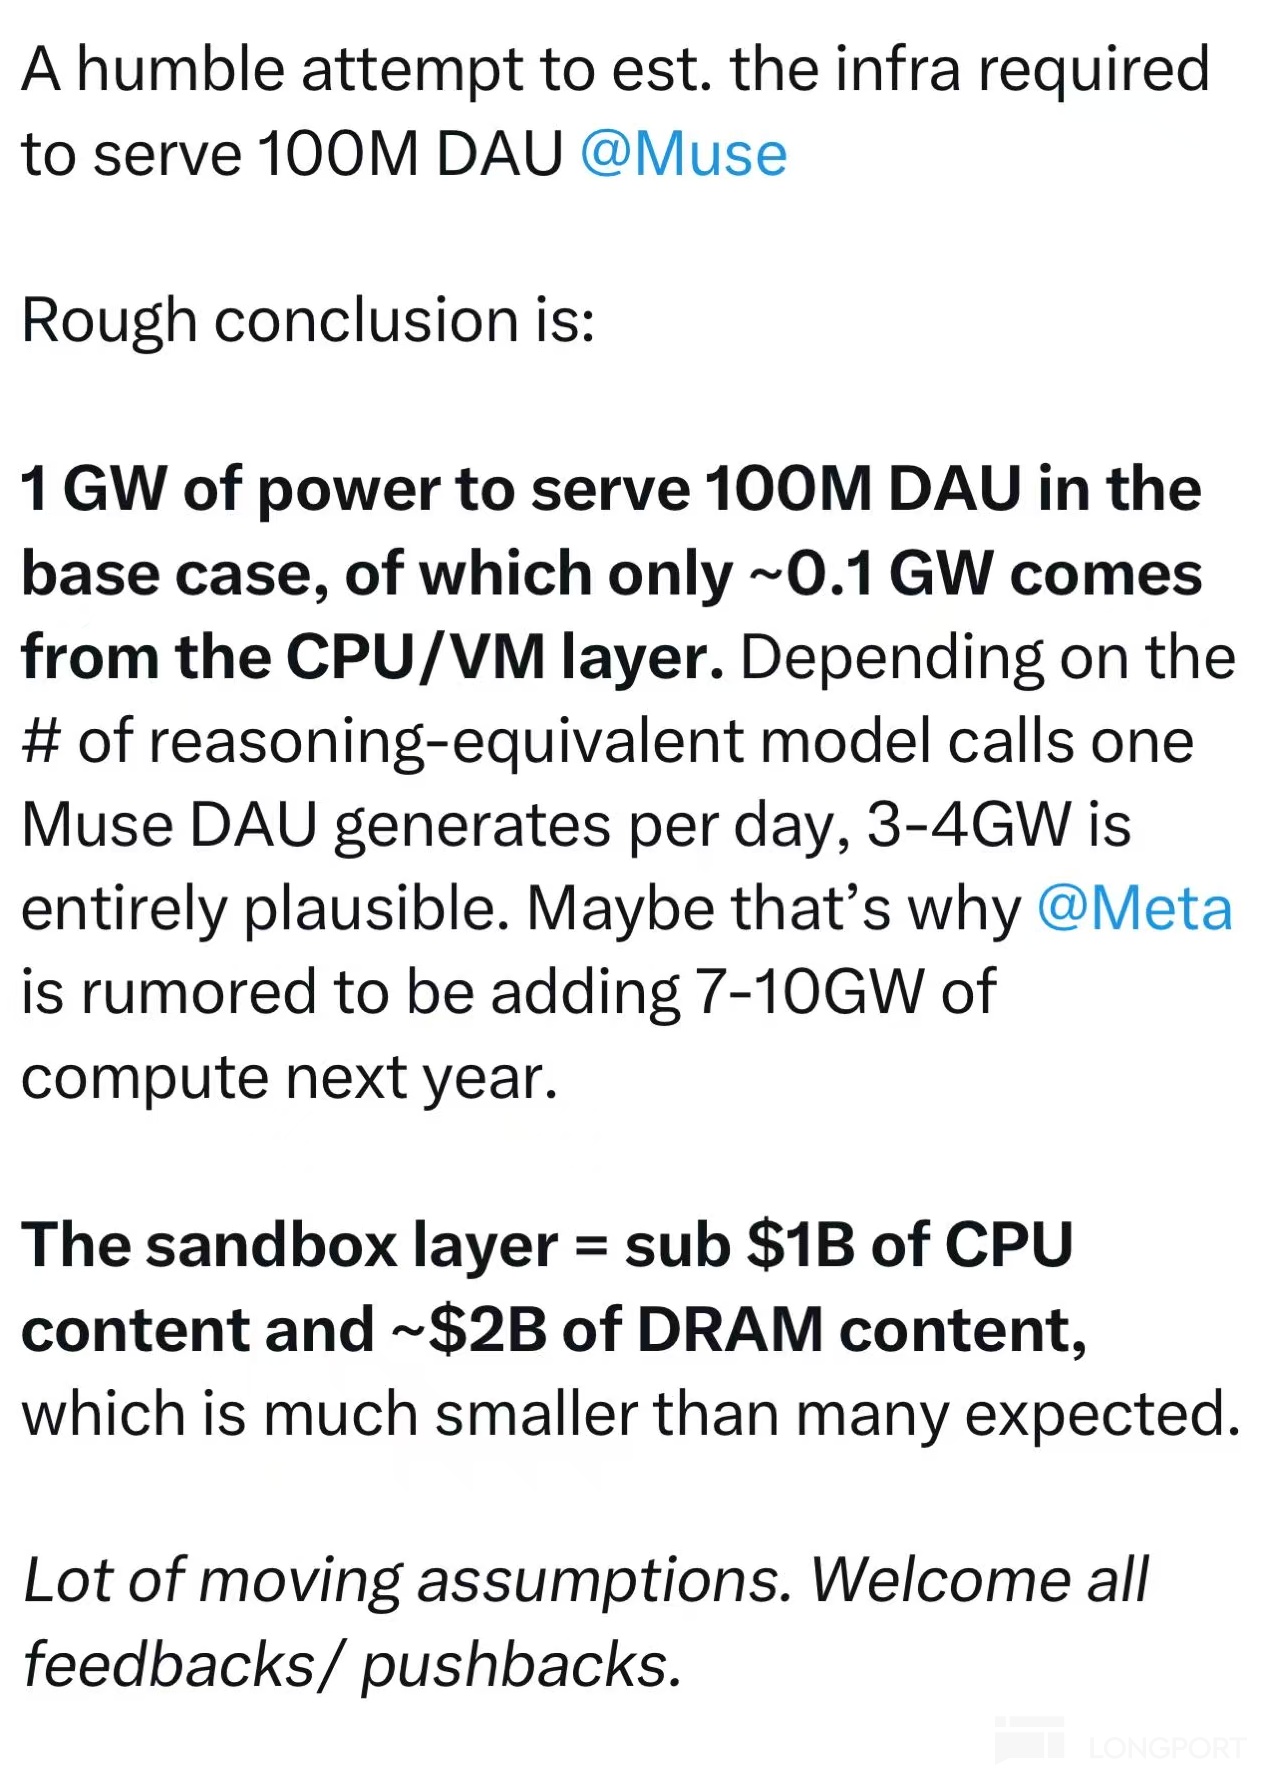
对于 Muse 对 CPU 的带动,X 上有人提到了不一样的观点,先来看看不一样的声音:
“基准情形下服务 1 亿 DAU 需要 1GW 电力,其中只有约 0.1GW 来自 CPU/VM 层。 取决于每个 Muse DAU 每天产生多少次推理等效模型调用,3 到 4GW 完全说得通。”
1.计算方式对比
首先我们来对比下计算方式:
Freda:“CPU 核数=DAU× (活跃时长/24)×峰均比×冗余系数×每 live VM 物理核数”;
海豚君:“CPU 核数=(A 头节点) GPU 出货量×每 GPU 头节点核数 + (B 固定层) 总注册用户 x 日活率 x(活跃时间/24)×每用户 2vCPUx 峰均比÷超售比÷ 2(单核两线程)+(C 弹性层)活跃用户×任务并发率×每任务沙箱核数”。
可以看出对方的测算中,并没有测算 A 头节点(GPU 侧)的 CPU 核数。当然这也能理解,这个也不能算 Agent CPU 带来的增量部分。
关键在于 Agent CPU 主要带来的部分,就是用户侧和 Agent 侧两部分,海豚君将其拆分成 B 固定层和 C 弹性层两块,而 Freda 的测算并没有进行拆分,而是直接用一个 live VM 物理核数来给设定。
2.概念的混淆性
Freda 的测算中,关键在于 live VM 物理核数的选定,她直接参照了 DSec。
原本提到 “DSec also demonstrates stable operation at around:800 microVMs per node.” 她测算的是,188 物理核/节点÷800microVMs/节点=0.23 物理核心 per live VM。
值得注意的是,DSec当时的设计目标是:当 Agent 需要执行代码、操作 shell、读写文件等工具时,按需创建microVM沙箱来隔离执行。因而这里的 microVM,实际上并不是用户数,而是沙箱数。之后再把这个数去乘以用户数,来测算整个规模明显是不对的。
另一方面,Freda 选用的 800 个 microVM 只是演示上限,按生产实测峰值表现为 524 个 micro VM,拿 188 物理核/节点÷524microVMs/节点=0.36 物理核心 per live VM,而不是给出的 0.23。
这两者只有在 “一个用户在峰值时恰好只持有一个沙箱” 时才相等。而 Muse 显然不是这样的,用户 VM 本机没有浏览器,broker 要去租另一台跑浏览器镜像的 VM。光这一条,一个正在浏览的 Muse 用户就至少占两个沙箱。
这么看来,Freda 只是测算了 C(弹性层)的部分,并未测算 A 头节点(GPU 侧)和 B 固定层(用户侧)的 CPU 核需求。
3. 不合适的参照对象
当然,C(弹性层)本身也是 Agentic AI 需求的主要增长来源,姑且来看这部分:
DSec 和 Muse 本身就是不同的,拿着 DSec 来参照也不太合适。DSec 是 DeepSeek 用来跑代码执行的沙箱:跑一段代码、返回结果、销毁;而 Muse 的沙箱是常驻的个人计算机:带浏览器、带持久记忆、带 Chromium 多进程调度、关掉 App 还在跑。
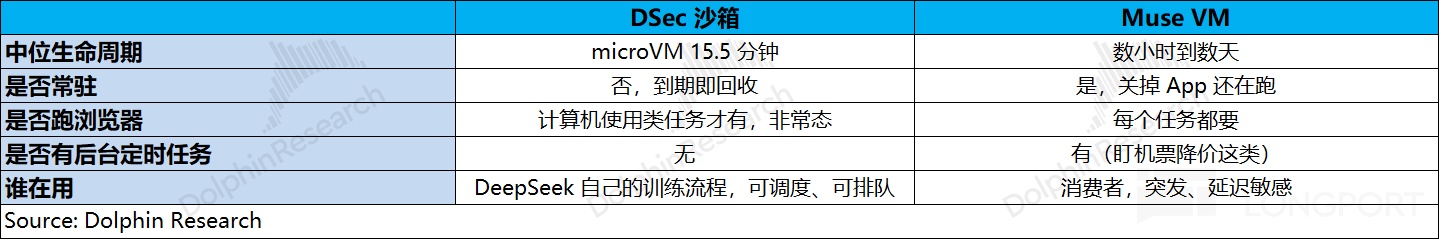
Freda 的整条逻辑建立在 “90% 的沙箱平均只用不超过申请 CPU 的 5%"这个实测上。但这个 5% 是在 DSec 的负载构成下测的,是被大量 “跑脚本、编译、跑测试” 稀释出来的均值,不是浏览器负载的占空比。
Muse 是完全不一样的。一次跨平台比价可能触发多达 146 次页面加载,而每次页面加载都是完整的 HTML 解析 +JavaScript 执行 +DOM 构建 + 渲染。Chromium 的 JS 主线程是单线程且 CPU-bound 的,一个现代商旅页面的渲染要占满一个核好几秒。
本身单个客户不一定只有 1 个任务,因而海豚君在 C(弹性层)中引入了并发率的概念(情景假设),即对应单个活跃客户的平均任务数(1 个任务对应 1 个并发沙箱),这部分要关注后续 Muse 等 Agent 的使用情况。
对于 C(弹性层)的测算,在 1 亿 Muse 用户(日活 30%)、每天活跃 3 小时、峰均比 2 的情况下,假定每个任务沙箱需要的 CPU 核数为 1.5 个(此前的 4 个是参照 NemoClaw 的配额上限),以并发率来做情景假设:其中峰值活跃达到 750 万(=1 亿 x30%x3/24x2)
中性情况对应着并发率=150%(从此前的 100% 上调),即单个活跃客户平均有 1.5 个任务。如果单个 CPU 机架和 GPU 机架均为 200kW ,CPU 机架的占比下调至在 15% 的情况下(此前假定占比 25%),对应着 1GW 的配套工厂。
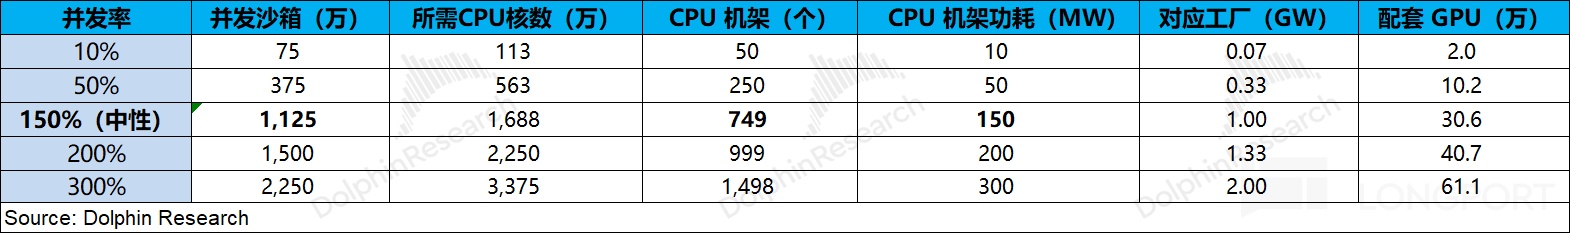
在这情况下,单 GW 对应的 CPU 核需求量=A(GPU 侧)1836 万个(=30.6*60)+B(固定层)188 万个(=1 亿 x30%x3/24x2x2/4/2)+C(弹性层)1688 万个=3712 万个,大约是原来纯 GPU 机架方案的 2 倍左右(相比于 1836 万个)。
在调低单个任务沙箱需要的 CPU 核数的情况下,也相应的调低了 CPU 配比情况,对应着 CPU 需求倍数从 3 倍调整至 2 倍,仍远高于 Freda 的预测。考虑到英伟达存储机架(DPU)等部分的额外需求,海豚君预估 Agentic CPU 有望带动 CPU 核数需求仍会达到 2 倍以上。
整体来看,这份 Freda 的测算中混淆了 microVM(任务沙箱)和用户的概念,她的计算中仅仅计算了 C 弹性层的一部分,并且在计算过程中参照的 DSec 和 Muse 的方式本身就有很大的不同,这样的参考是明显不合适的。
<此处结束>
2026/09/29 CPU 热评《Muse“爆火”,CPU 迎来自己的 ChatGPT 时刻?》
本文的风险披露与声明:海豚研究免责声明及一般披露