


SpaceX AI เปิดตัว Grok 4.7: เจเนอเรชันระดับเรือธงสำหรับการเขียนโค้ดและงานด้านความรู้ ในราคาเท่ากับ Grok 4.6



พอดแคสต์ AI


SpaceXAI เปิดตัว Grok 4.7 โดยคงราคาและความเร็วเท่ากับรุ่นก่อนหน้า พร้อมยกระดับความสามารถในการเขียนโค้ด งานประมวลผลความรู้ และการสร้างเอกสาร โมเดลนี้โดดเด่นด้านความคุ้มค่าต่อราคาบน CursorBench 4.0 และทำคะแนนสูงสุดในเกณฑ์มาตรฐานด้านกฎหมายและความปลอดภัยทางชีวภาพ การฝึกอบรมด้วยการเรียนรู้แบบเสริมกำลังช่วยเพิ่มประสิทธิภาพการตรวจสอบตนเองและการจัดการบริบท ด้านความปลอดภัยได้ถูกยกระดับใหม่เพื่อป้องกันคำขออันตราย พร้อมรองรับการย้ายระบบโดยไม่มีต้นทุนเพิ่ม

TradingKey - SpaceXAI (แผนก AI ของ SPXC ซึ่งเดิมคือ xAI) ได้เปิดตัว Grok 4.7 เมื่อวันที่ 21 กันยายน โดยวางตำแหน่งอย่างเป็นทางการให้เป็นรุ่นโมเดลที่มีความสามารถสูงสุดจนถึงปัจจุบันสำหรับงานเขียนโค้ดและงานประมวลผลความรู้ ส่วนการกำหนดราคายังคงสอดคล้องกับ Grok 4.6 อยู่ที่ 2 ดอลลาร์ต่อ 1 ล้านอินพุตโทเคน และ 6 ดอลลาร์ต่อ 1 ล้านเอาต์พุตโทเคน สำหรับ CursorBench 4.0 ซึ่งประเมินงานเขียนโค้ดระยะยาวโดยเฉพาะ Grok 4.7 ทำคะแนนได้ 46.3% ซึ่งสูงกว่า Grok 4.6 อยู่ 5.9 จุดเปอร์เซ็นต์ โดยคำกล่าวอ้างอย่างเป็นทางการจัดให้อยู่ในระดับแนวหน้าด้านความคุ้มค่าต่อราคาภายในระดับราคาเดียวกันบนเกณฑ์มาตรฐานนี้
ในช่วงสองปีที่ผ่านมา การเพิ่มขีดความสามารถในโมเดลเรือธงมักจะจบลงด้วยราคาต่อหน่วยโทเคนที่สูงขึ้น ได้แก่ การอัปเกรดข้ามรุ่น การปรับขึ้นราคา แล้วจึงรอให้อุตสาหกรรมค่อย ๆ แบกรับต้นทุนการรันโมเดล (inference) แต่ Grok 4.7 เลือกเส้นทางที่แตกต่างออกไป โดยในขณะที่ยกระดับความสามารถให้สูงขึ้น แต่ราคาและความเร็วในการรันโมเดลยังคงอยู่ที่ระดับเดียวกับ Grok 4.6 พร้อมด้วยเวอร์ชันความเร็วสูง (fast version) เพิ่มเติมที่เพิ่มความเร็วในการส่งออกข้อมูลเป็นสองเท่า
รายละเอียดที่เปิดเผยอย่างเป็นทางการมุ่งเน้นใน 4 ด้าน ได้แก่ การเปลี่ยนแปลงของโมเดลฐานและการฝึกอบรมการเรียนรู้แบบเสริมกำลัง (reinforcement learning) การเปรียบเทียบในแนวนอนและแนวตั้งใน 7 เกณฑ์มาตรฐาน โครงสร้างต้นทุนภายใต้ภารกิจระยะยาว และการเขียนสแต็กแนวทางความปลอดภัย (safety guardrail) ขึ้นใหม่ทั้งหมด นอกจากนี้ โมเดลดังกล่าวยังพร้อมใช้งานพร้อมกันทันทีทั้งบน Cursor, Grok Build, Grok API รวมถึงเฟรมเวิร์กการเขียนโค้ดและแพลตฟอร์มเส้นทางโมเดล (model routing) ของบุคคลที่สาม
คุณค่าหลักของ Grok 4.7 มุ่งเน้นไปที่ความสามารถ 3 ด้าน ได้แก่ การเขียนโค้ดสำหรับงานระยะยาว การสร้างเอกสารระดับมืออาชีพ และแนวทางความปลอดภัย โดยทั้งสามส่วนใช้โครงสร้างราคาเดียวกัน นั่นคือเสนอราคาและความเร็วเท่ากับรุ่นก่อนหน้า ขณะเดียวกันก็ใช้เวอร์ชันความเร็วสูงเพื่อครอบคลุมสถานการณ์ที่ไวต่อความหน่วง
เกณฑ์มาตรฐานอย่างเป็นทางการบ่งชี้ว่าความก้าวหน้าของโมเดลรุ่นนี้เกิดขึ้นอย่างต่อเนื่อง โดย CursorBench 4.0 ปรับตัวดีขึ้น 5.9 จุดเปอร์เซ็นต์ Terminal-Bench 4.0 เพิ่มขึ้นเกือบสองเท่า AA Briefcase ทำคะแนนเพิ่มขึ้น 111 คะแนน และยังทำคะแนนได้สูงสุดของบริษัทในเกณฑ์มาตรฐานด้านความปลอดภัยทางชีวภาพ ขณะเดียวกัน ระดับสัมบูรณ์ที่ 19.6% บนเกณฑ์มาตรฐานด้านกฎหมายและการนำหน้าใน 4 เกณฑ์มาตรฐานของ Fable 5.1 แสดงให้เห็นว่านี่ยังคงเป็นการแข่งขันที่มีทั้งแพ้และชนะของทั้งสองฝ่าย มากกว่าจะเป็นการทดแทนฝ่ายเดียวอย่างเบ็ดเสร็จ
ราคาและความเร็วยังคงไม่เปลี่ยนแปลง
Grok 4.7 มีราคาเริ่มต้นที่ 2 ดอลลาร์ต่อ 1 ล้านอินพุตโทเคน และ 6 ดอลลาร์ต่อ 1 ล้านเอาต์พุตโทเคน ซึ่งเท่ากับ Grok 4.6 โดยยังคงความเร็วในการประมวลผลเท่าเดิม นอกจากนี้ ยังมีเวอร์ชันเร็วอย่างเป็นทางการที่เพิ่มความเร็วเอาต์พุตเป็นสองเท่าของเวอร์ชันมาตรฐานในราคาเป็นสองเท่า
ระดับราคานี้ถือว่าอยู่ในเกณฑ์ต่ำเมื่อเทียบกับโมเดลในระดับเดียวกัน เมื่อเปรียบเทียบกันแล้ว GPT-5.6 Sol มีราคา 4 ดอลลาร์สำหรับอินพุต และ 20 ดอลลาร์สำหรับเอาต์พุตในระดับสูงสุด ขณะที่ Fable 5.1 มีราคา 10 ดอลลาร์สำหรับอินพุต และ 50 ดอลลาร์สำหรับเอาต์พุตในระดับสูงสุด หากเปรียบเทียบเฉพาะราคาต่อหน่วยของเอาต์พุต Grok 4.7 มีราคาประมาณหนึ่งในสามของโมเดลแรก และประมาณหนึ่งในแปดของโมเดลหลัง
ผลกระทบในทางปฏิบัติของการคงราคาเดิมไว้คือต้นทุนการย้ายระบบที่สามารถควบคุมได้ ทีมงานที่ใช้ Grok 4.6 อยู่แล้วสามารถสลับโมเดลได้โดยตรงใน Cursor หรือ Grok Build และดำเนินการทดสอบเปรียบเทียบกับชุดงานที่มีอยู่ โดยไม่จำเป็นต้องเปลี่ยนแปลง API หรือวิธีการเรียกใช้งาน
การปรับปรุงแบบจำลอง
ขั้นตอนการเรียนรู้แบบเสริมกำลัง (reinforcement learning) สำหรับ Grok 4.7 ยังใช้เวลาในการฝึกฝนที่ยาวนานขึ้น โดยระดับความยากโดยรวมของงานฝึกฝนปรับตัวสูงขึ้น และมีการให้น้ำหนักไปที่ปัญหาที่ต้องใช้เวลาหลายชั่วโมงในการแก้ ผลลัพธ์โดยตรงอย่างเป็นทางการคือโมเดลสามารถตรวจสอบผลลัพธ์ของตัวเองได้ดีขึ้น และจัดการกับบริบทที่มีความยาวได้ดีขึ้น
การเปลี่ยนแปลงอีกประการหนึ่งเกิดขึ้นในเป้าหมายของการฝึกฝน โดย Grok 4.7 ได้รับการฝึกฝนให้เข้าใจระบบโครงสร้างของ Grok Bot ได้โดยตรงในตัว ส่งผลให้การทำงานในด้านการสนทนาและงานความรู้ทั่วไปมีประสิทธิภาพดียิ่งขึ้น ทั้งนี้ SpaceXAI ได้เปิดตัว Grok Bot เมื่อวันที่ 11 สิงหาคม โดยอธิบายว่าเป็นชุดเอเจนต์ที่ทำงานอย่างต่อเนื่อง ซึ่งแต่ละเอเจนต์มีคอมพิวเตอร์เป็นของตัวเอง และสามารถทำงานภายในเครื่องมือและแอปพลิเคชันต่าง ๆ ได้
ความสามารถในการสร้างเอกสารและงานนำเสนอก็ได้รับการเน้นย้ำแยกต่างหากเช่นกัน โดยอย่างเป็นทางการแล้ว Grok 4.7 แสดงให้เห็นถึงการพัฒนาอย่างเห็นได้ชัดเมื่อเทียบกับ Grok 4.6 ในผลลัพธ์ทั้งสองประเภท และทำงานได้ในระดับเดียวกับโมเดลระดับแนวหน้า (frontier models) อื่น ๆ
ตารางสรุปผล 7 ดัชนีอ้างอิง
Grok 4.7 ทำผลงานได้ดีขึ้นในการสร้างเอกสารและงานนำเสนอ ในการทดสอบ GDPval และ AA Briefcase นั้น AI จำเป็นต้องปฏิบัติงานของมืออาชีพ เช่น ทนายความ พยาบาล และนักวิเคราะห์การเงิน โดย Grok 4.7 ทำผลงานได้เหนือกว่า Grok 4.6 ในการทดสอบเกณฑ์มาตรฐานทั้งสองรายการ และบรรลุประสิทธิภาพในระดับทัดเทียมกับโมเดลระดับแนวหน้าอื่น ๆ
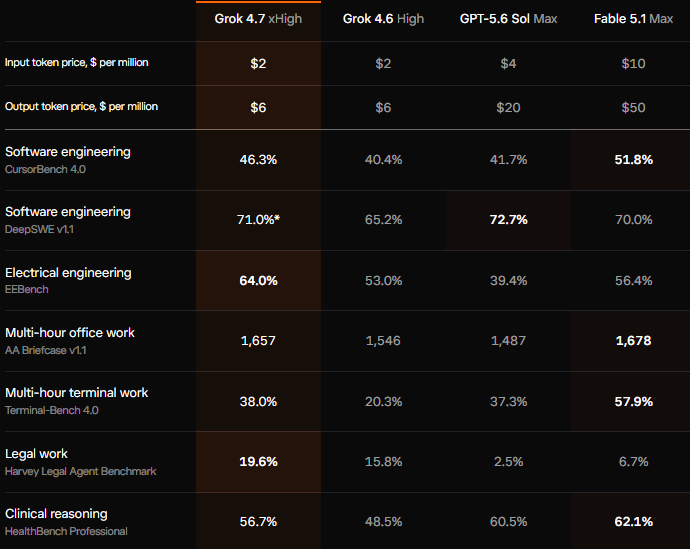
[ตารางเปรียบเทียบอย่างเป็นทางการ ซึ่งครอบคลุมการเขียนโค้ด การปฏิบัติการเทอร์มินัล วิศวกรรมไฟฟ้า กฎหมาย การให้เหตุผลเชิงคลินิก และงานสำนักงาน ที่มา: x.ai]
ด้านกฎหมายและการปฏิบัติการเทอร์มินัลมีการปรับตัวดีขึ้นมากที่สุด โดยในการทดสอบเกณฑ์มาตรฐาน Harvey Legal Agent นั้น Grok 4.7 ทำคะแนนได้ 19.6% ซึ่งสูงที่สุดในกลุ่มนี้ ขณะที่ GPT-5.6 Sol ทำคะแนนได้เพียง 2.5% ส่วนในการทดสอบ Terminal-Bench 4.0 นั้น Grok 4.7 พุ่งขึ้นจากระดับ 20.3% ของ Grok 4.6 มาอยู่ที่ 38.0% หรือเพิ่มขึ้นเกือบเท่าตัว นอกจากนี้ การให้เหตุผลเชิงคลินิกปรับตัวดีขึ้น 8.2 จุดเปอร์เซ็นต์ และคะแนนด้านงานสำนักงานเพิ่มขึ้น 111 คะแนน
เส้นโค้งต้นทุนภายใต้งานระยะยาว
หน้าอย่างเป็นทางการของ CursorBench 4.0 แสดงแผนภูมิสามชุดเคียงข้างกัน ได้แก่ ต้นทุนเฉลี่ยต่อภารกิจ โทเค็นผลลัพธ์เฉลี่ย และจำนวนขั้นตอนเฉลี่ย โดยแกนตั้งได้รับการปรับให้เป็นมาตรฐานตามชุดคะแนนเดียวกัน จุดอ้างอิงในแผนภูมิถูกทำเครื่องหมายไว้ที่ Sonnet 5 (การตั้งค่าเริ่มต้นระดับสูง): คะแนน 30.8%, 3.48 ดอลลาร์ต่อภารกิจ, โทเค็นผลลัพธ์ประมาณ 61,000 โทเค็น และ 85 ขั้นตอน ซึ่งทำหน้าที่เป็นเกณฑ์มาตรฐานสำหรับการเปรียบเทียบความคุ้มค่าด้านต้นทุน
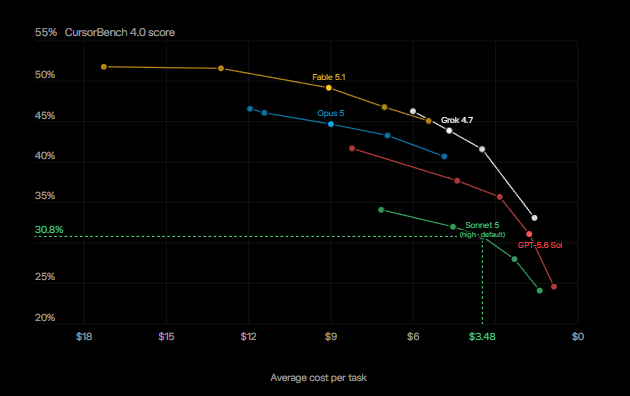
[ที่มา: X.ai]
เมื่อพิจารณาจากเส้นโค้งต้นทุน Fable 5.1 ทำคะแนนได้สูงที่สุด ด้วยต้นทุนเกือบ 18 ดอลลาร์ต่อภารกิจ ขณะที่ GPT-5.6 Sol อยู่ในฝั่งต้นทุนต่ำ โดยคะแนนลดลงอย่างรวดเร็วยิ่งขึ้นเมื่อต้นทุนลดลง ด้าน Grok 4.7 อยู่ระหว่างสองโมเดลดังกล่าว โดยคำอ้างอย่างเป็นทางการระบุว่าอยู่นำหน้าในด้านประสิทธิภาพต่อราคาบนเกณฑ์มาตรฐานนี้ รูปทรงของแผนภูมิโทเค็นผลลัพธ์และจำนวนขั้นตอนสะท้อนแบบเดียวกับแผนภูมิต้นทุน ซึ่งแสดงให้เห็นว่าความแตกต่างของต้นทุนส่วนใหญ่มาจากความยาวในการใช้เหตุผลที่จำเป็นในการทำภารกิจให้สำเร็จ มากกว่าตัวราคาต่อหน่วยเอง
ลองจินตนาการถึงทีมแบ็กเอนด์จำนวน 6 คนที่กำลังย้ายระบบบริการขนาด 400,000 บรรทัดจากเฟรมเวิร์กเก่าไปยังเฟรมเวิร์กใหม่ การแบ่งภารกิจประเภทนี้ออกเป็นคอมมิตทีละขั้นตอนนั้นไม่มีความหมาย โมเดลจะต้องทำงานอย่างต่อเนื่องเป็นเวลาหลายชั่วโมงและตรวจสอบผลลัพธ์ของขั้นตอนก่อนหน้าด้วยตัวเองระหว่างทาง ซึ่งเป็นสถานการณ์จริงที่ CursorBench 4.0 และ Terminal-Bench 4.0 ต้องการวัดผล ต่อเมื่อต้นทุนต่อภารกิจลดลงจากมากกว่าสิบดอลลาร์เหลือเพียงไม่กี่ดอลลาร์เท่านั้น ทีมจึงมีแนวโน้มที่จะจัดให้อยู่ในตารางงานประจำวัน แทนที่จะรอประมวลผลแบบเป็นชุดในช่วงวันหยุดสุดสัปดาห์
ความปลอดภัยและความปลอดภัยทางไซเบอร์
Grok 4.7 ใช้ระบบความปลอดภัยใหม่ทั้งหมด โดยได้รับการอธิบายอย่างเป็นทางการว่าเป็นโมเดลที่แข็งแกร่งที่สุดเท่าที่บริษัทเคยทดสอบมา ทั้งในด้านอัตราการปฏิเสธคำขอและการต้านทานการเจาะระบบความปลอดภัย (jailbreak)
ในขอบเขตเทคโนโลยีที่ใช้งานได้สองทาง (dual-use) เช่น ความปลอดภัยทางไซเบอร์และความปลอดภัยทางชีวภาพ ข้อมูลอย่างเป็นทางการครอบคลุมทั้งสองด้าน ได้แก่ การรักษาความสามารถในการใช้งานสำหรับภารกิจที่ถูกต้องตามกฎหมาย ควบคู่ไปกับการปฏิเสธคำขอที่เป็นอันตราย โดยในด้านความปลอดภัยทางชีวภาพ Grok 4.7 ทำคะแนนได้ 62.4% ในเกณฑ์มาตรฐานความปลอดภัยทางชีวภาพ LatchBio ซึ่งเป็นคะแนนที่สูงที่สุดในเกณฑ์มาตรฐานนี้ ส่วนในด้านความปลอดภัยทางไซเบอร์ เกณฑ์มาตรฐาน HackerBench v0.3 ที่พัฒนาขึ้นเองภายในบริษัทแสดงให้เห็นว่า โมเดลนี้อนุญาตพรอมต์การใช้งานสองทางที่มีความเสี่ยงสูงเพียง 3.3% เท่านั้น ขณะเดียวกันก็แทบจะไม่ปิดกั้นการวิจัยด้านความปลอดภัยที่ถูกต้องตามกฎหมาย
นอกจากนี้ SpaceXAI ยังระบุว่า ได้เริ่มเสนอการเข้าถึงศักยภาพด้าน Red Teaming ของ Grok 4.7 เฉพาะผู้ที่ได้รับเชิญเท่านั้น แก่พันธมิตรด้านความปลอดภัยทางไซเบอร์ที่ได้รับคัดเลือก เพื่อใช้สำหรับการวิจัยเชิงป้องกัน
เนื้อหานี้ได้รับการแปลโดยปัญญาประดิษฐ์ (AI) และผ่านตรวจสอบโดยมนุษย์ มีไว้เพื่อการอ้างอิงและข้อมูลทั่วไปเท่านั้น ไม่ใช่การแนะนำการลงทุนแต่อย่างใด
บทความแนะนำ






ความคิดเห็น (0)
คลิกปุ่ม $ ป้อนสัญลักษณ์ และเลือกเพื่อเชื่อมโยงหุ้น, กองทุน ETF หรือสัญลักษณ์หลักทรัพย์อื่น ๆ