


O Grok 4.7 da xAI supera os modelos da Anthropic e da OpenAI no trabalho dos agentes jurídicos por menos


A xAI lançou o Grok 4.7 na segunda-feira. Superou o Fable 5.1 da Anthropic e o GPT-5.6 Sol da OpenAI num teste de benchmark de agentes legais, cobrando um quinto do preço do Fable por token de entrada.
A produção ronda os 6 dólares por milhão de tokens, contra os 50 dólares na Anthropic
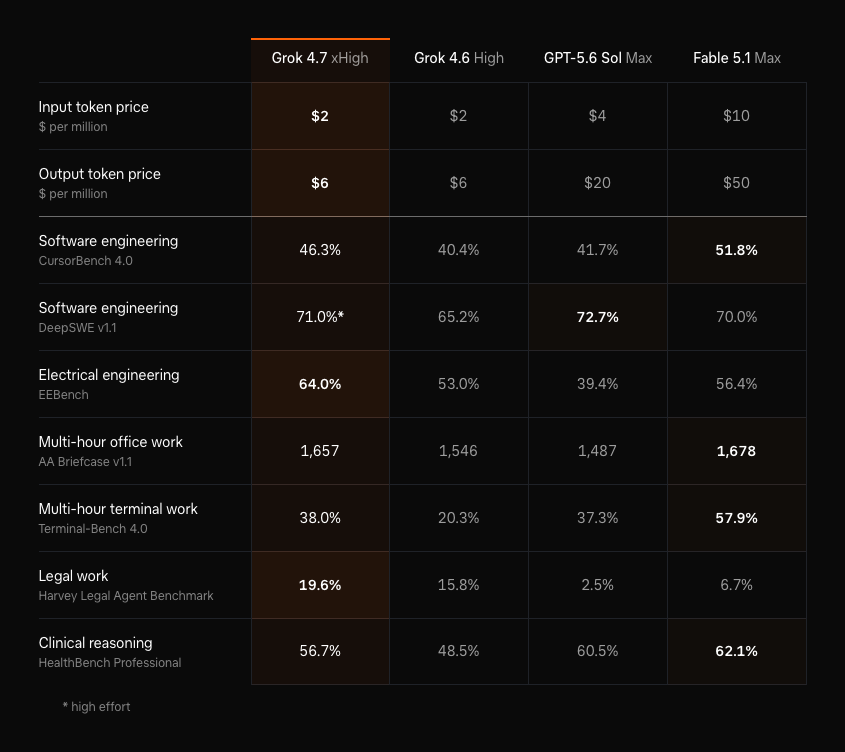
O comunicado da xAI informou que o Grok 4.7 obteve 19,6% no teste Harvey Legal Agent Benchmark. O Fable 5.1 alcançou 6,7% no mesmo teste e o GPT-5.6 Sol, 2,5%.
Isto coloca o Grok 4.7 com cerca de três vezes a pontuação do Anthropic e quase oito vezes a do Sol. Cryptopolitan noticiou no mês passado que o Grok 4.6 já liderava esta dupla com 15,8%.
O trabalho jurídico é um dos poucos domínios em que o Grok 4.7 supera completamente os seus dois concorrentes. Também supera o Fable 5.1 no teste de engenharia elétrica do EEBench e ultrapassa-o ligeiramente no teste de programação DeepSWE.
O preço do Grok 4.7 é de 2 dólares por milhão de tokens de entrada e 6 dólares por milhão de tokens de saída, o mesmo que o do Grok 4.6. Esta taxa de entrada é metade da taxa de 4 dólares do GPT-5.6 Sol e um quinto da taxa de 10 dólares do Fable 5.1.
O preço de saída é de 6 dólares, contra 20 dólares para Sol e 50 dólares para Fable, cerca de um oitavo do valor cobrado por Anthropic.
A xAI comparou os resultados do CursorBench 4.0 com o custo médio por tarefa concluída e afirma que o modelo se encontra na fronteira entre o custo e o desempenho. O Grok 4.7 atinge cerca de 46% neste gráfico a um custo de aproximadamente 6 dólares por tarefa, enquanto o Claude Opus 5 exige um investimento quase duas vezes superior para um resultado semelhante.
O Fable 5.1 tem um melhor desempenho com orçamentos mais elevados, atingindo os 51,8% com cerca de 17 dólares por tarefa. O lançamento foi "uma combinaçãotronde inteligência, velocidade e baixo custo", disse Musk no X.
O Terminal-Bench 4.0 dá à Anthropic uma vantagem de 57,9% contra 38,0%
O Grok 4.7 ficou em segundo lugar, atrás do Fable 5.1, no GDPval e no teste de trabalho de escritório AA Briefcase. O modelo da Anthropic mantém uma clara vantagem em testes de codificação mais longos e benchmarks de terminal.
A margem mais elevada foi observada no Terminal-Bench 4.0, onde o Fable 5.1 obteve 57,9% contra 38,0% no Grok 4.7, uma diferença de cerca de 20 pontos percentuais.
O Fable também lidera no CursorBench e no raciocínio clínico do HealthBench Professional, onde o GPT-5.6 Sol também supera o Grok.
O Grok 4.7 alcançou 1.695 pontos Elo no GDPval, que avalia modelos em tarefas realizadas por advogados, enfermeiros e analistas financeiros, um aumento face aos 1.605 pontos do Grok 4.6. Este resultado fica atrás dos 1.735 pontos do Fable 5.1, mas à frente dos 1.542 pontos obtidos pelo GPT-6 Astra, da OpenAI, na mesma avaliação.
O Grok 4.7 supera o GPT-5.6 Sol em cinco dos sete benchmarks. Perde apenas no DeepSWE e no ensaio clínico.
O Grok 4.7 utiliza 2,1 triliões de parâmetros, mais 40% do que os 1,5 triliões do Grok 4.6. A xAI incluiu dados de treino suplementares da SpaceX, incluindo telemetria do satélite Starlink e registos de fabrico.
A empresa afirma que o modelo tem maior probabilidade de dedicar tempo extra a problemas complexos e de verificar as suas próprias respostas do que o Grok 4.6.
O modelo foi lançado na aplicação Grok, Cursor, Grok Build e na API xAI, sem lista de espera.
Todos os números aqui apresentados são provenientes dos testes realizados pela própria xAI. O CursorBench, o teste principal da xAI, é desenvolvido pela Cursor, empresa que a SpaceX concluiu a aquisição no mês passado.
O xAI foi comparado com o GPT-5.6 Sol, e o GPT-6 Astra, mais recente da OpenAI, apenas aparece nos gráficos GDPval, AA Briefcase e EEBench.
Não se limite a ler notícias sobre criptomoedas. Compreenda-as. Assine nossa newsletter. É grátis.
Artigos recomendados







Comentários (0)
Clique no botão $, digite o código do ativo e selecione para vincular uma ação, ETF ou outro ticker.