


叫板英偉達霸權,谷歌 “光網” 憑什麼?


海豚君上一篇中比對了兩家專門給別人賣GPU廠商,也就是3P GPU——$英偉達(NVDA.US) 和$AMD(AMD.US) 的數據中心組網競爭:
硬超英偉達GB300,AMD好不容易用博通的交換機把 Scale-up從8 卡堆到了 72 卡,做出來了Helios,但出貨時的對手已變成了Vera Rubin,結果追平了GPU互聯帶寬,但成本經濟性太差,而工程設計已經落後。
AMD 是邁過了及格線,但頗有種“拿前朝劍斬本朝官”的無力感。海豚君認爲核心原因是其自研全棧的缺失。那麼,把自研做到另一種極致是怎樣的呢?
本篇將轉向自研自用1P ASIC上的組網龍頭——CSP巨頭$谷歌-A(GOOGL.US) ,粗看它的組網會發現:
一. Scale-Up域極龐大,接近萬卡,作爲對比,Vera Rubin, Helios僅72卡;
二.拓撲極特別,採用直連而非辦公區(計算托盤)+調度室(交換托盤)=辦公樓(機架)的交換式,是全網獨一份的OCS交換機方案;
三是組網成本相對便宜,這當然歸功於以上兩點。
接下來,海豚君沿着這三個特點往下挖,研究下谷歌:
一、近萬卡的Scale-Up域是如何實現的?
二、直連拓撲從v7到v8是如何演進的?
三、轉向TPU-aaS商業模式後,谷歌方案有競爭力嗎?
四、產業鏈上有哪些核心標的?
正文如下:
一、近萬卡的Scale-Up域是如何實現的?
我們將以目前大規模部署的Ironwood v7作爲基準。
1、互連協議:ICI撐起半片天
1)Pod內Scale-Up:走光、走電都是ICI
谷歌自研了專有的TPU間互連協議ICI(Inter-chip Interconnection,對標NVLink與UALink)。v8代際單TPU間聚合雙向帶寬2,400GB/s,相較v7代際1,200GB/s翻番(vs 英偉達3.6TB/s)。
Vera Rubin、Helios的方案中恰好是"一種協議、搭一種傳輸介質、搭櫃內(外)",容易讓人誤以爲三者是互相綁定的,但首篇已經說過,Scale-Up與Scale-Out的劃分是基於通信語義而非物理形態。
而谷歌恰恰如此,在一定量TPU的Pod內,TPU間連接無論是否出櫃、用光或電,都走ICI協議;只有超出這一規模,才切換到基於以太網的傳統DCN協議。
2)跨Pod Scale-Out:“打醬油”的Jupiter DCN
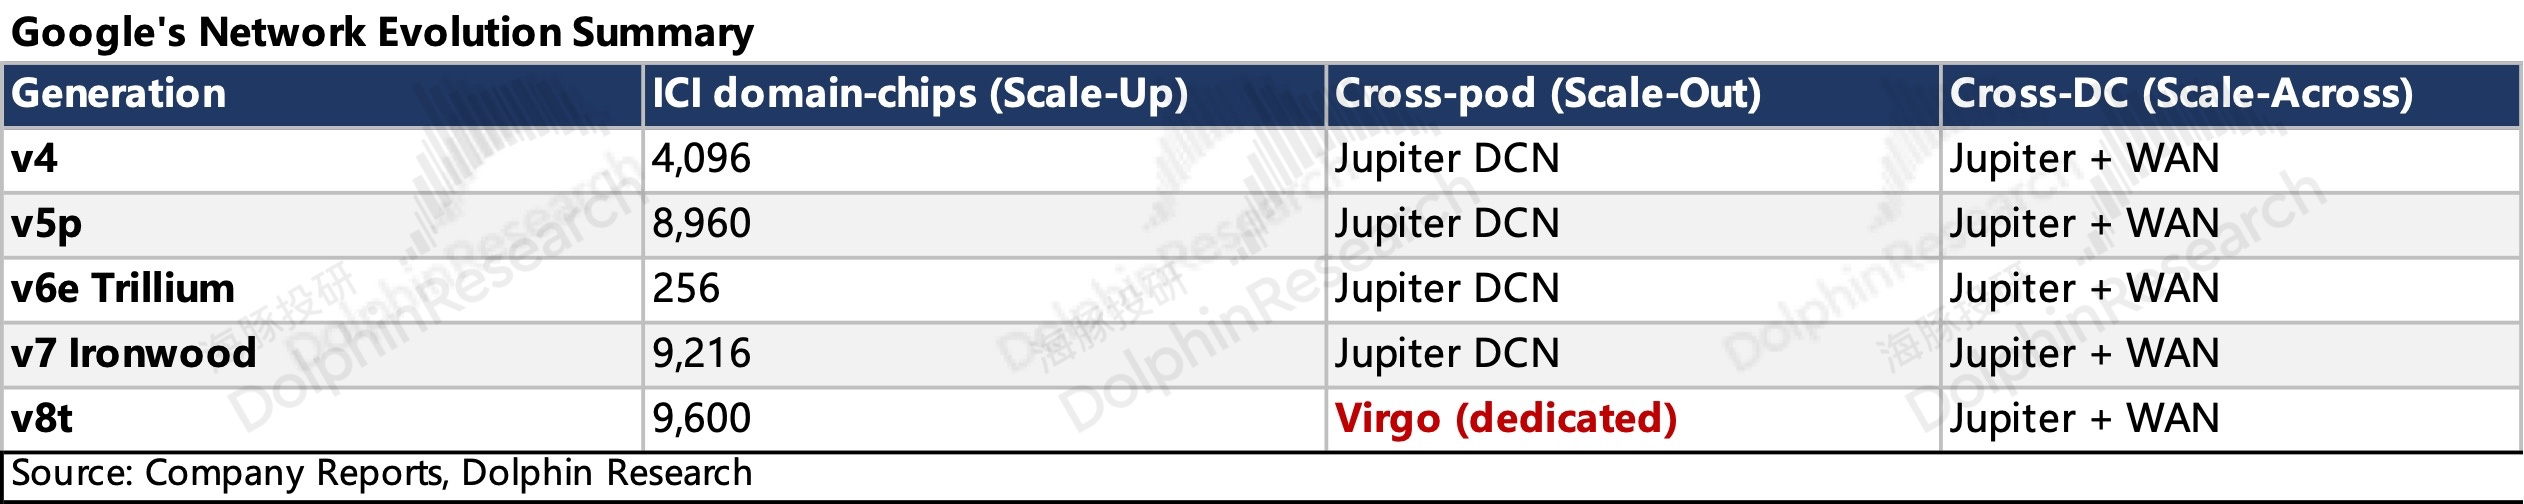
v8之前,谷歌沒爲 Scale-Out 單獨建網。原因在於 ICI 域足夠大,帶寬最敏感的張量並行和專家並行都留在 ICI 內部,壓低了跨Pod的通信需求,帶寬要求相對寬鬆,單卡帶寬僅100Gbps。
因此跨Pod流量直接借用自研的通用 Jupiter DCN,也就是 Google 數據中心裏所有服務器共用的那張通用以太網,搜索、廣告、存儲的流量都在上面跑。這意味着Jupiter DCN同時承載了前、後端流量(前端連接存儲、CPU與外網,流量稀疏、可容忍抖動;後端連接加速器之間,需同步並行)。
2、組網方案:3D“搭積木”+還有OCS
組網其實就是拓撲——一張網絡中東西之間互相如何連起來。海豚君前面兩篇做解釋的組網其實是多數數據中心都在用的組網2D胖樹網絡。
谷歌的拓撲是3D拼積木。谷歌組網從小到大爲:芯片→托盤→立方體(Cube, 也就是Rack)→Pod/Superpod。與英偉達的方案比,芯片和托盤層,名字類似,但托盤組合起來,樣子差別迥異。
1)Intra-Tray Scale-Up:物理排布1×4,拓撲邏輯2×2
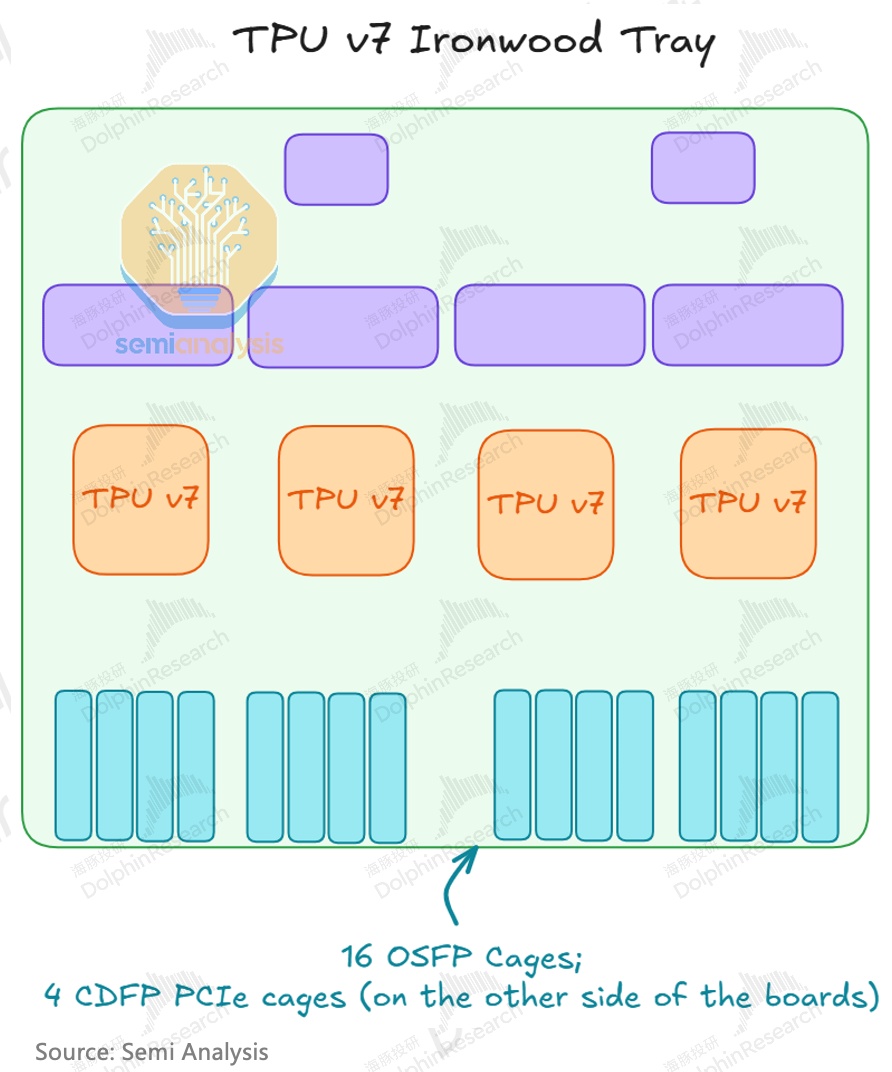
托盤內由4顆TPU組成(見下圖)。TPU間走ICI協議,每顆 TPU有6個ICI端口,聚合雙向帶寬1,200GB/s。TPU-CPU間通過PCIe(DAC)實現通信。
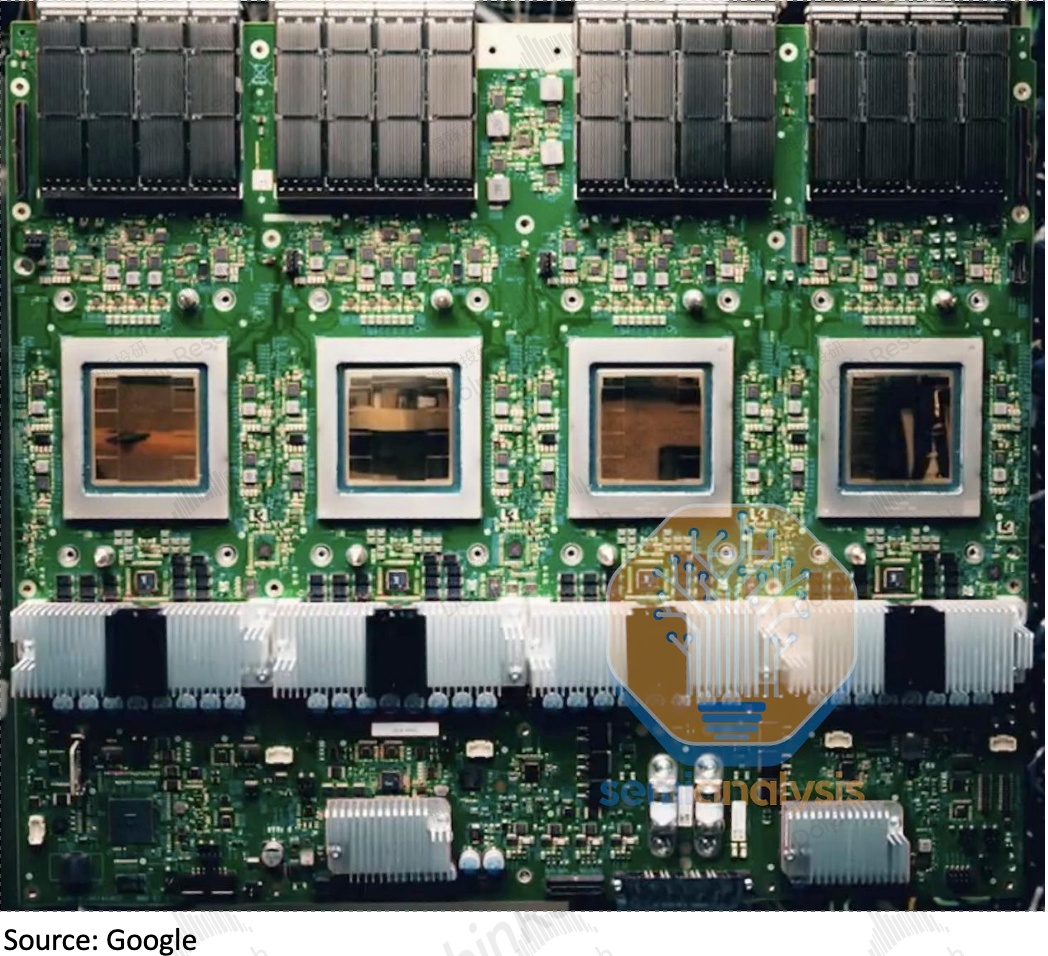
6 個端口的含義要先放到整體裏看,Google把TPU排成一個三維網格,6 個端口分別連上、下、左、右、前、後(即 ±x、±y、±z)6 個鄰居,這就是 3D torus(下圖)。
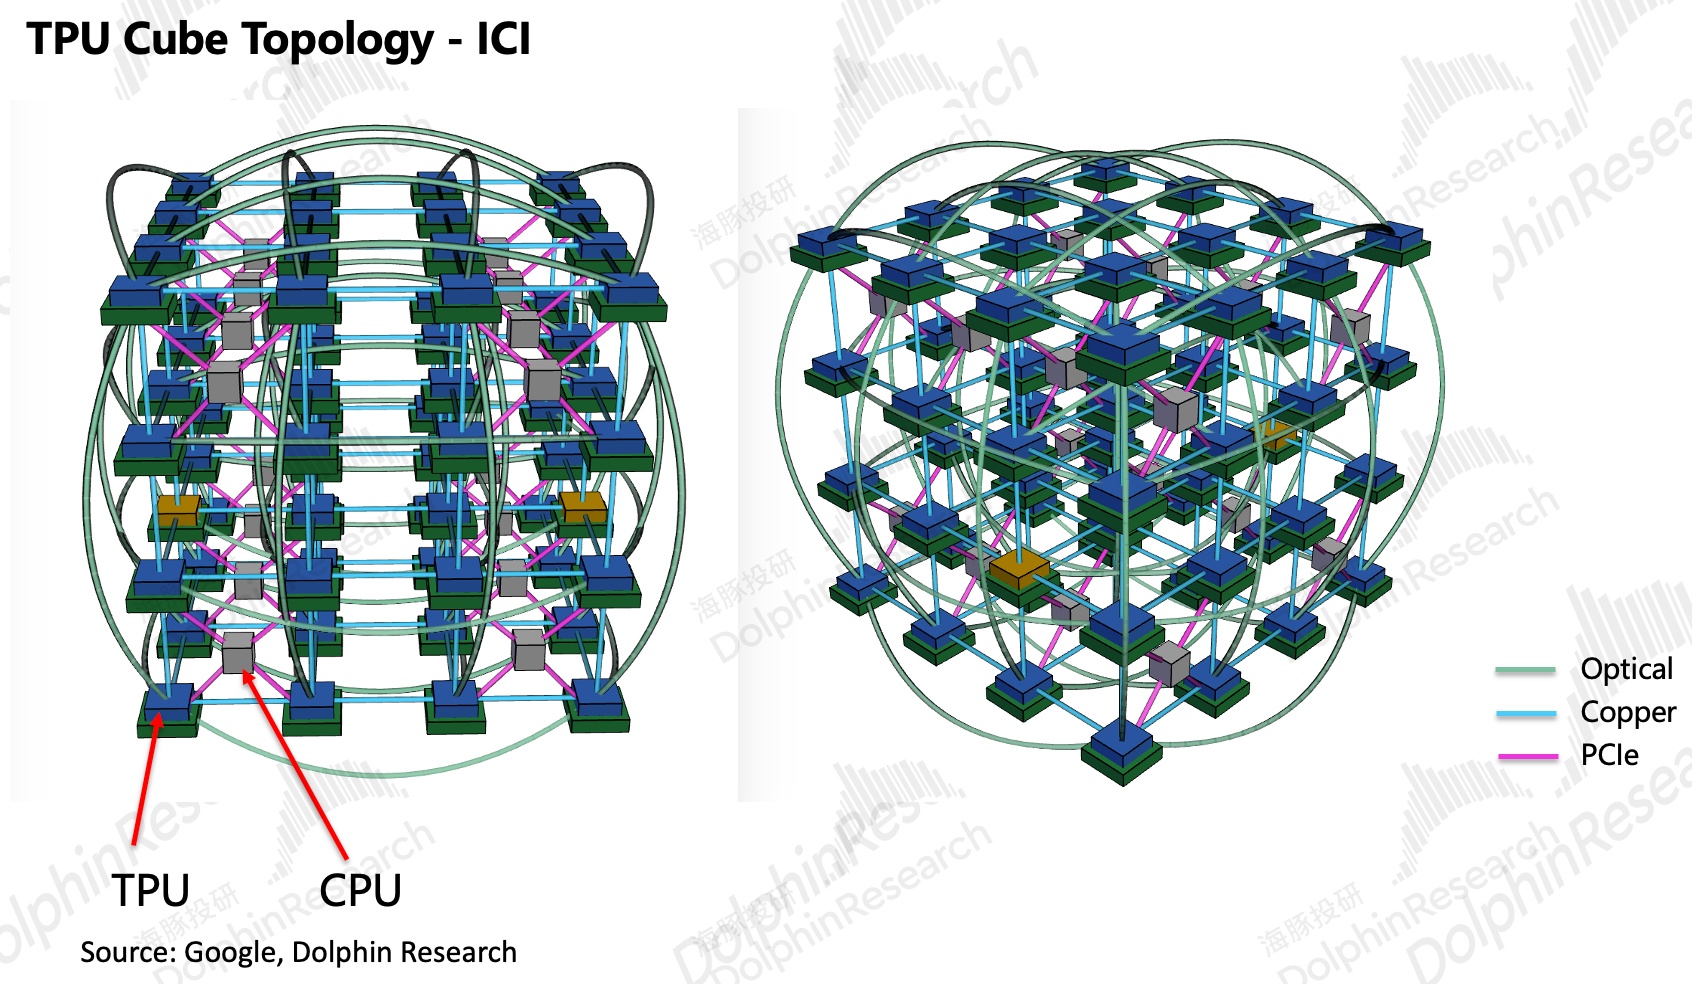
回到托盤,可以看到托盤內4顆TPU排成一排,但他們並非兩兩互連的。6 個端口中4個要留給其他托盤上的鄰居,板內只剩2個,每顆只能連2顆同板芯片。出板的4個端口接到哪裏,就是下一節的跨托盤拓撲。
2)Tray-Tray Scale-Up:直連拓撲提供連通能力
與英偉達、AMD方案最大差別,同樣在托盤間的Scale-up:谷歌不設交換芯片,TPU之間3D拓撲方式直連。
16個托盤,組成共計64顆TPU的立方連接體Cube(即機櫃),芯片連接成4×4×4的3D拓撲結構,把每顆芯片當成一個6面的連接長方體,六個方向分別拉線,與相鄰芯片直連。
觀察下圖的拓撲,可以看到部分TPU除了銅纜連接,還拉出了光纜,這是怎麼回事呢?
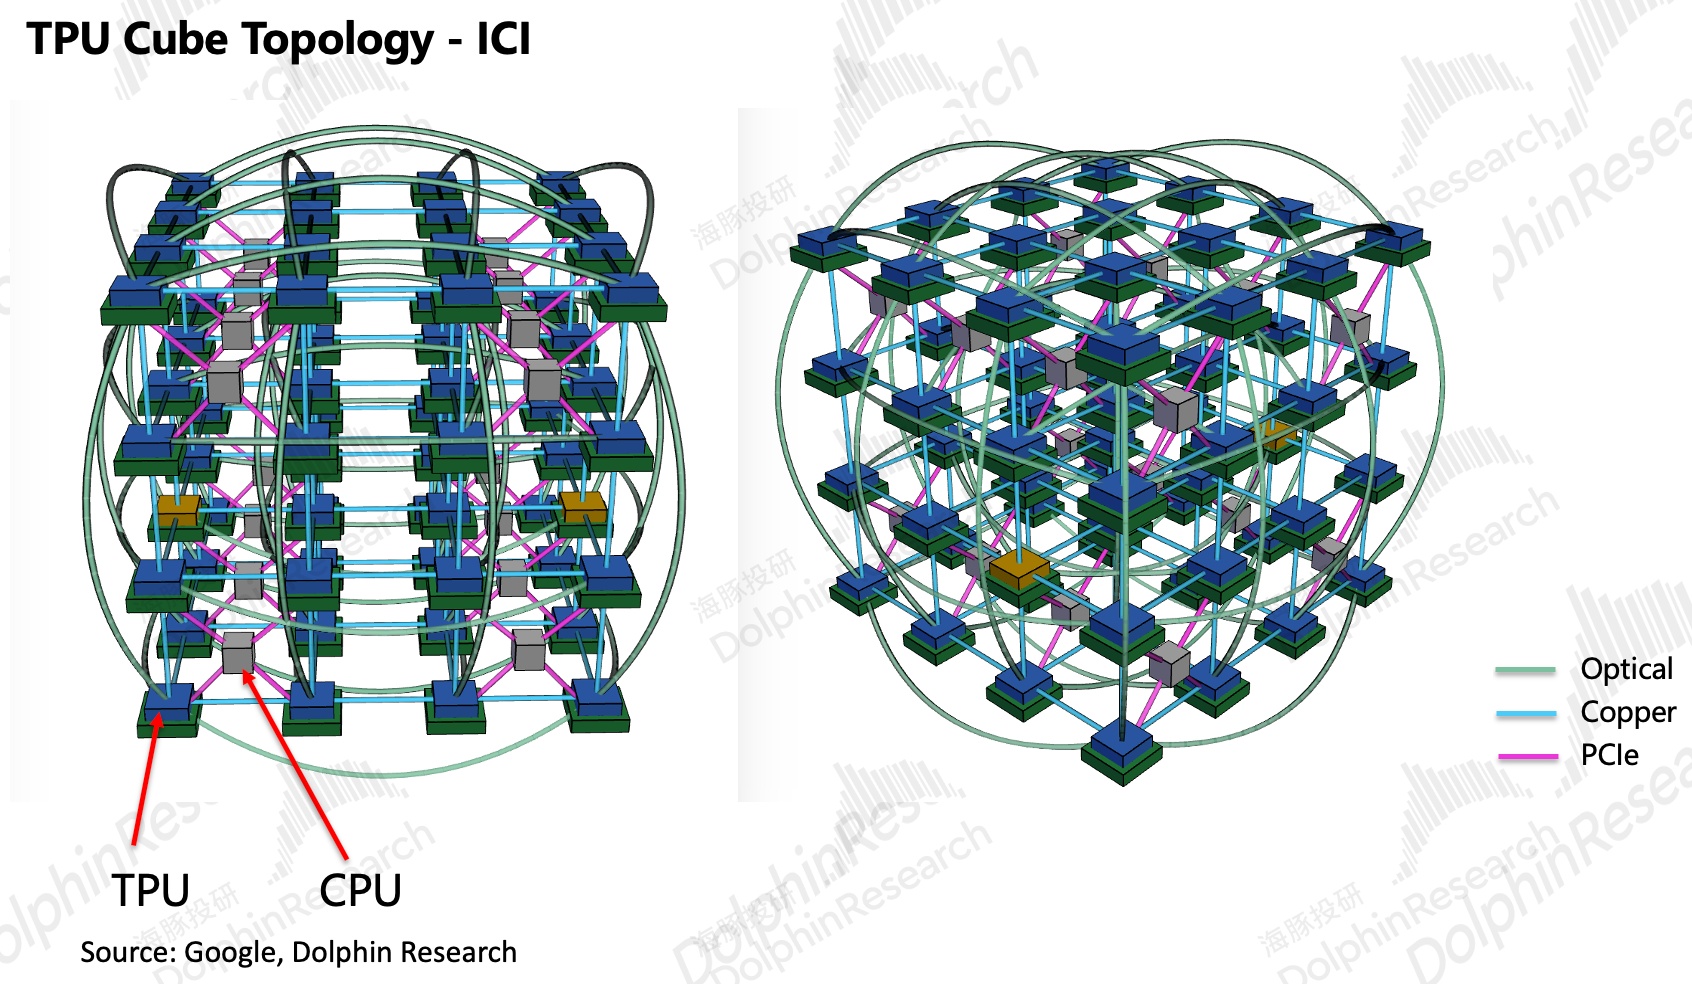
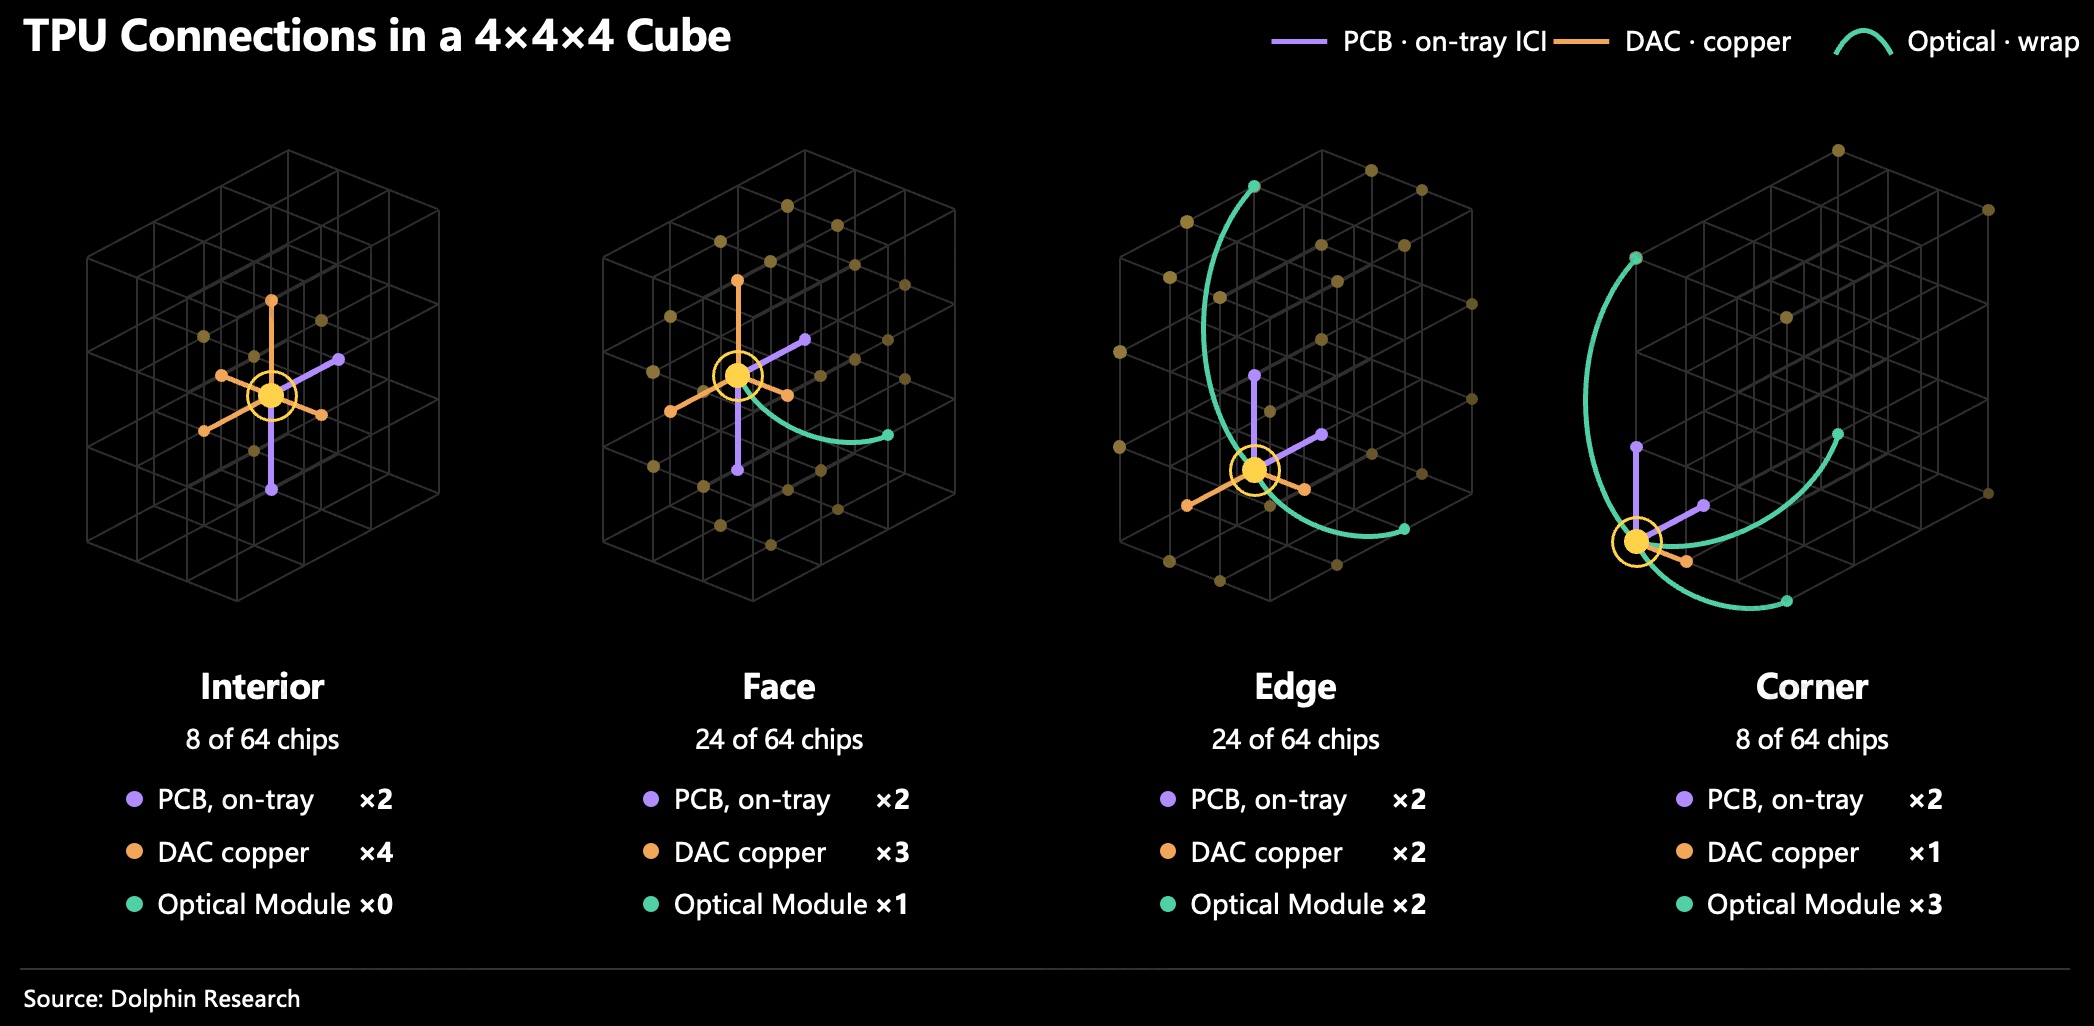
走銅還是走光取決於TPU在域內的位置。單一64芯組成的Cube內部,最裏面的8 顆TPU 都能用Copper(DAC+PCB)與全部 6 個相鄰 TPU 完全連接。
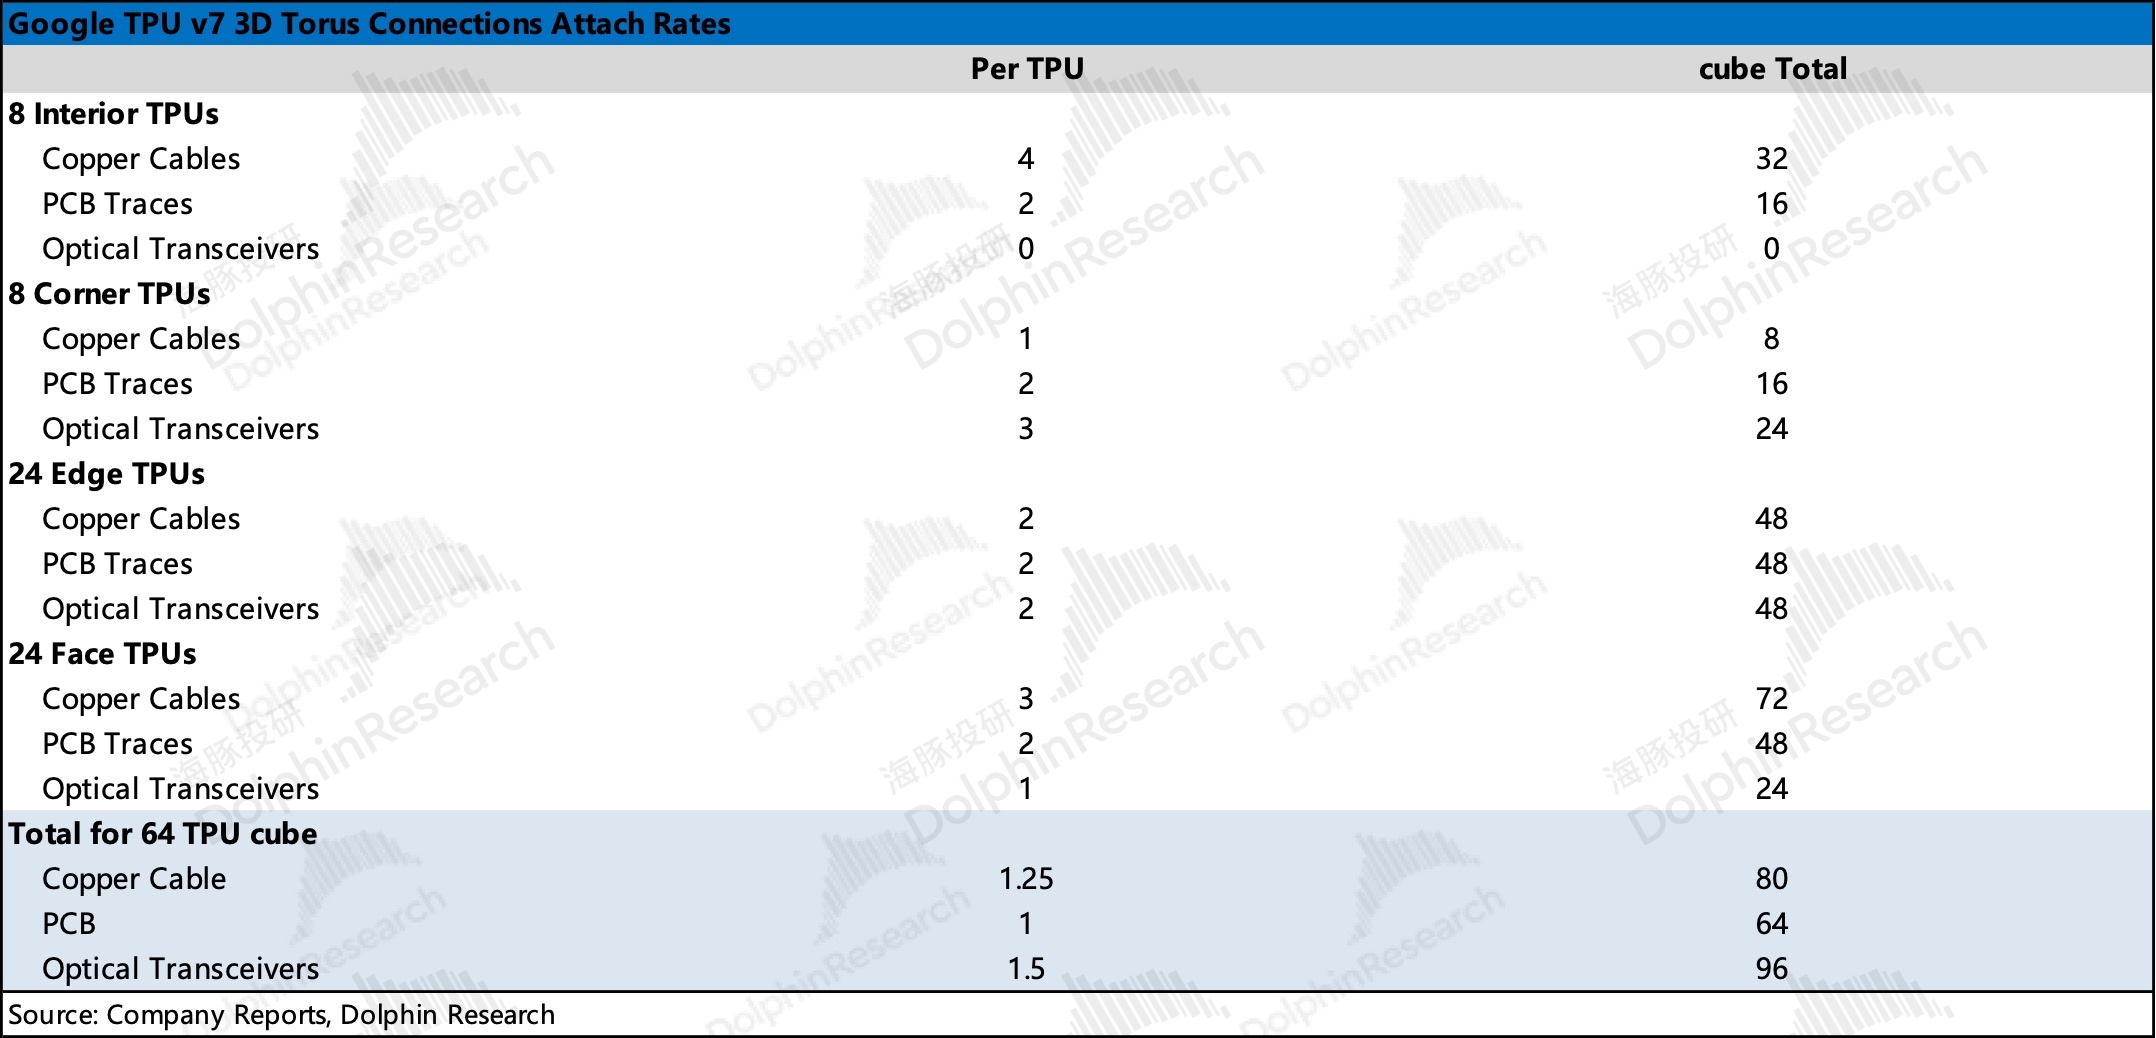
把這64芯組成的立方體作爲單一Cube個體,邊線上的TPU由於部分面無相鄰 TPU,它就以光連接到這個立方體對側的 TPU(見綠線),每條外邊上的TPU首尾相接,該連接經光模塊轉爲光信號、匯入OCS交換機。我們整理了位於Cube不同位置(內部、表面、棱、角)上對應的連接器件與參數,如下所示。
Scale-Up層直接上光,是谷歌獨有的設計。Vera Rubin NVL72與Helios的Scale-Up全程是銅:GPU 經背板銅纜接 NVSwitch/Tomahawk,光模塊只在Scale-Out的網卡和交換機上出現,GPU本身不接光。
而谷歌的光模塊直接插在TPU 托盤前面板的 OSFP 籠子裏,光路是 TPU → 光模塊 → 光纖 → OCS → 光纖 → 光模塊 → TPU,中間沒有任何電交換設備。
3) Cube-Cube Scale-Up:OCS是什麼?
上文說到Cube外表面的光纜連接會匯入到OCS交換機。事實上,在谷歌更大的網絡規模中,它也會負責把多個Cube拼成更大的域:Pod (如4個Cube、256顆TPU) 直至Superpod (上限144個Cube、9,216顆TPU)。這是谷歌最與衆不同的網絡硬件:
a. OCS交換機只負責重定向光信號。Cube外表面的信號鏈路經過光模塊接入OCS,由 OCS決定每條鏈路的另一端是自環成 64 芯片 torus還是拼成更大的 torus。OCS 只負責把光從一個端口導向另一個端口。
b. 光信號如何交換?OCS內含兩組二維MEMS微反射鏡陣列,通過每面鏡雙軸傾轉,把任意輸入端口的光束"導向"任意輸出端口(見下圖)。與EPS(電子分組交換機,AMD&英偉達方案)本質區別是:EPS對每個數據包實時做轉發決策,OCS 建立的是端口間的靜態光路。
舉例來說,如果原本是1號端口與2號端口對接,現在要讓1號與4號通信,OCS 必須重新配置反射鏡,因爲OCS沒有轉發功能;而傳統 EPS 端口本就全互連,無需重配置。
一個形象的例子是,好比鐵路道岔,軌道可以多條,但同一時刻只走一條,改道必須扳道岔(即調整鏡面角度)。
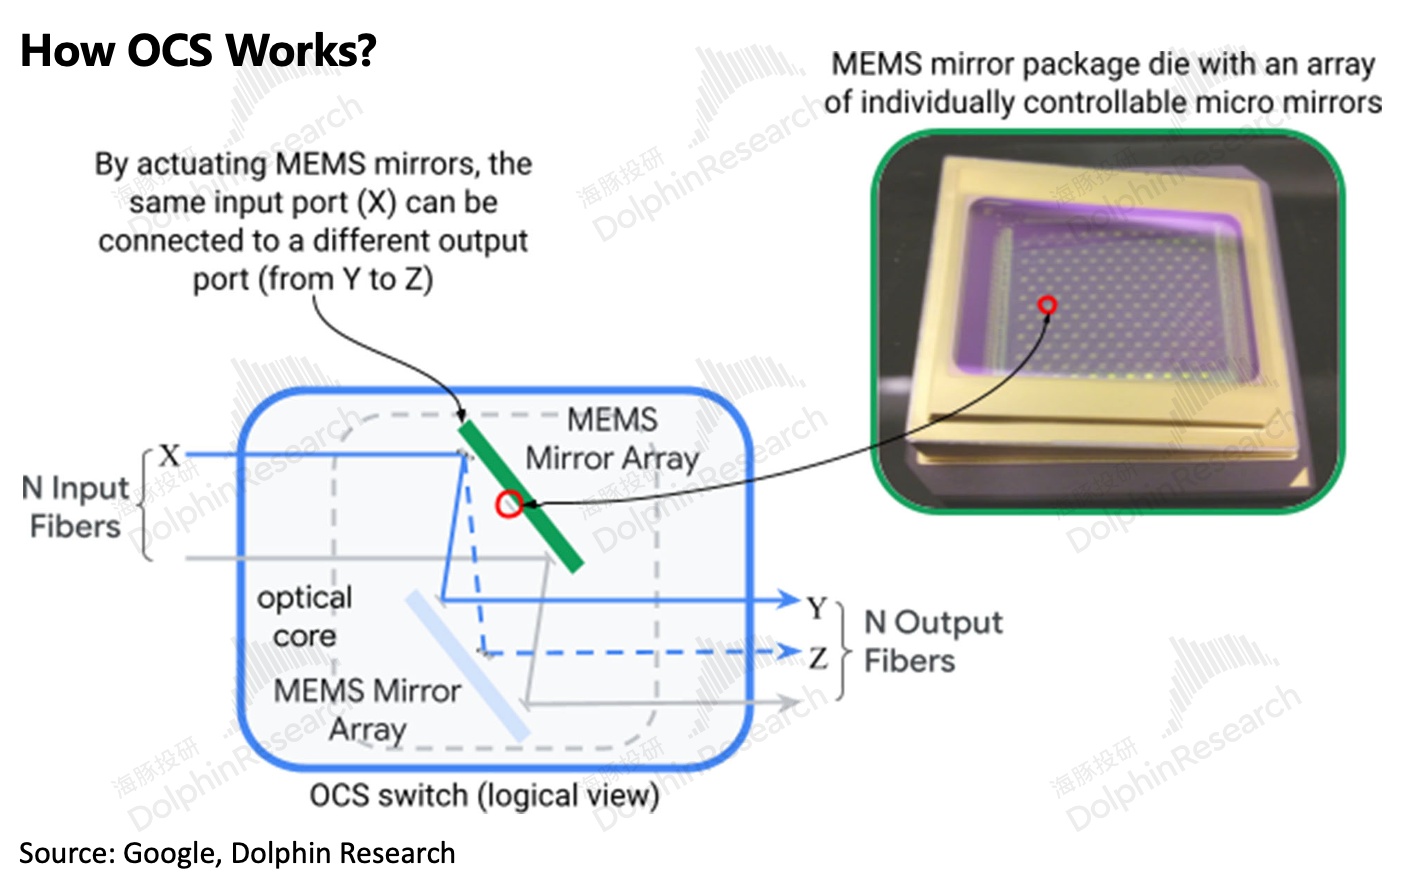
因此,也可以說谷歌的路由路徑是由軟件提前配置好的,因爲在同步並行的低延遲工作負載中花上幾秒進行重配置幾乎是不可能的。
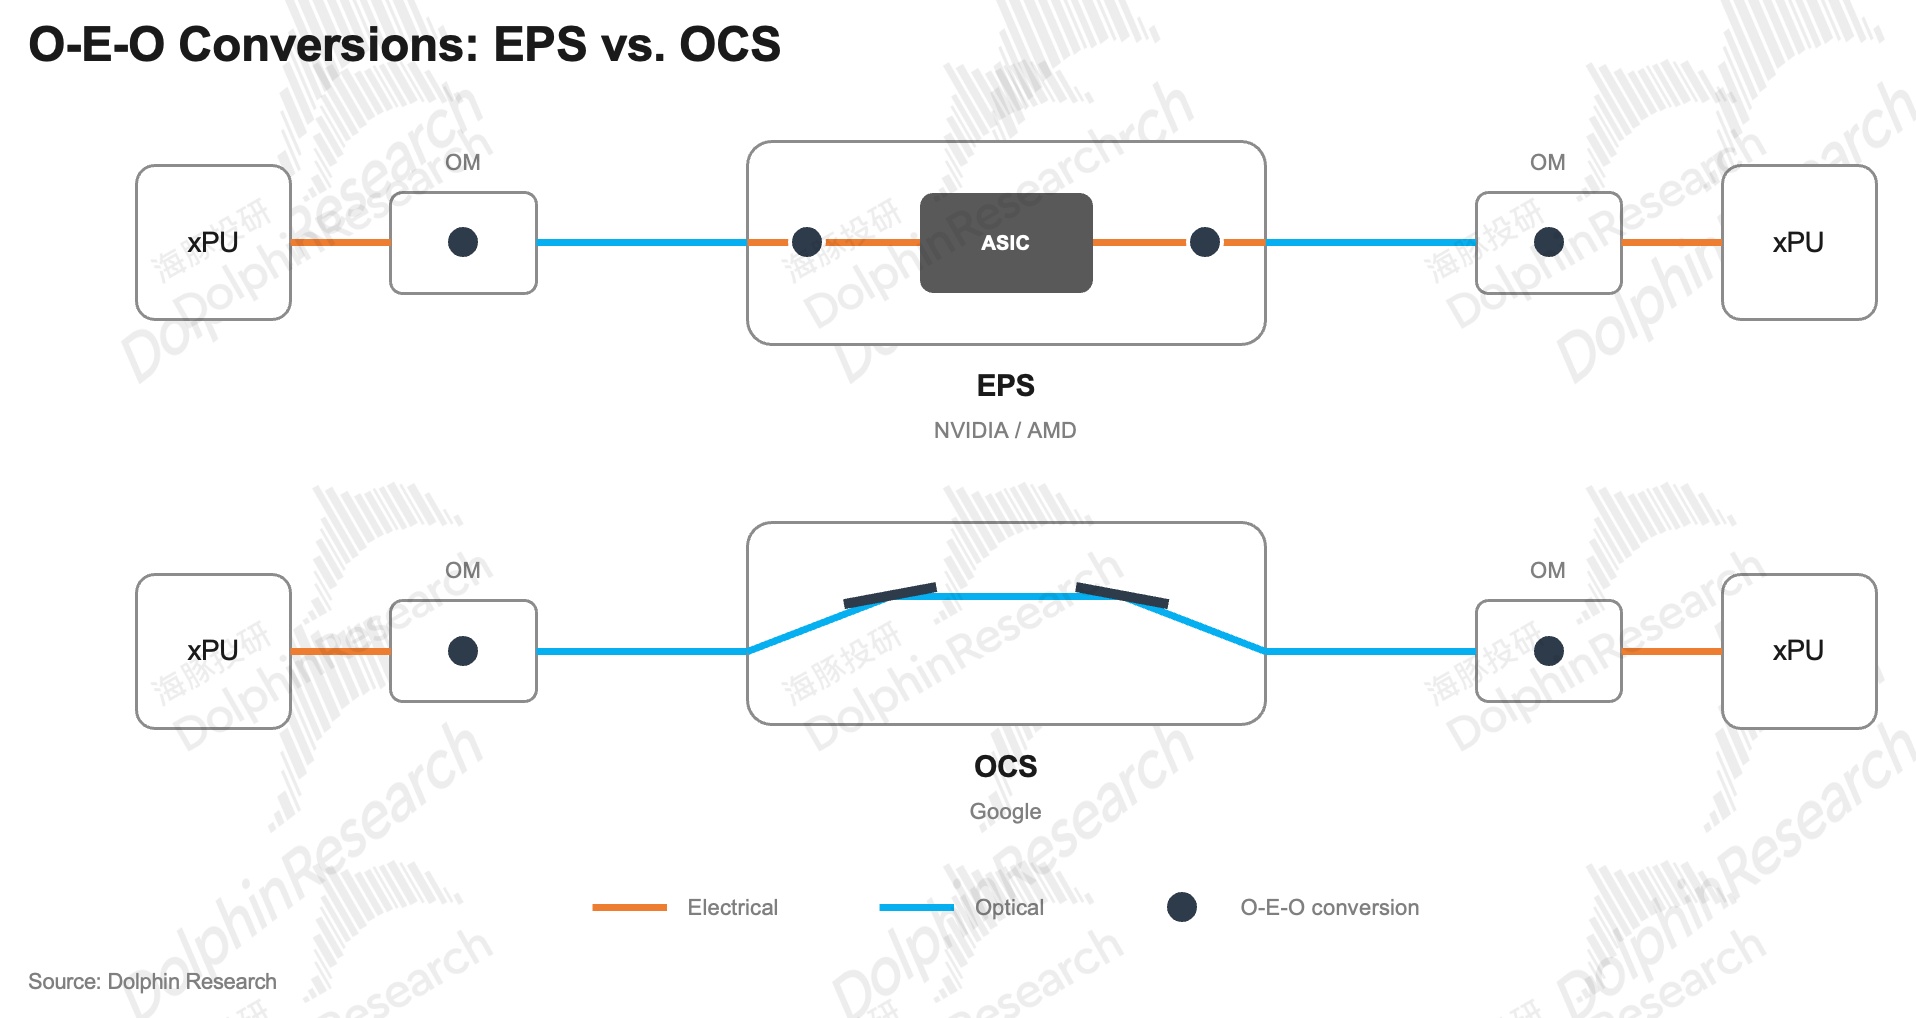
c. OCS交換機中沒有O(光)-E(電)-O(光)的轉換過程。我們知道在常規的EPS中,信號出櫃通信的路徑是:芯片發出的是電信號,先在本櫃光模塊轉成光(E→O),經光纖到交換機。
交換機只認電,入口再轉回電(O→E),交換芯片決定轉發到哪個端口,出口再轉成光(E→O);經光纖到對側機櫃,光模塊轉回電(O→E),送進芯片。
OCS省掉的就是交換機裏的兩次光電轉換,也是這張網裏唯一的"交換"設備,卻不用承擔交換ASIC的功耗與成本。示意圖如下:
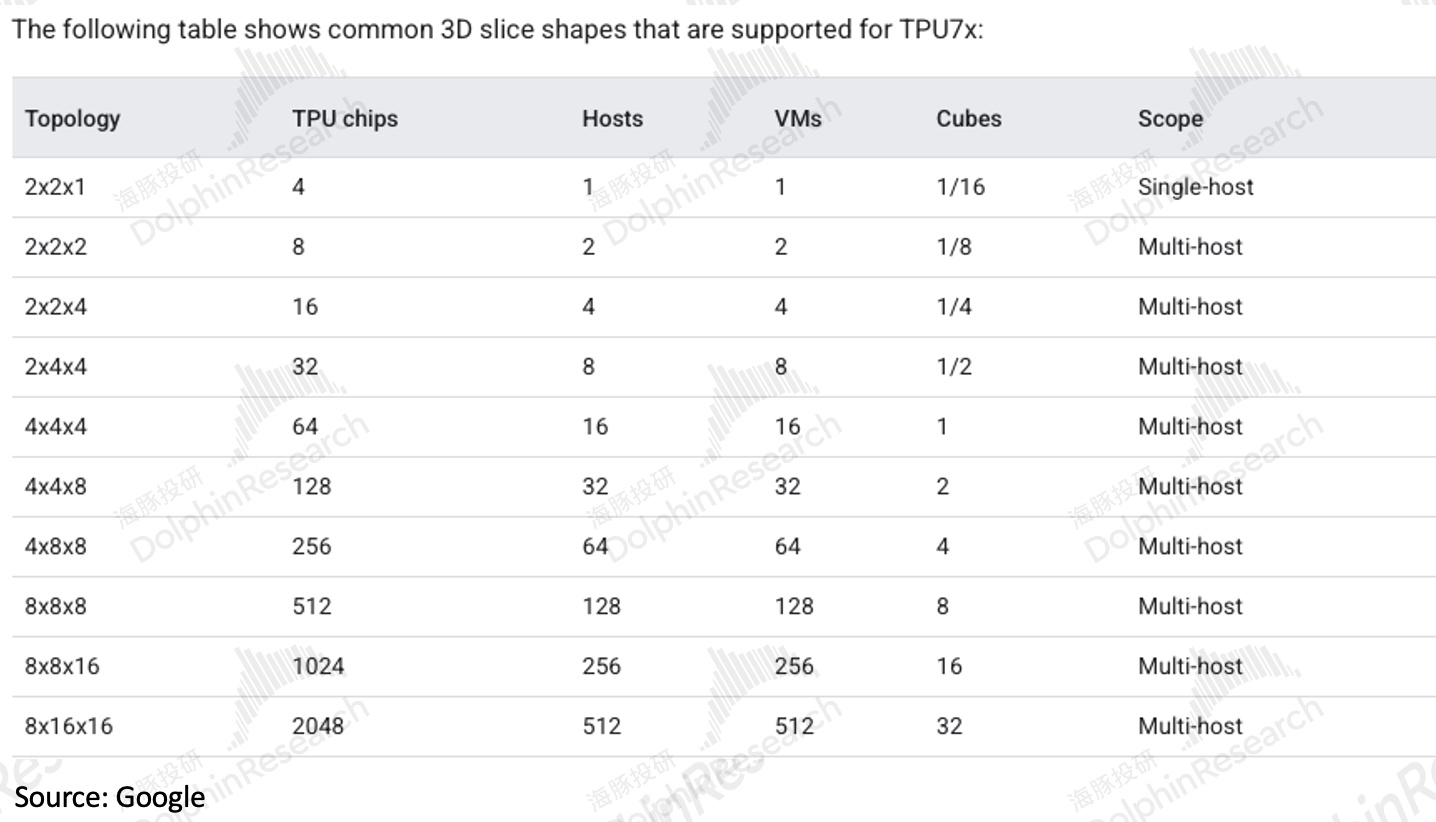
d. 靈活的拓撲規模。在實際落地中谷歌未必以標準的Cube(64顆TPU)進行拓展,谷歌能夠把 TPU配置成從 4 顆一路到 2,048 顆之間的常見切片規模,這也是OCS交換機預先配置給予的靈活度。
4)Superpod-Superpod Scale-Out:OCS替代Spine層的野心
出了 ICI 域,就進入 Scale-Out。這張網的核心器件,仍然是 OCS。
對照上篇:英偉達、AMD 的胖樹(Leaf-Spine)架構以 EPS 爲核心,有兩個痛點。一是耗電;二是網絡速率 2-3 年翻番,Spine 層跟着整體換代,資本開支巨大。
谷歌的思路是在ToR層仍然使用以太網交換機(自研白牌交換機,Switch ASIC預期爲博通),儘可能替代Spine層(如下圖所示,常見方案下ToR上連接Spine,而谷歌方案下連接OCS)。這帶來了兩點優勢:
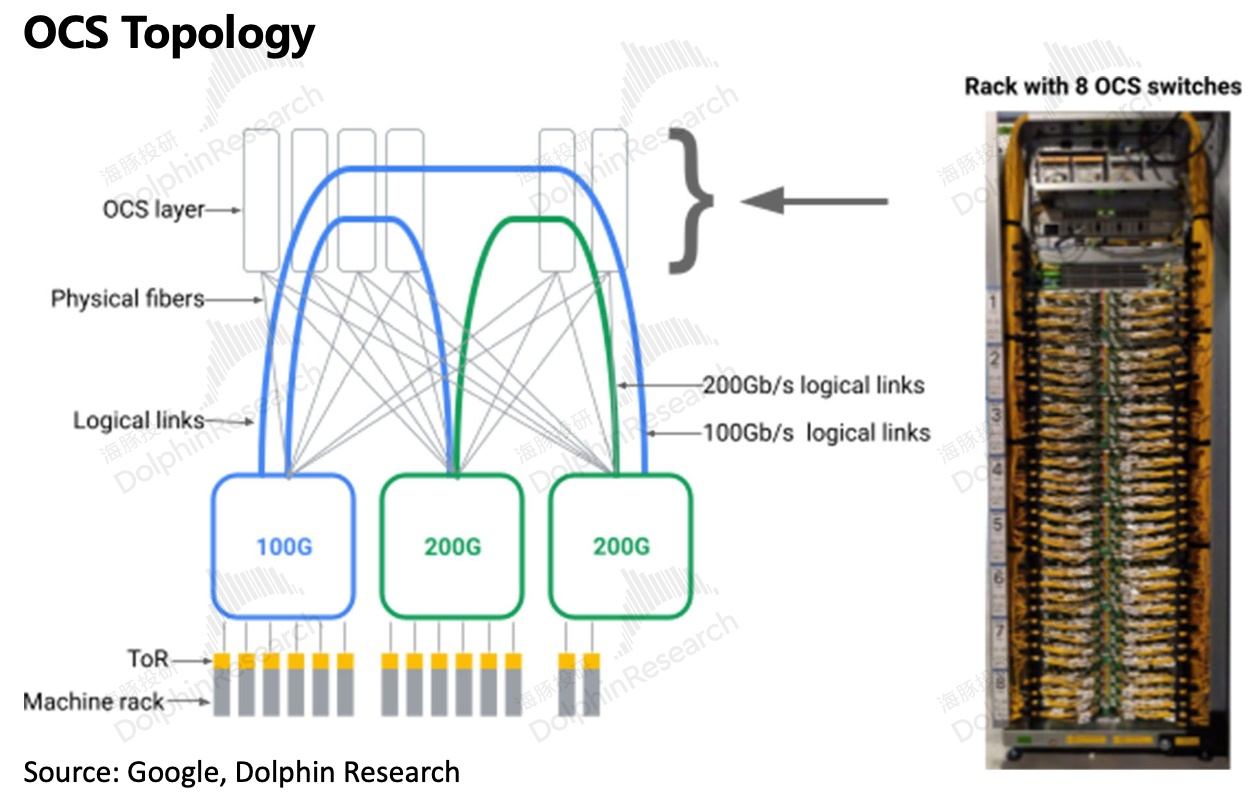
強兼容性帶來的成本節約。OCS 只反射光、不認速率,能把不同代際的交換機接在同一張網裏(下圖右),而整體網絡速率不會被最慢代際拖累(下圖左,傳統網絡架構)。意味着一旦OCS部署完成,就可以將交換機和光模塊升級到速率快得多的新一代產品,而無需更換網絡的Spine層,換機週期更長,更省錢。
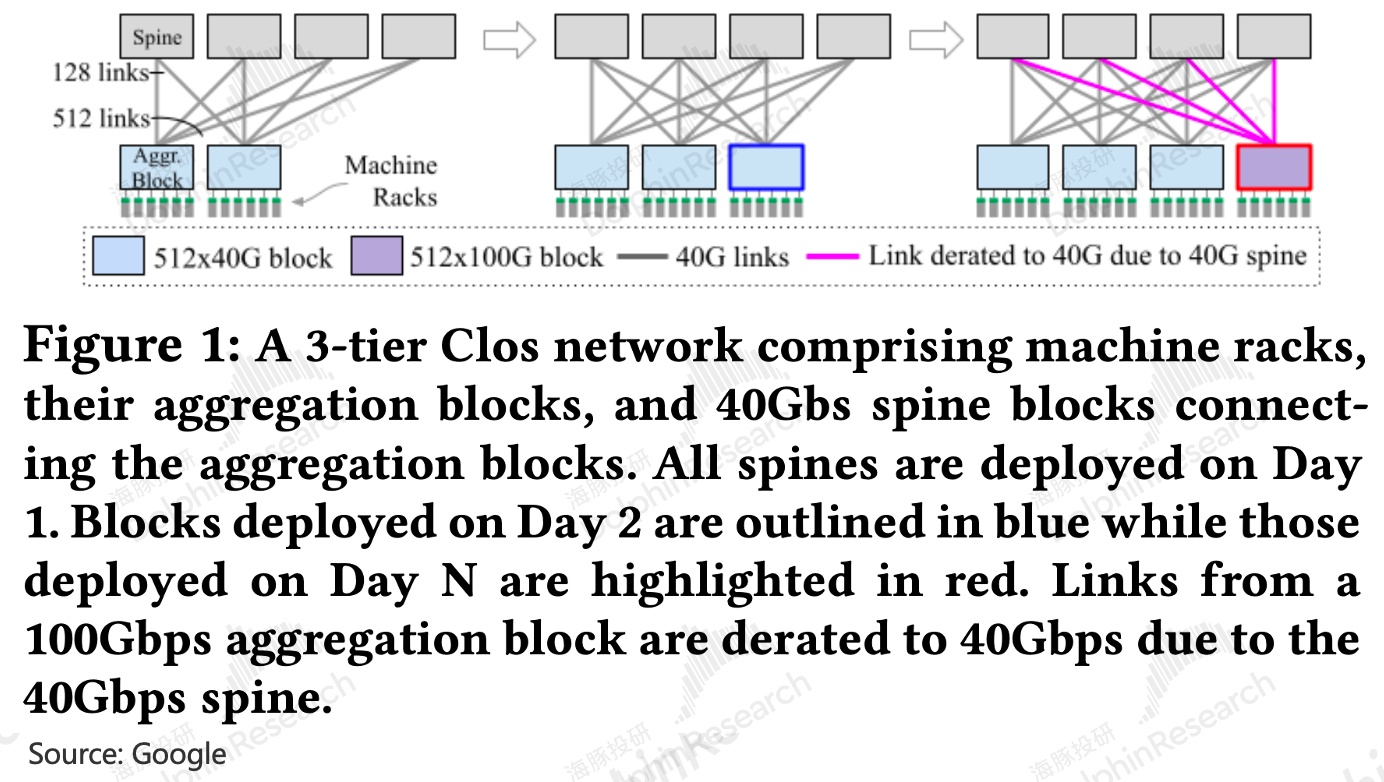
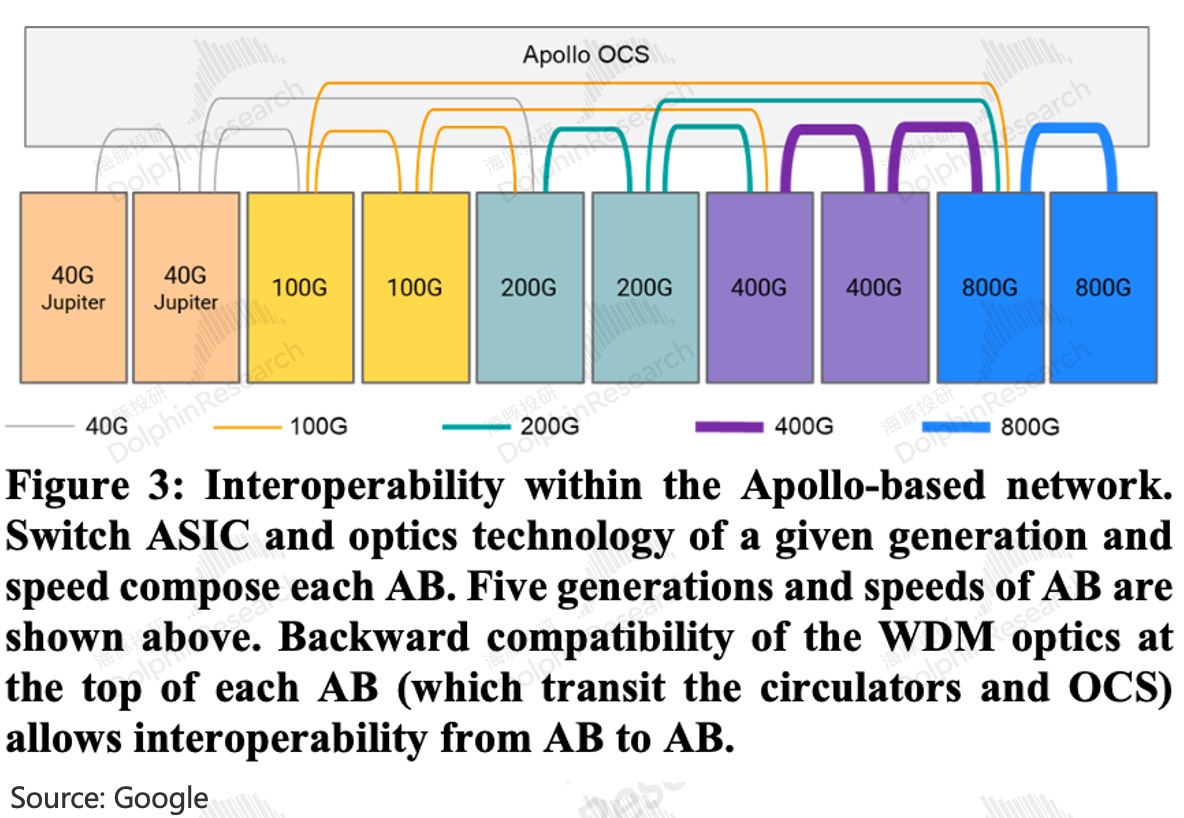
低時延低功耗。光電轉換的步驟是有時延的,OCS只是把入射光從源端口反射到目的端口。當然這也降低了整體的功耗。
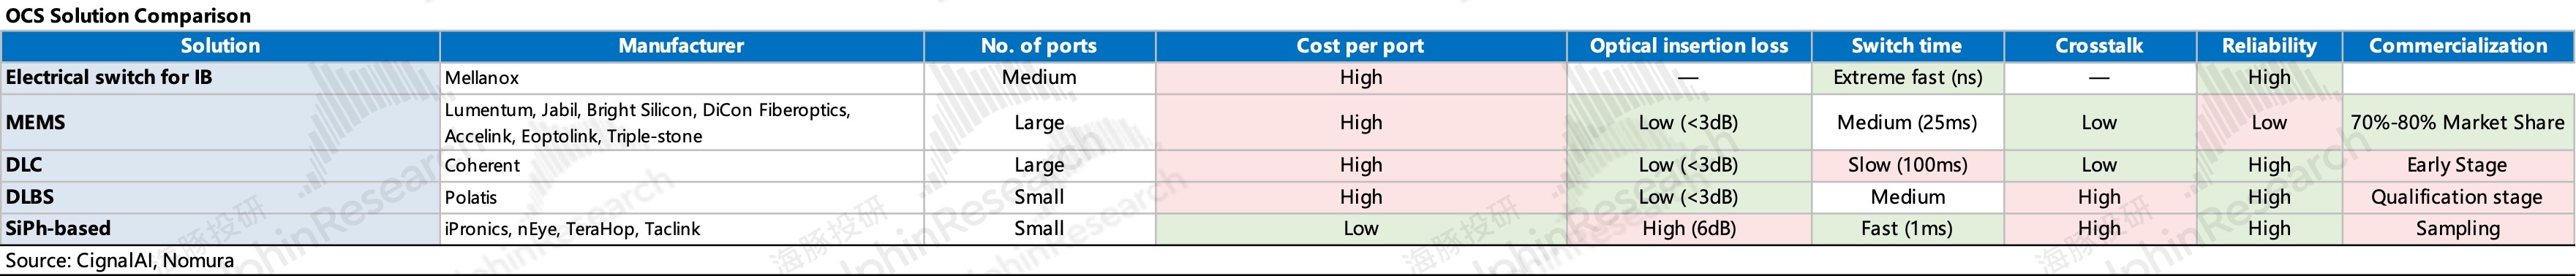
當然OCS也不是完美方案,除了上文說的在工作負載時網絡重配置難以實現,還有一個關鍵點是放棄了和其他EPS通用方案混用的靈活性,畢竟網絡是需要基於OCS進行設計的。此外在可靠性、插入損耗等方面,都是略落後於EPS的。
3、小結
我們認爲,谷歌的組網方案,本質上建立在其軟件棧優勢之上。直連 torus 省掉了交換芯片,也就意味着網絡裏沒有設備在運行時做轉發決策。前提是拓撲和路徑都在任務開始前由軟件定好:Cube自環還是拼接、切片的規模大小等都是OCS的配置,不涉及物理佈線。Scale-Out以OCS取代電Spine也是同一邏輯。換言之,谷歌把"智能"從交換芯片搬到了配置期,硬件只需提供固定、便宜的直連鏈路。
對客戶而言,這是一筆確定性換靈活性的交易。路徑提前固定,不存在運行時的擁塞繞行,性能在任務跑起來之前就是可算的。
代價是跑起來之後沒有臨場補救的餘地。進一步的,只有谷歌自己的編譯器知道這些芯片是怎麼連的,客戶因此必須留在谷歌編譯器的體系內,CUDA側的遷移也是個問題。
二、直連拓撲從v7到v8是如何演進的?
谷歌爲v8代際訓推分家的TPU制定了網絡優化,組網方案的演進概括來說就兩點:
- 訓練側的v8t沿用 v7拓撲,把帶寬和規模做大,新建後端專用網絡;
- 推理側的 v8i 改拓撲,把跳數壓低。
1、v8t(訓練):帶寬翻倍、ICI域擴至9,600顆、新建Virgo後端
帶寬翻倍,拓撲延續。單TPU雙向帶寬翻倍至2,400GB/s,托盤與Cube延續v7的3D torus;ICI域上限從9,216顆擴大至9,600顆。
Scale-Out不再借用Jupiter。前後端共網的安排到 v8 難以爲繼,主要是因爲:訓練集羣逐漸超出單個ICI域,跨Pod流量不再只是數據並行的梯度同步,單芯片帶寬需求激增,訓練的毫秒級同步突發與推理的延遲一致性要求,與通用網絡相悖。
因此,谷歌爲v8t新建專用後端網絡 Virgo,承接跨Pod的Scale-Out流量,單芯片 Scale-Out帶寬提升至v7的4倍(即400Gbps)。當訓練突破單DC的電力與空間上限後,需跨 DC 組成統一域,Jupiter繼續負責前端網絡並作爲Scale-Across的出口,可在單一訓練集羣內擴展到超過100萬顆TPU。
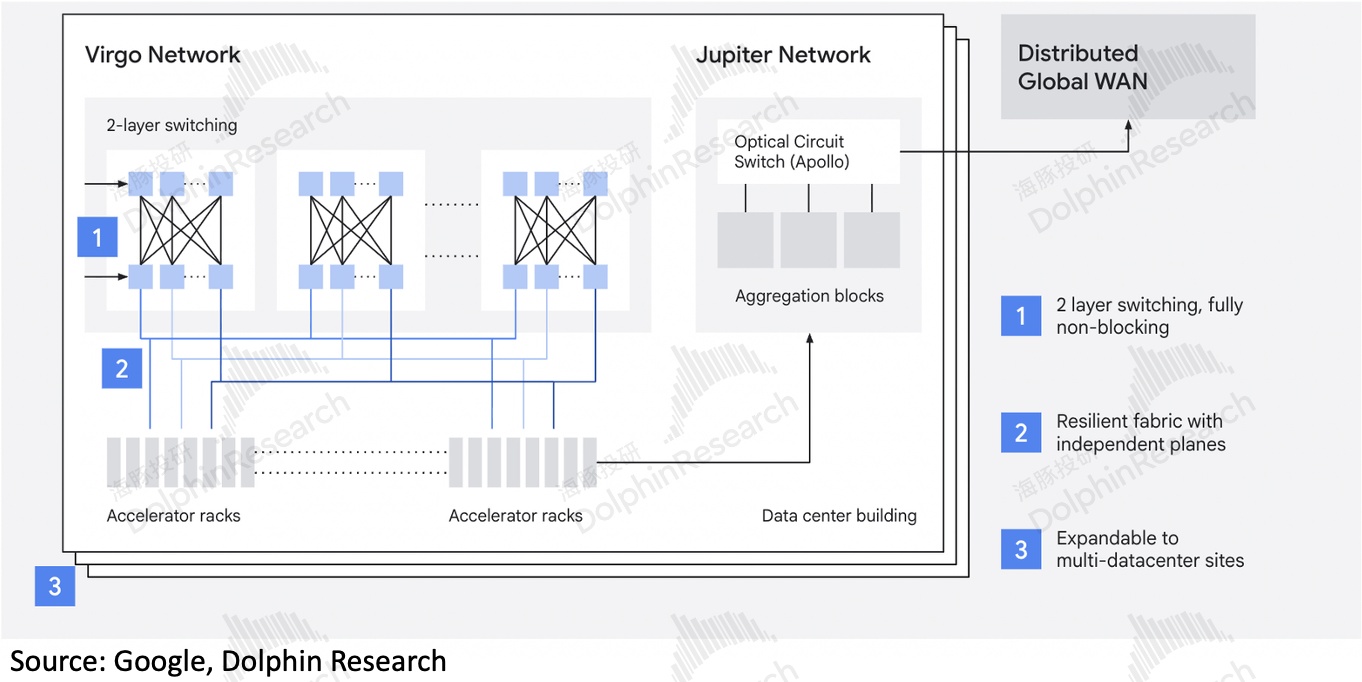
2、v8i(推理):托盤全互連、改用Boardfly壓低跳數
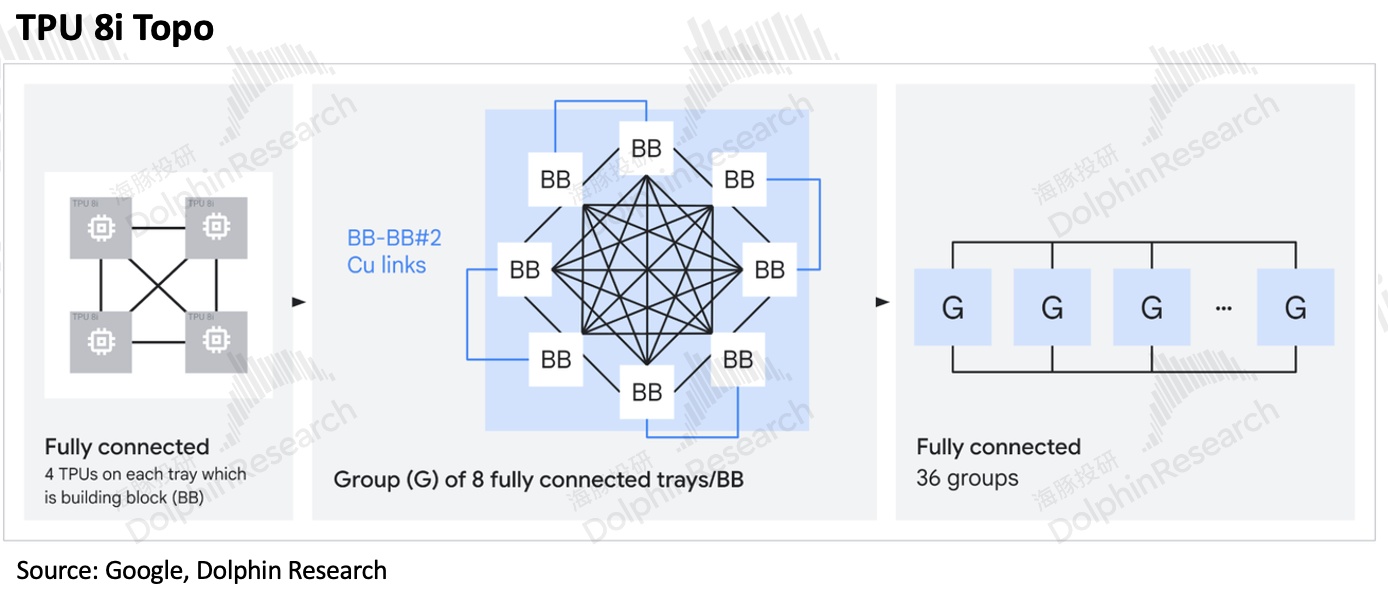
托盤內全互連。單托盤4顆芯片經內部ICI實現了全互連,節省了對角線位置(如a與c)的TPU通信的跳數,即從2跳變爲1跳(見下圖)。
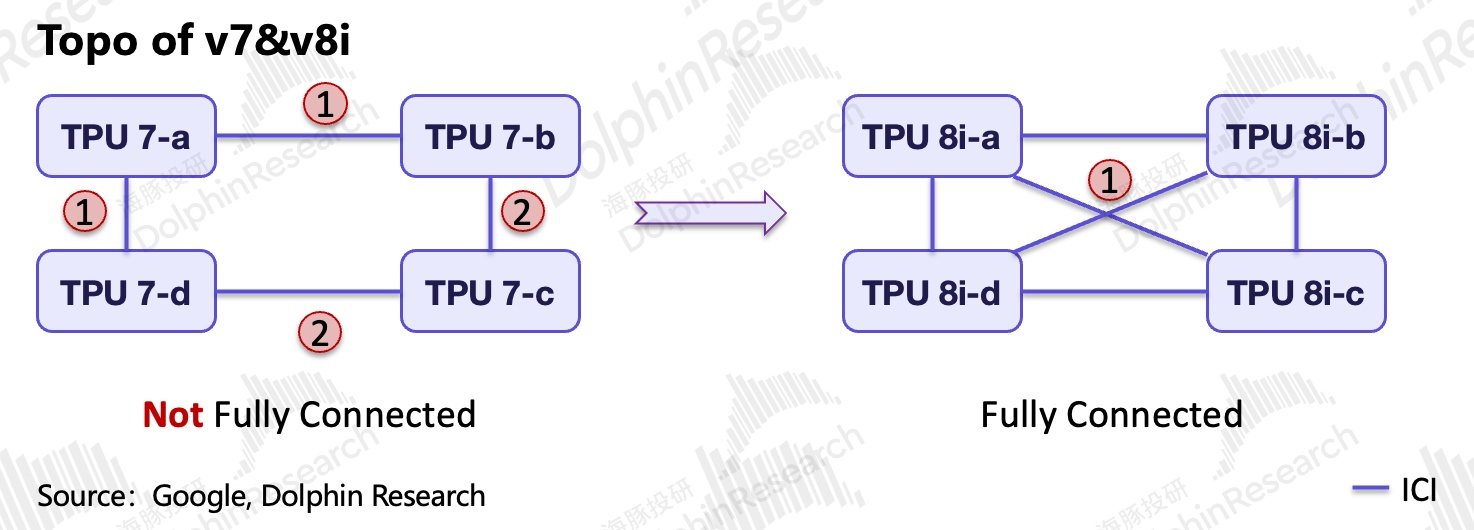
Cube層改用分層拓撲Boardfly。每托盤對外提供16條鏈路,8塊托盤用其中11條經銅纜全互連爲一個 Group,餘5條經光模塊接入 OCS;36 個Group經OCS直連成pod,合計1,152顆,其中1,024顆活躍(見下圖)。
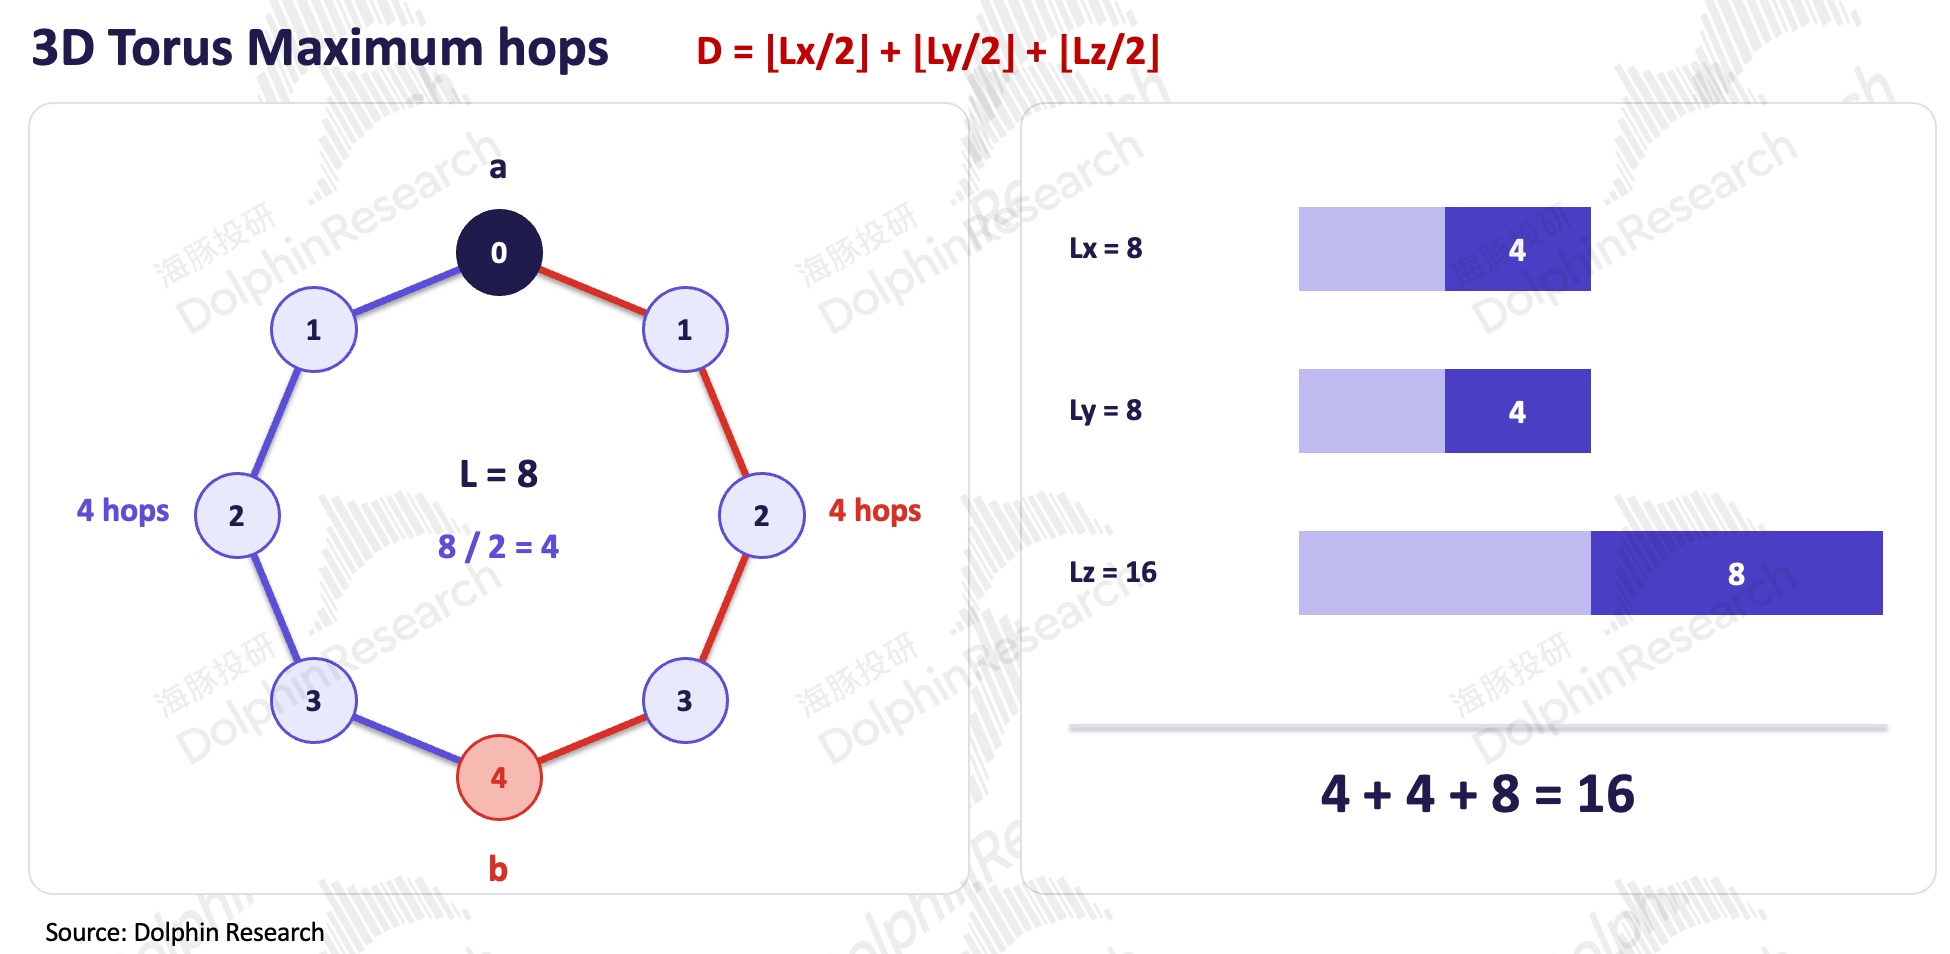
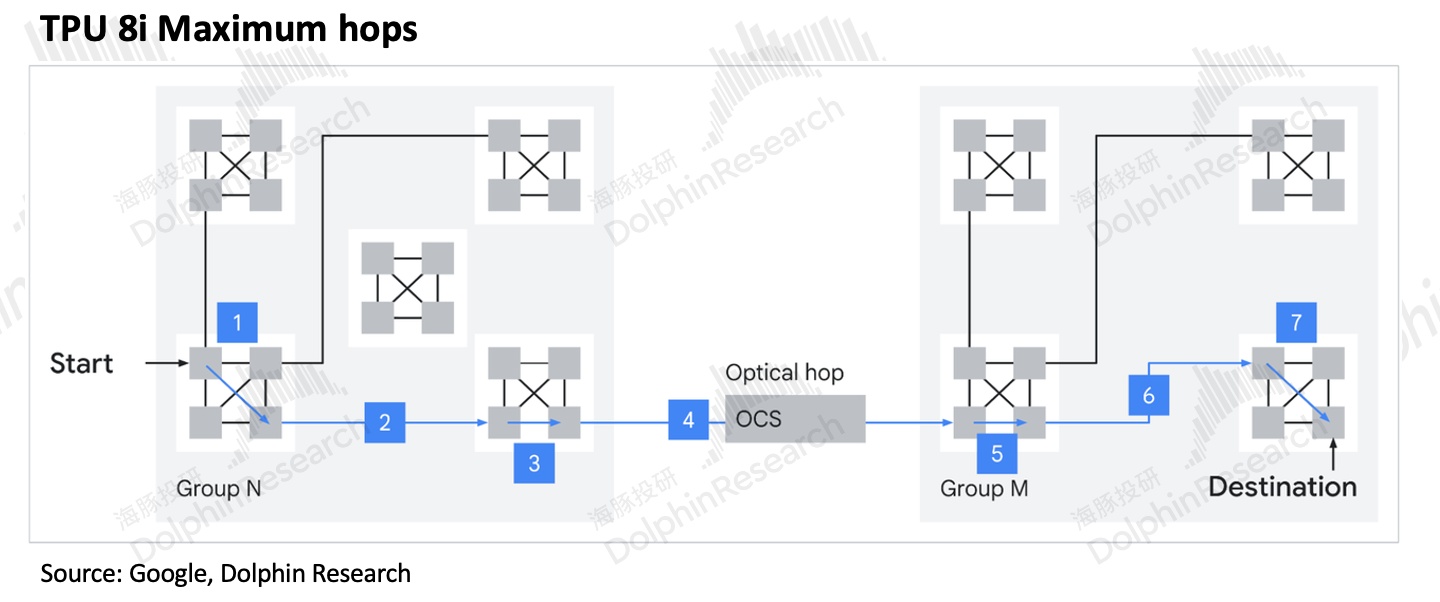
推理側拓撲改動的直接收益體現在網絡直徑上。在同爲1,024顆(8×8×16)芯片的域,3D torus拓撲最多需16跳:torus 的每一軸都是首尾相接的環,環上最遠距離是半圈,三軸互相獨立、路程相加,即 4+4+8=16 跳;Boardfly最多僅需7跳(兩者路徑見下圖)。網絡直徑減少超50%可直接轉化爲更低的尾部延遲,降低用戶側感知的延遲,對推理爲主的Agent工作負載十分重要。
3、至此,我們結束了谷歌組網方案、演進關係、優劣勢等話題。在進入競爭力的討論之前,先對其組網方案做一個小結:
- Scale-Up層:自研ICI協議,3Dtorus直連而非交換式,域內沒有交換芯片;芯片間走銅纜還是光由其在Cube中的位置決定;OCS只配置Cube間光路,使torus可切片、可容錯、可拼至近萬卡。v8i爲推理場景改用Boardfly拓撲,降低了最大跳數。
- Scale-Out層:v8之前借用通用 Jupiter DCN(以OCS取代電Spine,前後端流量共網);v8t新建專用後端網絡Virgo,單芯片Scale-Out帶寬提升至4倍,Jupiter退回前端並承擔Scale-Across。
- 關鍵硬件OCS出現在兩層網絡之中,在犧牲了一定靈活性與性能的同時,提升了兼容性,達到了降本的效果。
三、轉向TPU-aaS商業模式後,谷歌方案有競爭力嗎?
1、路徑方案的取捨
谷歌與AMD、英偉達其實並非完全可比,我們將可比項加了底色(綠色爲領先,紅色爲落後),其餘維度是隻能說路徑方案之間的取捨,具體來看:
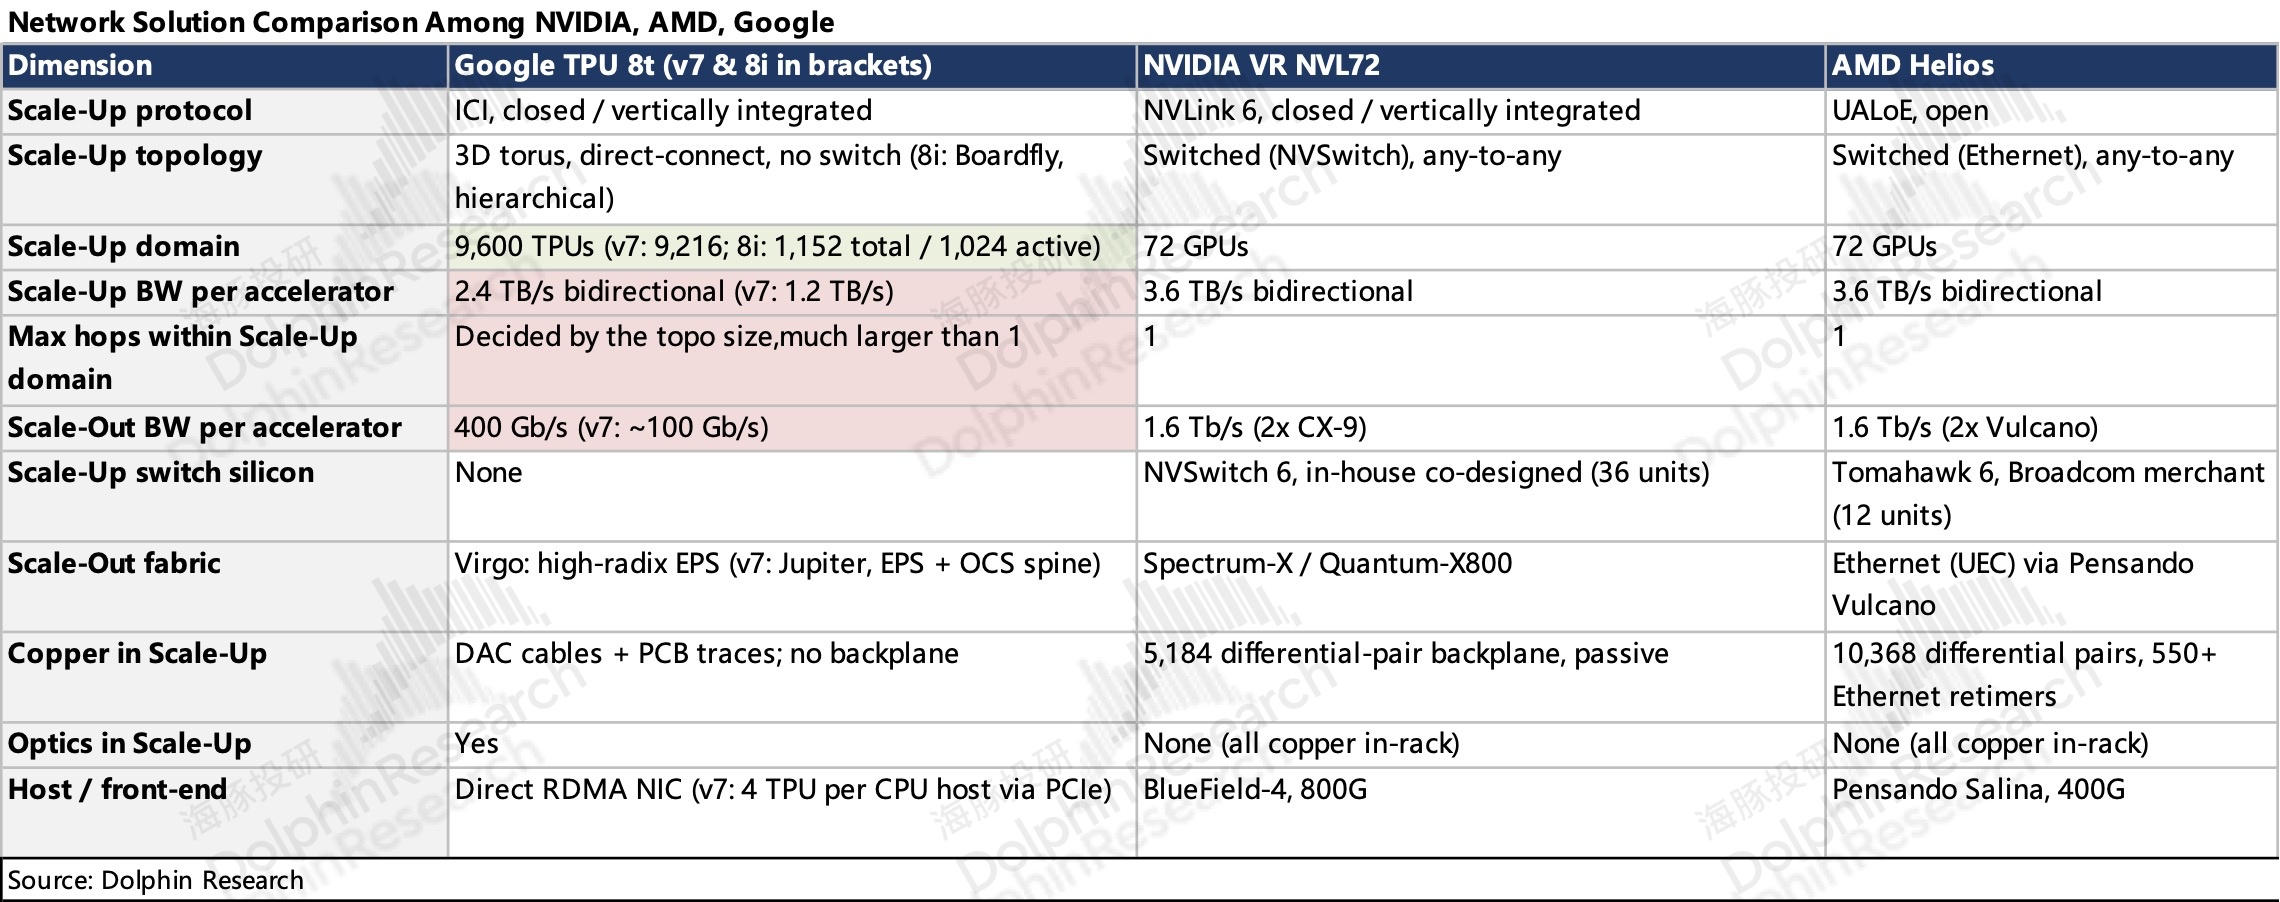
犧牲單卡帶寬擴大域規模。單看協議帶寬,ICI的2,400 GB/s落後於NVLink 6與 UALoE 的 3,600 GB/s,但 Scale-Up 域差距懸殊(9,600 顆 vs 72 顆)。集羣一旦超出單機櫃(如千卡),NVIDIA、AMD 方案必須走Scale-Out,存在帶寬落差(單卡Scale-Out帶寬放緩至200GB/s)和協議轉換開銷;谷歌在此規模下仍在Scale-Up域內,未必處於劣勢。其Scale-Out較低的帶寬也是ICI域足夠大的結果。
犧牲跳數節約交換芯片。交換式拓撲下任意兩顆 GPU 均爲單跳;torus 中通信須沿軸逐跳轉發,網絡直徑隨規模上升。省掉交換芯片後,擴展不再受交換端口數與銅纜長度約束。
2、以上取捨如何反映到組網成本上?
我們進一步測算了谷歌單機架網絡物理層的成本(外採口徑),如下所示:
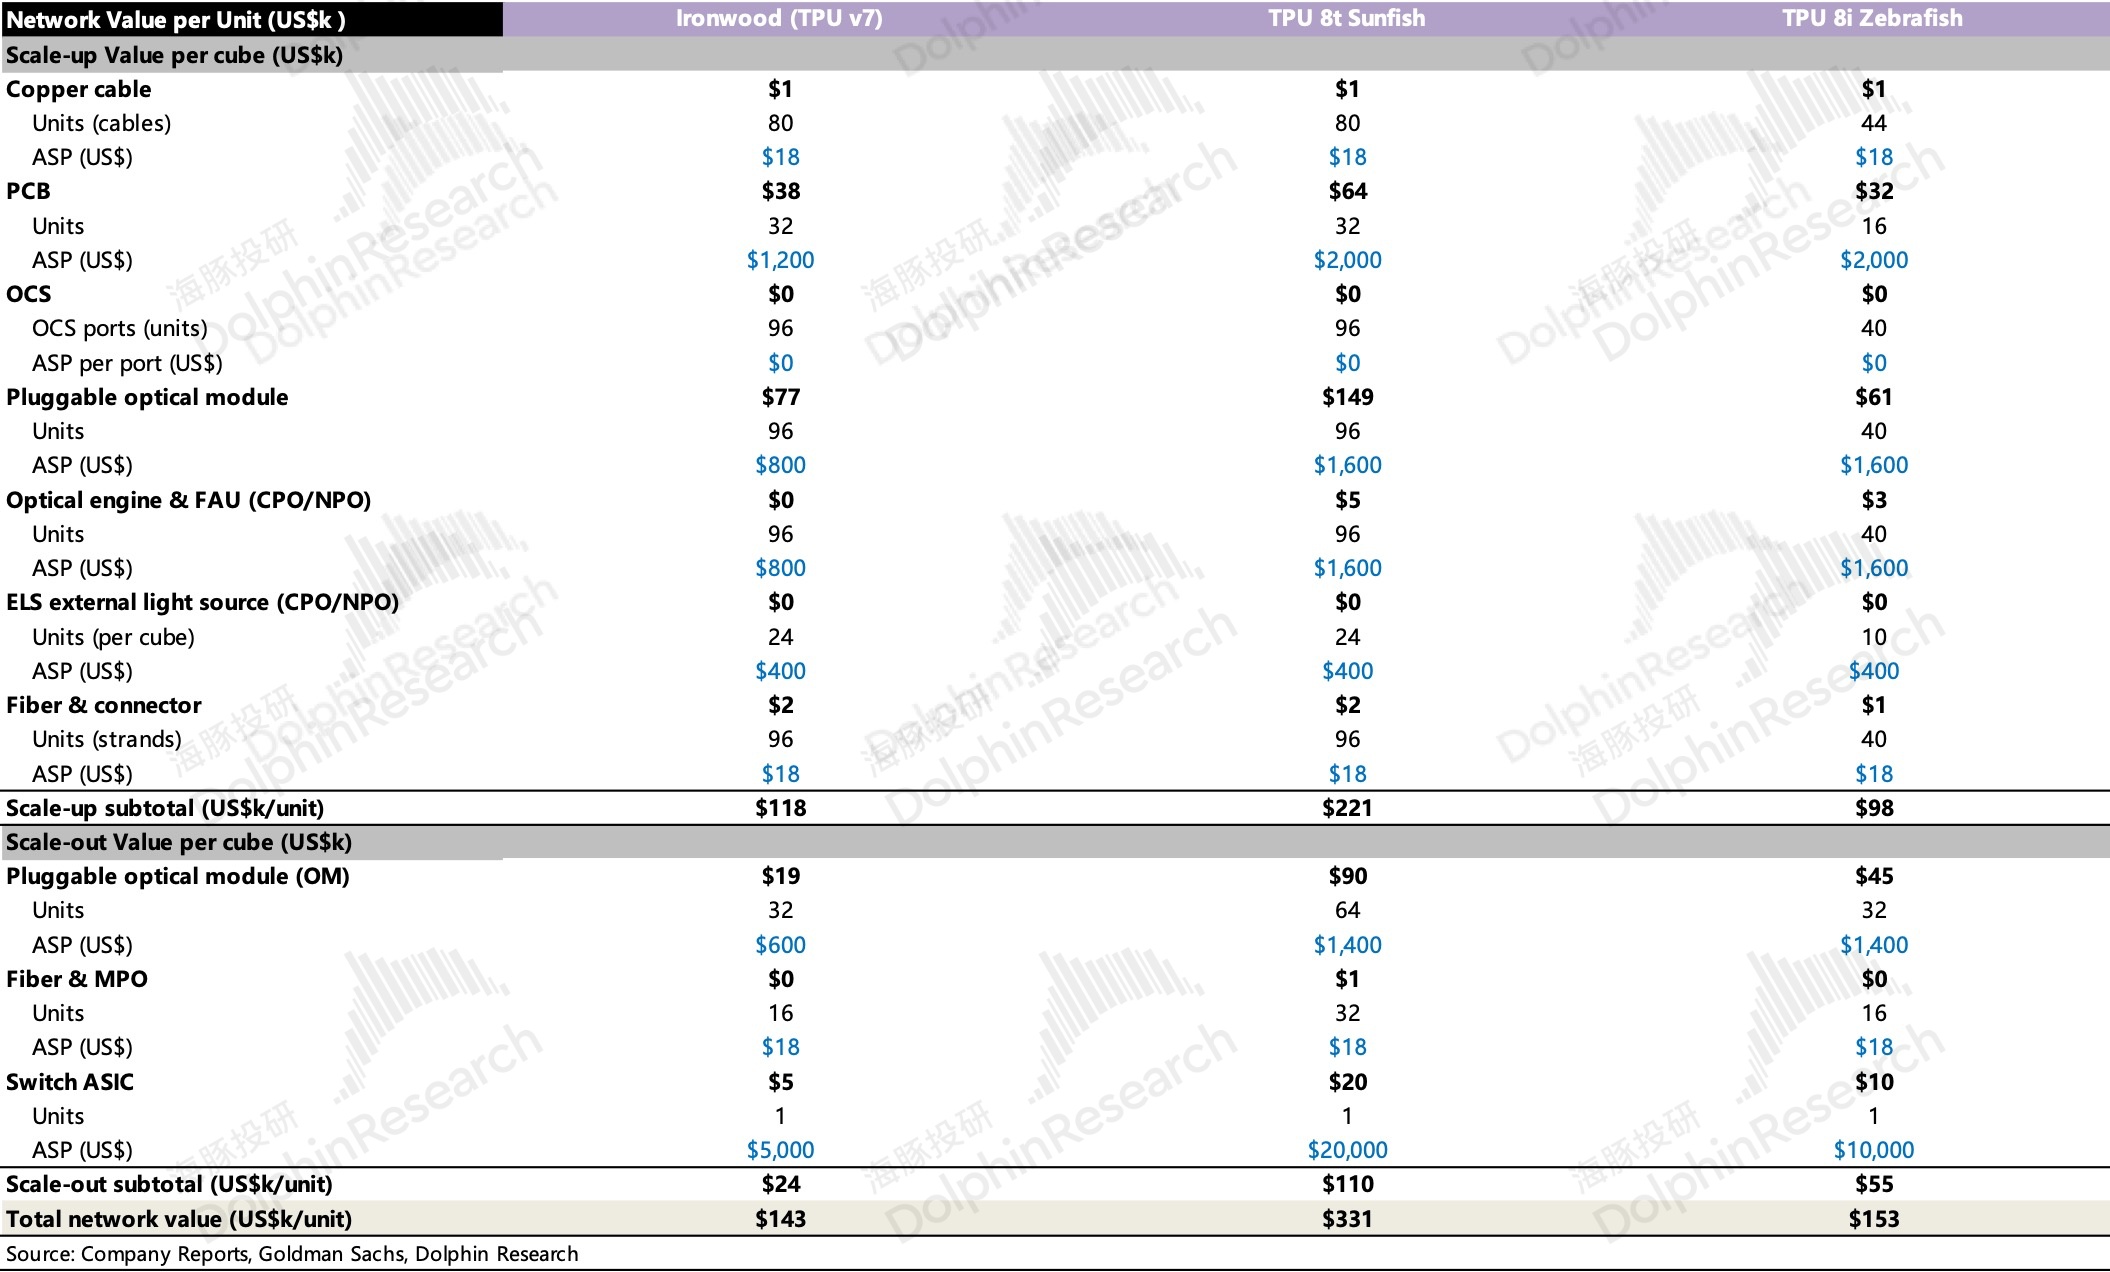
根據海豚君測算同等算力下的單芯組網成本,v7 極具性價比,算力與 GB300 相當,網絡成本只有三分之一。到了v8,兩顆芯片的分化本身說明了Google的組網思路:訓練芯片爲萬卡域付網絡溢價,推理芯片用小域把網絡成本攤薄。
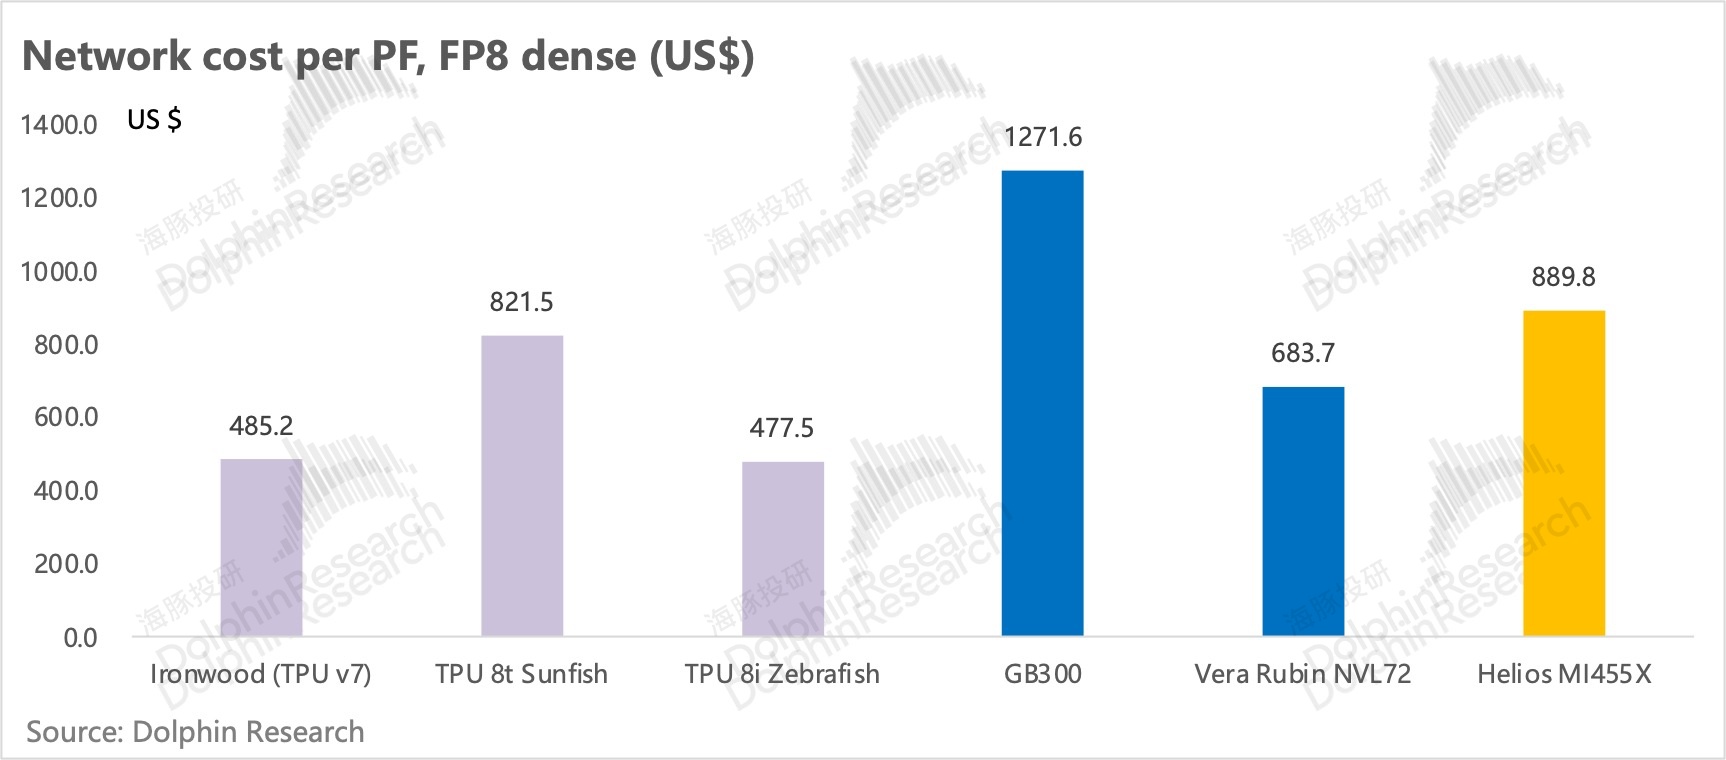
那麼在實際工作負載中又怎麼樣呢?我們就不能侷限於單芯片成本了,我們也在上文強調了OCS交換機替代Spine層將節省開支。
谷歌的v8t的拓撲下,每 9,600 顆一個 ICI 域,每個域 48 臺 OCS。域內規模擴大增加的是每臺的端口占用,交換機數不變(見下表);跨域後按域數線性增加。

例如10萬顆TPU的訓練集羣,谷歌只需約1000臺OCS,同算力下,Vera Rubin 胖樹架構下需要近2600臺交換機(144端口)。事實上只要在因此在大集羣項目中,或許確實能節省開支。
3、小結
回到競爭力的問題,顯然這不是簡單回答誰強誰弱的問題。如果說AMD是靠抄答案邁過及格線,那麼谷歌是完全換了解題思路。它沒有在英偉達的互連框架里正面硬剛,在這個框架中,跟隨者無論在產業鏈整合能力、方案迭代速度還是軟硬件協同能力上,都很難追趕上英偉達的步伐。
谷歌做的是充分發揮自己軟件棧的能力優勢,靠組網上的取捨換競爭力。單卡帶寬落後三分之一,多跳拓撲的延遲不及單跳,這兩項是谷歌自己選擇的代價;換來的是近萬卡的 Scale-Up域,以及每芯片約一半的組網成本。根據第三方InferenceX實測,Ironwood在原始性能曲線大部分區間裏跑不贏GB,卻在每芯片小時成本中勝出。
這一取捨的吸引力正在顯現:Anthropic 2025年7月就與谷歌簽訂了近100萬顆的TPU訂單,而在近期2,000 億美元的融資計劃中超75%與TPU掛鉤。TPU也將從谷歌的內部自用方案,轉向TPU-aaS的商業化,作爲可被外部前沿實驗室規模採用的算力選項,極有可能成爲英偉達的競爭對手。
四、產業鏈上有哪些核心標的?
1、一些類似邏輯的產業鏈
我們已經在上篇中對英偉達、AMD組網方案的產業鏈邏輯進行了梳理,事實上大部分核心標的也是與谷歌的供應鏈重複的,谷歌最爲特殊的OCS 及其器件鏈將在後文展開。
a. 從谷歌自身的組網演進迭代來看對產業鏈的影響:
- 計算托盤:最爲核心的下一代TPU ASIC的供應商將引入聯發科,我們已經對此進行了跟蹤點評,請參見。
- v8t:由於延續v7的拓撲架構,我們預期產業鏈不會產生較大的變動。
- v8i:面向推理場景優化了組網拓撲。硬件升級同樣帶來單位價值量的提升,但Boardfly拓撲相比 3D torus,互連器件用量普遍更少。
綜合來看,上文測算中的 v8t 並非性價比之選:折算到單位算力,它的網絡成本高於 Vera Rubin,只是在大規模集羣裏靠省掉 Spine 層的交換設備扳回一部分。而按谷歌在 Cloud Next 2026 的口徑,推理已佔AI加速器週期的70%以上,TPU 從訓推一體走向訓推分化後,若8t出貨不及預期,事實上是對谷歌鏈的利空。
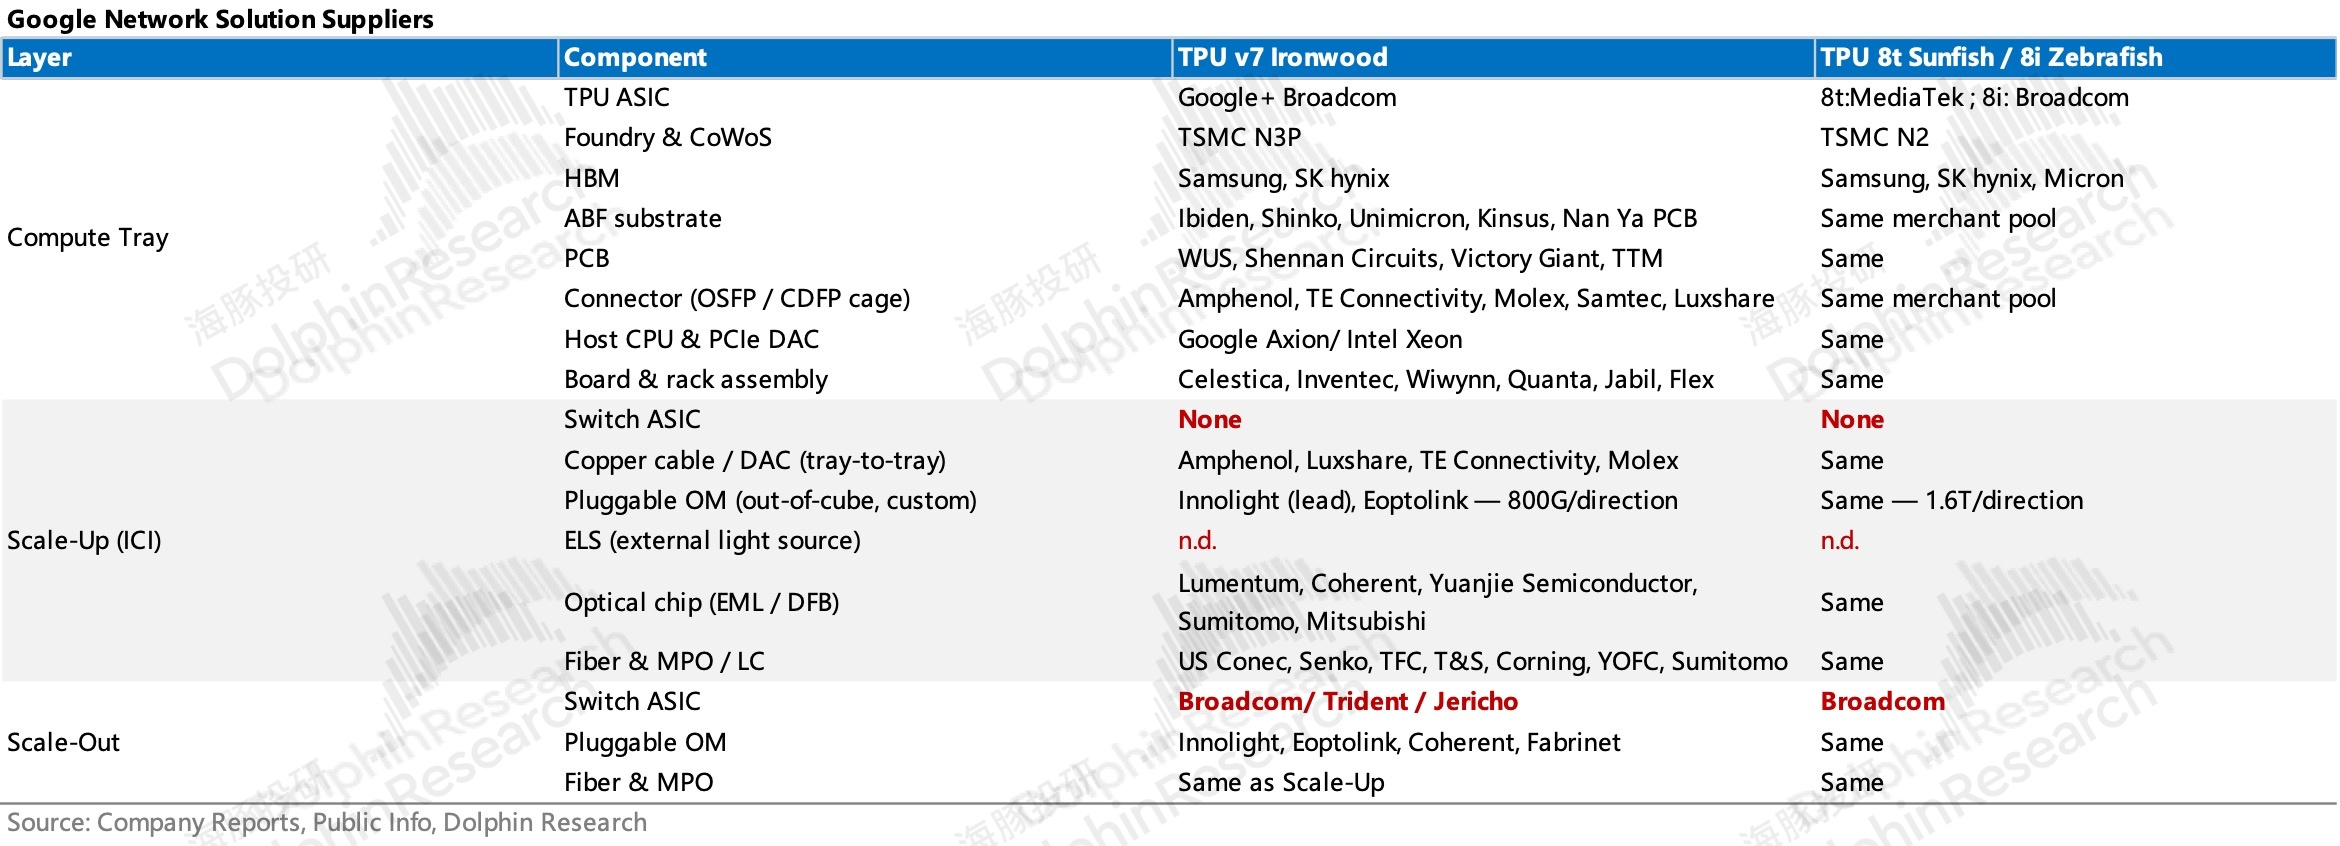
b. 從價值量角度考慮,谷歌的組網方案中價值量最高的環節毫無疑問是光連接,接着是PCB>交換>銅。
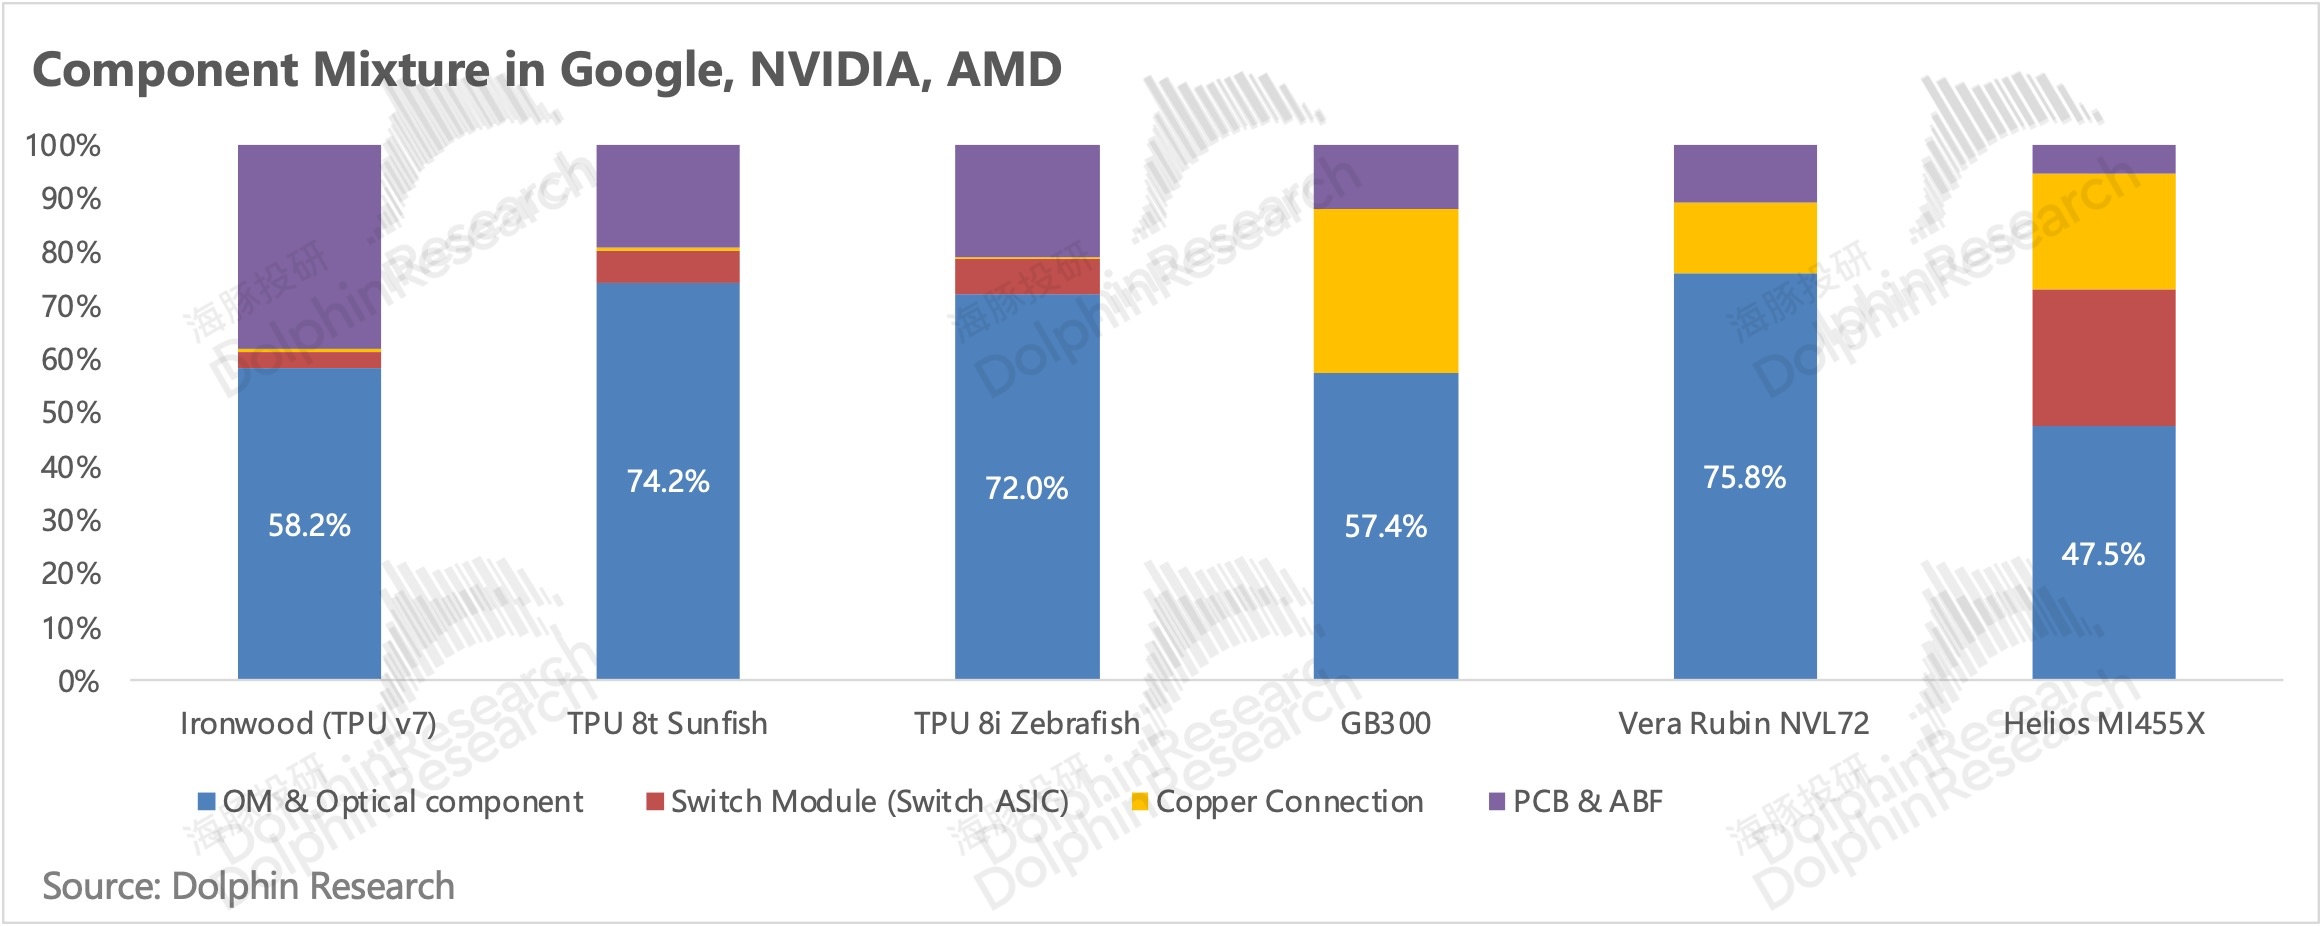
- 光模塊是增量最大的部分。不同於OCS交換機在組網方案中保持恆定48臺,我們測算的光模塊/TPU配比高達1.5,這意味着組網中每增加一顆TPU,就需要增加1.5顆光模塊。且速率提升(800G向1.6T)連同技術演進(可插拔向NPO/CPO)將帶來ASP提升,英偉達、博通等巨頭的入場,基本確立了其量價齊升的邏輯。具體內容請參見技術演進、產業鏈梳理。
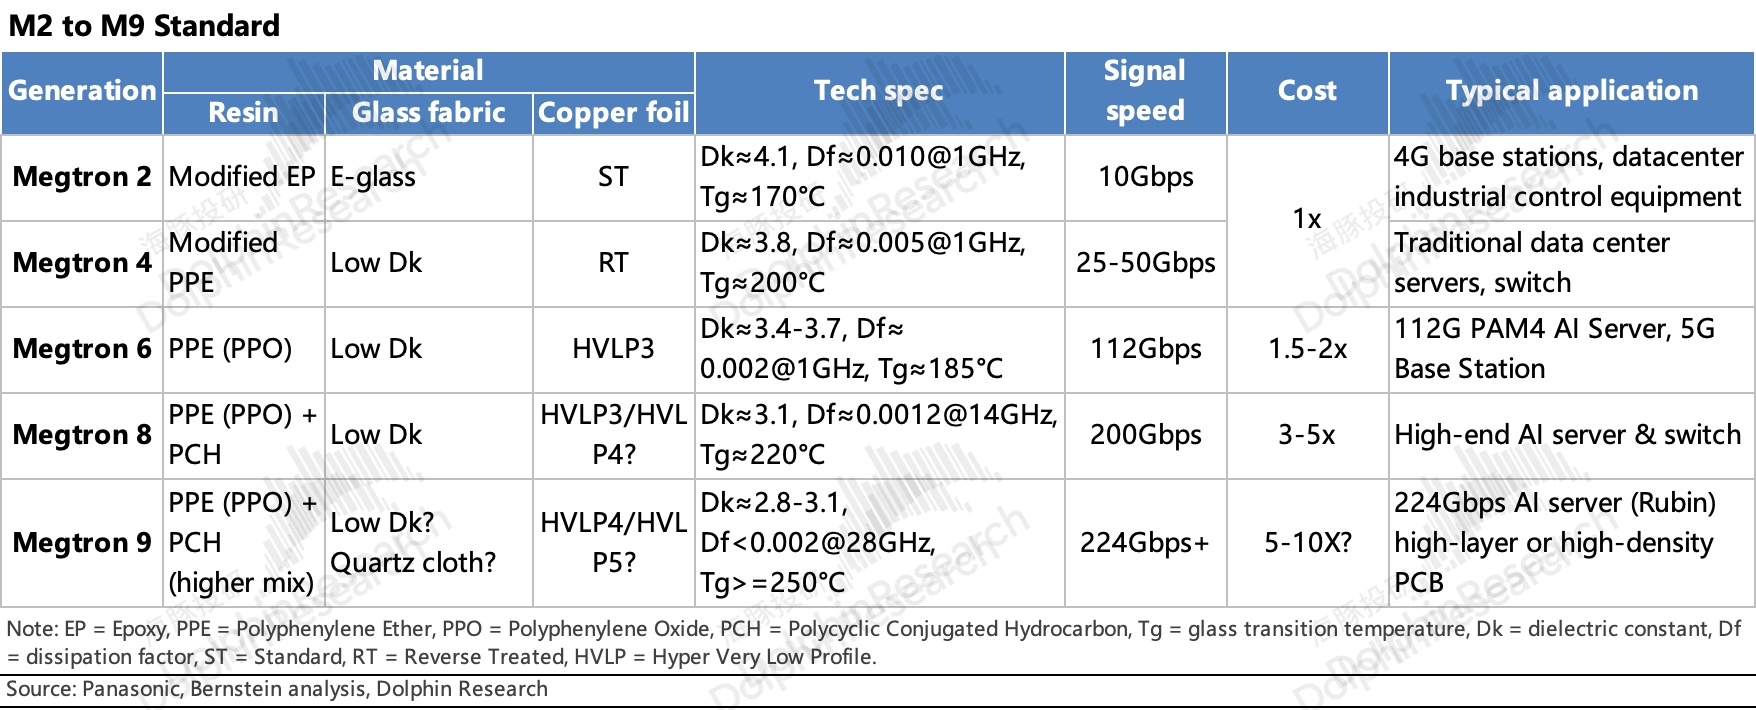
- 次高價值環節是PCB板,邏輯與英偉達方案類似,量價演進對PCB的面積、材料、層數提出更高要求;儘管直連拓撲設計使Ironwood對PCB走線傳遞信號的能力要求較爲寬鬆,但普遍預期8t將採用M9(松下制定的行業標準,即低Dk&Df,M2-M9的強度依次增強)的PCB板,提升該環節的ASP。量上由大規模組網推動。也是確定性較強的環節。
- 此處的交換ASIC指Scale-Out交換機內的芯片,主要由$博通(AVGO.US) 供應。當然我們也不能排除谷歌後續和$邁威爾科技(MRVL.US) 、$Astera Labs(ALAB.US) 合作,正如它對待TPU供應三心二意一樣。但這一增量只會存在於超出ICI域的場景。
- 銅纜在谷歌方案中基本是邊角料,且下一代方案拓撲架構的延續意味着也不會對DAC進行升級(如AEC),我們在下篇AWS中討論這一環節。
以上環節的產業鏈梳理請參考上篇。
2、核心差異是OCS產業鏈
OCS交換機涉及到了谷歌兩層的組網。市面上目前有四種常見的 OCS 技術路線(見下表),其中 MEMS 方案應用最廣、最成熟,光路相對簡單,代表廠商爲谷歌與$Lumentum控股(LITE.US) 。行業的演進方向是從"谷歌獨有方案"向"產業通用方案",MEMS-OCS 的滲透率有望進一步提升。
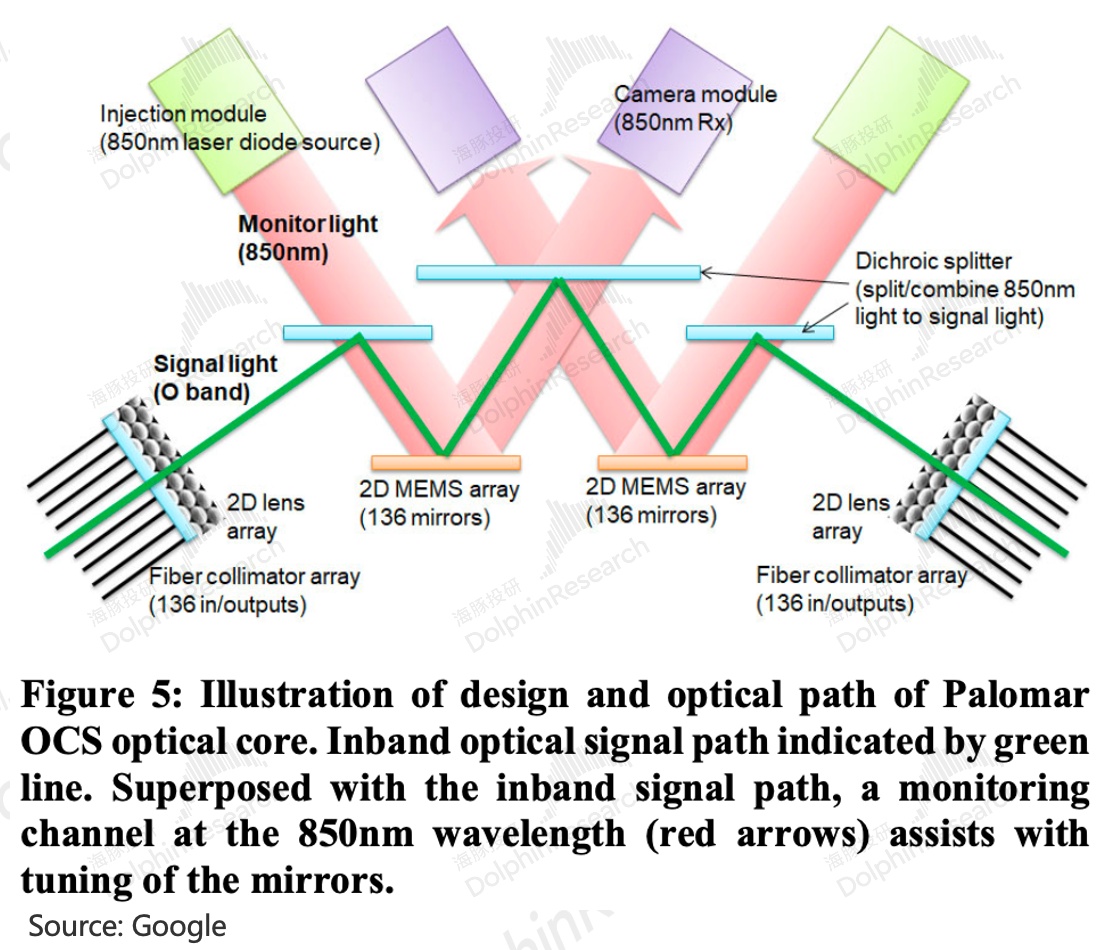
我們在前文說過,通過調整MEMS傾角就可以調整光路實現“交換”的功能,但是傾多少度纔算對準?光束要從1號口精確落進4號口那根比頭髮絲細得多的光纖芯裏,對各部件精度要求很高。按照光路順序:
- 光纖準直器陣列:光的進出口。光從光纖裏出來是散的,準直器把它梳成一束平行光;出口處反過來,把光收回光纖。
- 透鏡陣列:聚焦。保證光束落在鏡面和光纖芯的正中。
- MEMS 微鏡陣列(兩組):每面鏡子可雙軸傾轉,改傾角就改光路,相當於一排可轉動的道岔。
- 分色分束器:可理解爲按波長分流的"單向玻璃",透過一定區間波長的光,反射另一區間波長的光。用它把兩種光合到一起,或者分開。
- 注入模塊:發出探針光。
- 相機模塊:盯着探針光的落點。
谷歌的辦法是給信號光配一束"引路光":OCS 內有兩路光同路而行,1310nm 信號光承載業務數據,850nm 探針光專用於監測MEMS陣列的對準,探針光必須與信號光走完全相同的路徑,以反映信號光的偏差。但在輸出端口,我們只需要1310nm信號光,兩種波長光分離由分色分束器完成。
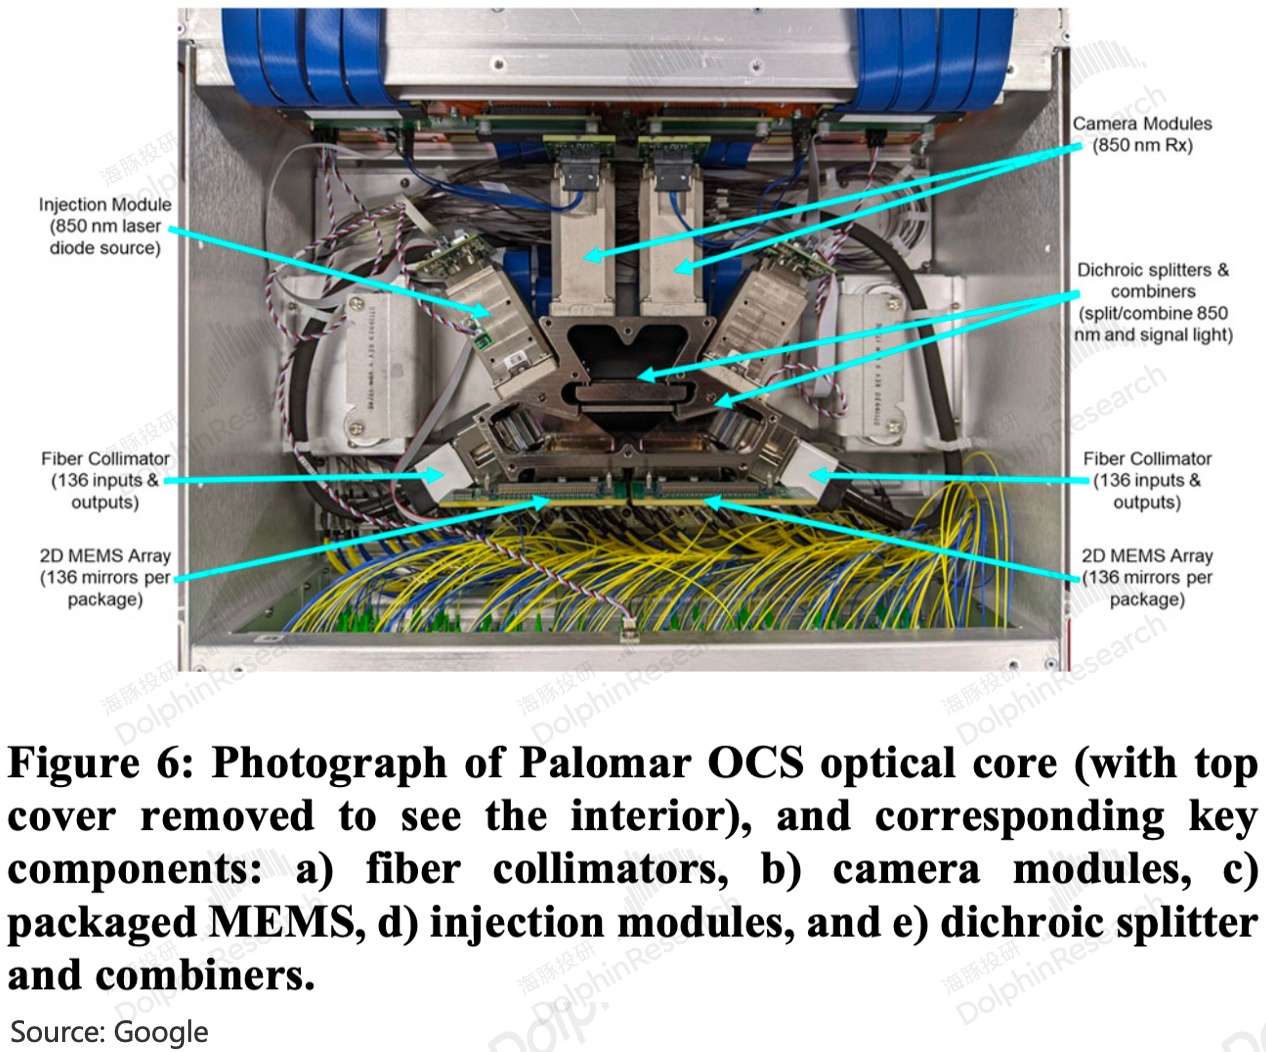
谷歌自研了整套系統的架構、注入模塊&相機模塊等控制部分。而上游的無源光學器件,包括MEMS微鏡陣列、分色鏡、光纖準直器陣列、透鏡陣列都是外採,佔到單機成本的60%-70%。因此,我們建議關注谷歌MEMS鏈條中的上游供應商,如下:
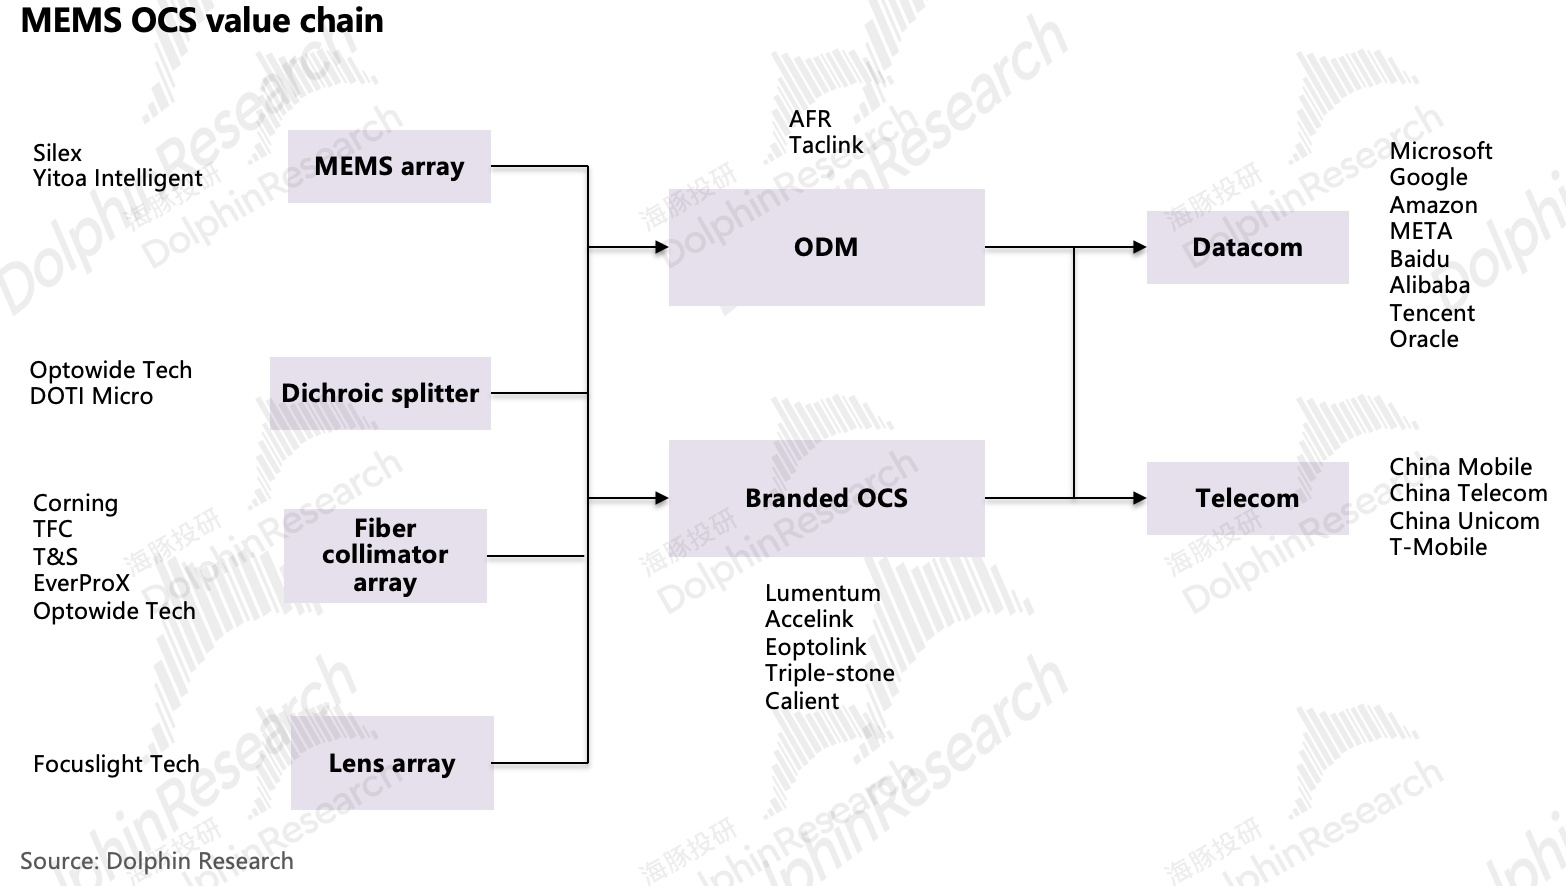
上游器件供應:
1)MEMS微鏡陣列:按價值量看最值得關注的是MEMS微鏡陣列中的芯片,佔單臺OCS物料成本約30%-40%。賽微電子通過瑞典Silex爲谷歌獨家代工 MEMS-OCS芯片,該芯片是谷歌TPU集羣光交換系統的核心組件。國內英唐智控下屬6寸MEMS晶圓廠(對標賽微 8寸產線),具備 MEMS 芯片陣列的生產能力。
2)分色分束器:騰景科技供應棱鏡、濾光片等 OCS 交換機核心光學器件,產品通過谷歌白名單,同時綁定谷歌光模塊供應商。客戶覆蓋 Lumentum、Coherent、光迅科技等。
國內東田微、海泰新光、水晶光電、福晶科技等在同一鍍膜平臺上從濾光片、二向色鏡、分光鏡切入,目前多處於送樣或試製階段。
3)光纖準直器陣列:康寧全球主供;太辰光、天孚通信爲二級供應商。騰景科技是Coherent在準直陣列上的第三方採購來源。
4)透鏡陣列:炬光科技是 Lumentum 在透鏡陣列上的核心供應商;同時正向Coherent送樣液晶方案2D準直器產品。
中游整機與代工:
谷歌2026年OCS規劃自產 12,000–14,000 臺、對外採購 6,000 臺,外採計劃由Lumentum與另一家平分(大概率是$Coherent Corp.(COHR.US) ),但因實際出貨未達預期,谷歌已向採用壓電陶瓷技術(DLBS)的Polatis下達訂單。國內進展較快的整機自供廠商有光迅科技,其MEMS微鏡陣列芯片、光纖陣列單元、精密耦合封裝工藝均爲全棧自研。
谷歌的代工廠主要是國內的光庫科技,市場普遍認爲其是谷歌MEMS-OCS第一大供應商,佔谷歌採購份額七成以上。
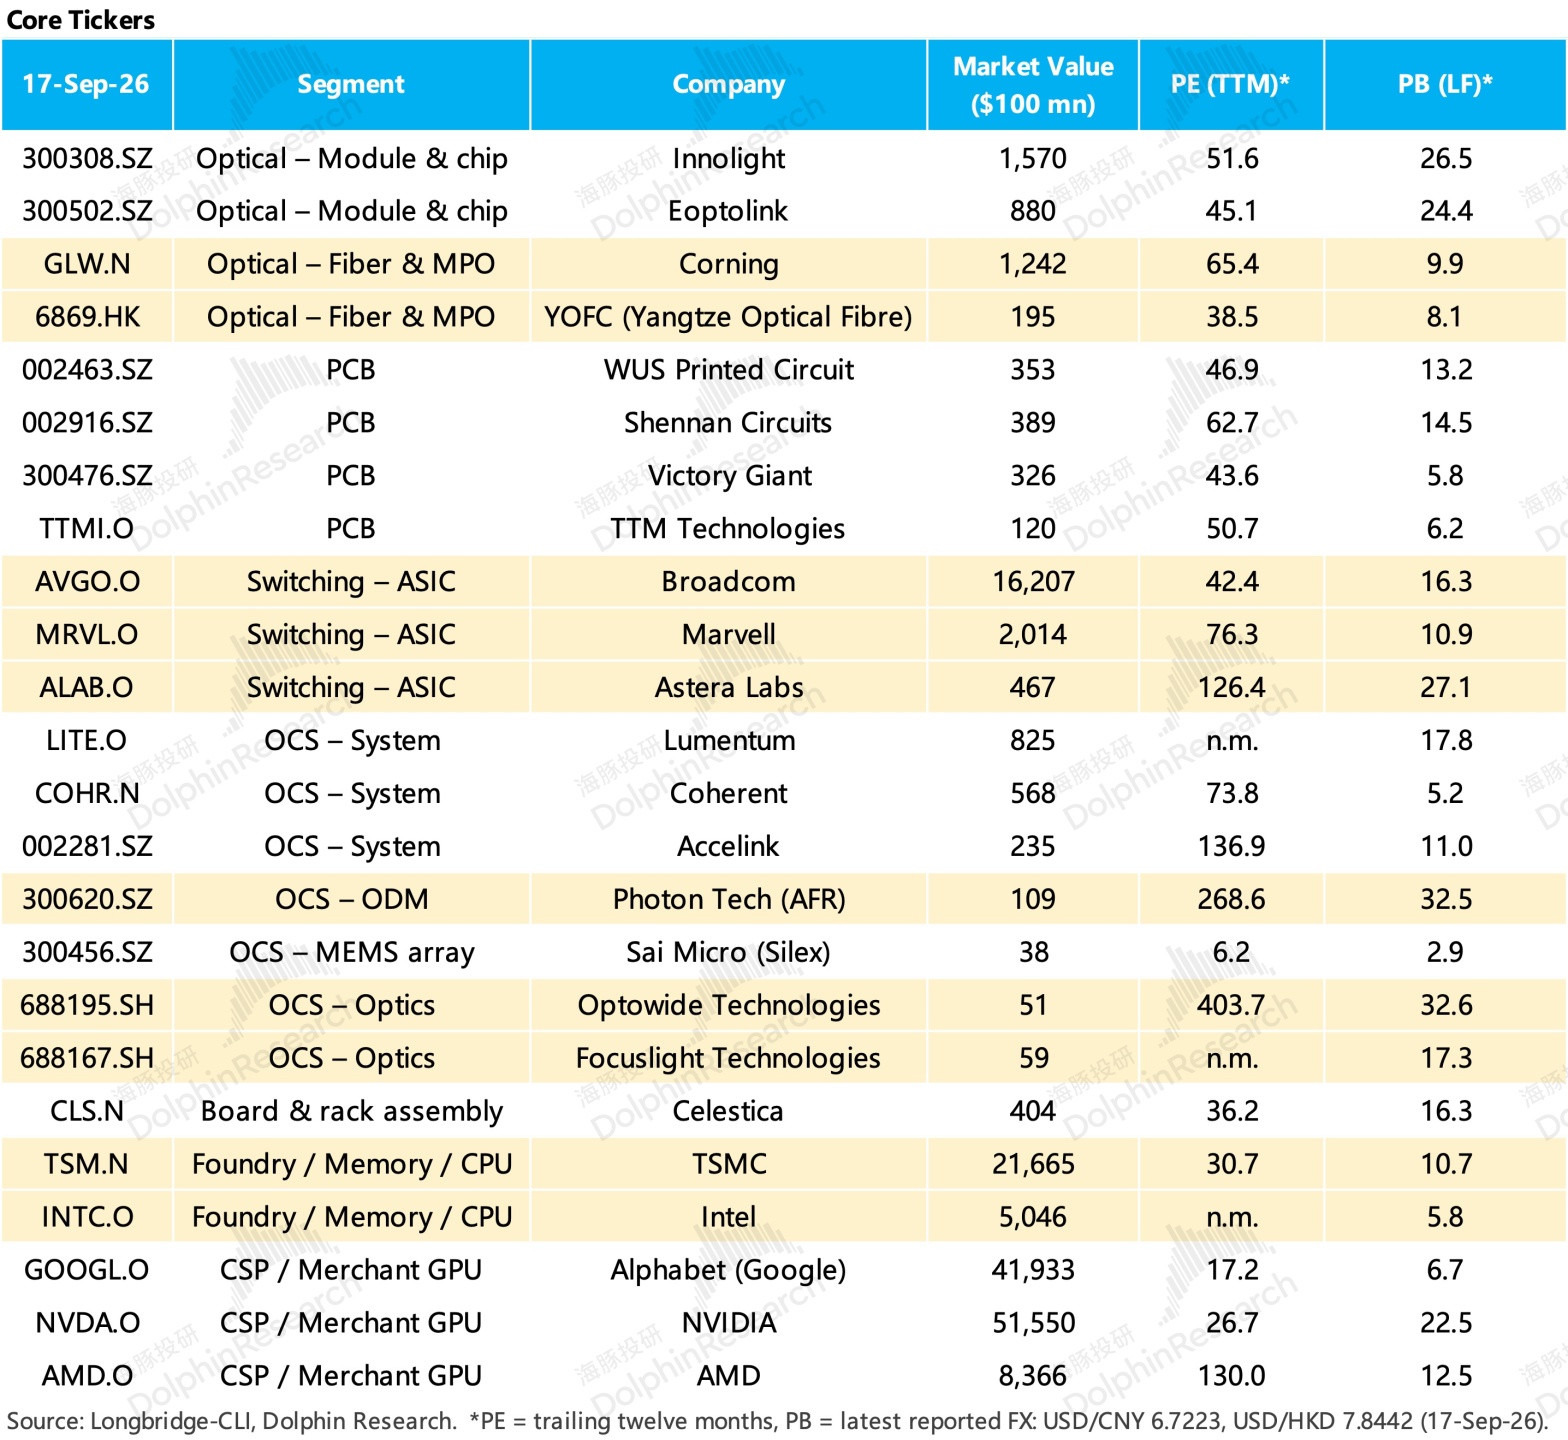
谷歌鏈條上的核心資產,海豚君整理如下:
下一篇將梳理AWS與華爲的組網方案,敬請關注!
<此處結束>
本文的風險披露與聲明:海豚研究免責聲明及一般披露
海豚君AI DC互聯繫列文章:
《AI 超連接時代:AI 向 “光” 飛奔?》
《“‘銅’ 牛夫人” 不走!CPO:真機會 or 鏡中花?》
《AI 時代 DC 互聯:單芯之上抱 “網” 作戰,真有 “中國” 機會嗎?》
《AMD 跟英偉達 “掰手腕”,Helios 夠格嗎?》







