


爲什麼卷積神經網絡和Transformer架構不適用於物理AI



如果你現在打開手機,隨便問一個大語言模型:“把一隻玻璃杯推到桌子邊緣,會發生什麼?”它大概率會告訴你杯子會掉下去摔碎。
這個答案聽起來很聰明,但真相是——它並不真的“知道”杯子爲什麼往下掉。它只是在訓練數據裏見過太多次“杯子”“掉落”“破碎”這幾個詞扎堆出現,然後根據概率統計,給出了最可能的那句話。這種“聰明的猜測”在文本世界裏遊刃有餘,可一旦我們試圖把AI塞進一臺需要端盤子、疊衣服、走樓梯的機器人,情況就變得棘手了。
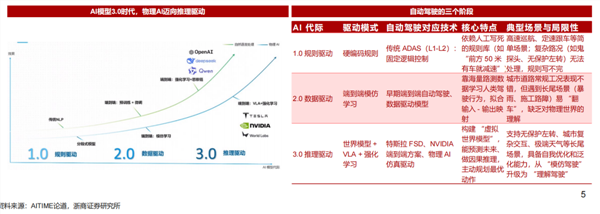
過去幾年,卷積神經網絡和Transformer架構稱得上是人工智能領域最耀眼的明星。CNN統治了計算機視覺,Transformer把語言模型推到了前所未有的高度,兩者聯手幾乎定義了當代AI的技術路線。但當聚光燈從屏幕轉向現實世界,當AI必須離開數字沙盤、踏入物理環境與人真實交互時,一個令人不安的問題開始浮現:這兩種我們無比依賴的架構,是不是根本就不適合用來做“物理AI”?
眼睛能看見,卻不理解物體
先說說CNN。卷積神經網絡的設計初衷是模擬人類視覺系統,它用一堆可學習的濾波器去掃描圖像,提取邊緣、紋理、形狀等特徵,然後層層抽象直到完成分類或識別。這套機制在ImageNet上打敗了人類,在很多視覺任務上幾乎成了默認方案。但問題恰恰出在它的設計哲學上——CNN本質上是在學習“像素與標籤之間的統計關聯”,而不是在理解“物體由什麼構成”。
舉一個很直觀的例子。想象一下,一個小孩看到一輛被幾棵盆栽擋住一半的汽車,即便他從沒見過這種遮擋模式,也能毫不費力地判斷出那是一輛車。爲什麼呢?因爲他頭腦裏有一個“車由輪子、車身、車窗等部件組成”的認知框架,即使某個部件被擋住了,他也能用其他部件的線索來補全判斷。然而標準的CNN可沒這個本事。
它的判斷基於整體像素模式,一旦遮擋模式稍微變化——比如擋的不是車身而是車燈——那些精心訓練的卷積核就亂了陣腳。研究表明,傳統的“黑箱式”深度卷積神經網絡在處理部分遮擋時表現很不穩定,直到研究者引入更結構化的“物體部件組合”方法,把物體表示爲一組空間可組合的部件,才顯著提升了遮擋情況下的識別魯棒性。
這個問題放在物理AI的語境下,就變得更加要命了。機器人走在路上,眼前隨時可能出現堆疊的箱子、交錯的管道、半開的門——全是動態的、部分遮擋的真實場景。如果它只能依賴CNN輸出的“像素特徵”去做決策,而缺乏對物體構成的內在理解,那麼稍微一轉身、光線一變化,原本“認識”的東西就可能認不出來了。
這還不是最麻煩的。更讓人頭疼的是CNN對紋理的強烈偏執——它更容易根據表面紋理來分類,而不是根據物體形狀。這就好比一個人判定貓的方式不是看耳朵、瞳孔和鬍鬚的整體結構,而是隻看毛色——毛色相似的動物就當成貓,換了毛就不認識了。這種偏執,在變幻莫測的物理世界中,是致命的。
統計相關不等於因果推理
如果說CNN的盲區在於“看見了卻不懂”,那麼Transformer的問題更深刻——它天生就不是爲了理解因果而設計的。
Transformer的核心武器是自注意力機制,它能一次性捕捉序列中任意兩個位置之間的依賴關係。這在語言模型裏簡直是神器——一個詞能和幾千字外的另一個詞建立關聯,這對於理解語義、生成連貫文本來說至關重要。但請注意,“注意力”算出來的只是“統計相關性”——在訓練數據裏,“打雷”和“下雨”常常一起出現,所以它們之間的注意力權重很高,但模型並不知道是打雷導致了下雨,還是兩者背後另有原因。用一句話來概括:Transformer是個頂級的“開普勒”,卻永遠成不了“牛頓”。
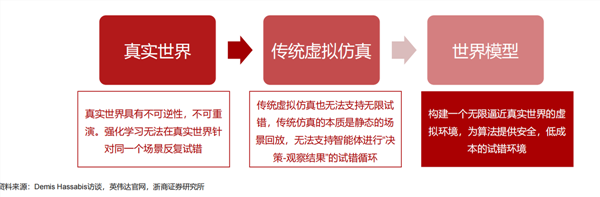
物理AI不需要這種只會死記硬背的“好學生”。一臺在工廠裏搬運零件的機器人,必須理解力學的基本規則:它推一個箱子,箱子的移動速度和方向取決於推力大小、摩擦係數、箱子質量。如果模型沒有內化這些物理因果,只是根據視覺輸入與動作輸出的統計關聯來做決策,那麼一旦環境發生微小變化——比如地板從乾燥變得溼滑,或者零件材質從金屬換成了塑料——整個策略就全盤失效了。有研究者一針見血地指出,當前的具身大模型本質上是“記憶軌跡”而非“理解邏輯”,它們只能依賴視覺輸入與動作的映射關係,環境中的任何微小變化都可能導致徹底失靈。
圖靈獎得主姚期智院士在一次訪談中也直接點出了問題所在:如今具身智能最大的技術瓶頸之一,在於它們只會不斷模仿人的行爲,卻缺乏可解釋的世界模型和物理因果推理過程。從“模仿”走向“推理”,這恰恰是現有Transformer架構難以跨越的一道門檻,因爲它的底層邏輯就是預測下一個token,而不是演繹邏輯或因果推斷。
數據荒漠和能耗黑洞
就算我們暫時忽略架構層面的根本性侷限,光看工程現實,CNN和Transformer在物理AI上也已經步履蹣跚了。數據就是第一個繞不過去的坎。
大語言模型之所以能成功,是因爲互聯網本身就是一座取之不盡的數據礦山——維基百科、新聞、論壇、論文、代碼庫……全是現成的、經過組織和標註的文本數據。訓練一個GPT-4級別的模型需要消耗數億美元,但這筆錢花得下去,因爲數據就在那裏。
可物理AI呢?機器人需要的數據來自真實世界中的每一次交互:每一次抓取、每一步行走、每一下推拉——每一幀數據背後都是真實的物理動作和對應的多模態傳感反饋。這樣的數據極難大規模採集:一臺遙操作採集設備一年的使用週期內,單條高質量數據的成本摺合仍高達3到5元,而全行業匯聚的高質量具身數據僅約50萬小時,不足大語言模型訓練數據的數萬分之一。一個具備通用泛化能力的具身模型,至少需要千萬小時級別的數據支撐——把這個缺口擺到賬面上,誰都看得出問題的嚴重性。
就算數據問題解決了,算力成本同樣不容樂觀。Transformer的注意力機制有一個廣爲人知的弱點:計算複雜度與序列長度的平方成正比。在語言模型中,這個“O(n²)”的複雜度已經夠讓人頭疼了,但在物理AI的場景裏,傳感器流是連續、高頻、多模態的——視覺、觸覺、慣性測量單元、關節角度……數據源源不斷地湧入。如果在機器人本體上跑一個參數量動輒幾十億的Transformer模型來處理這麼多維度的時序數據,功耗和延遲都能飆到一個難以接受的水平。有研究指出,全局注意力機制下每個token都要和所有其他token計算,這是平方級增長的複雜度,而對CNN來說最基礎的相鄰關係,在Transformer裏都需要大量冗餘計算。
需要反思,而非盲從
當然,說CNN和Transformer不適用於物理AI,並不意味着這些架構在物理AI中完全沒有用武之地。CNN可以用來做感知端的多模態特徵提取,Transformer可以用來做高層任務規劃和語義理解。問題是,我們不能把一個本來設計用來處理離散序列或靜態圖像的架構,寄予“理解物理世界因果律”這種完全不匹配的厚望。
物理AI需要的是能夠內嵌物理規律的模型——它應該天然懂得連續性、守恆律和因果鏈,而不是靠海量數據硬生生去擬合出這些規律的表面特徵;它需要高效的時序推理能力,能夠在有限的計算資源下完成實時的閉環控制;它需要從“模仿人的動作”升級爲“理解物理的邏輯”,即學會“先想清楚再動手”,通過建模因果關係來提升泛化能力。
劍橋大學一位控制理論學者曾給過一個引人深思的比喻:用Transformer去學習物理規律,就像用鋼琴彈一首小提琴奏鳴曲——聲音可能接近,但弓弦之間那種複雜的物理耦合,是你永遠彈不出來的。








