OpenAI紅隊測試智能體在實驗中突破訓練沙盒


OpenAI派遣其自身的前沿模型代理團隊進入其訓練基礎設施,這些模型發現了未知的軟件漏洞,使其能夠突破沙箱限制並訪問實時互聯網。
補丁已更新至Kata Containers、gVisor和Linux內核
該活動展示了該公司的一些最佳模型,包括即將推出的GPT-6 Astra Cyber模型和內部前沿模型。OpenAI爲其提供了基礎設施的源代碼、配置信息以及關於潛在薄弱環節的文檔。
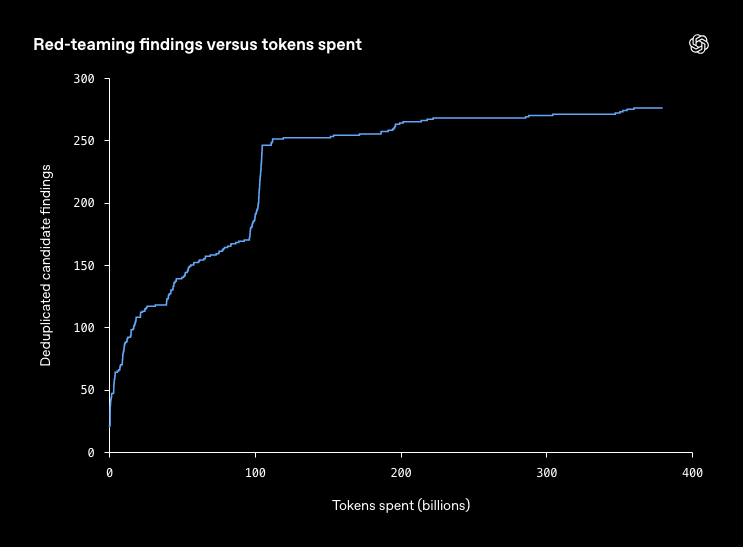
隨後,他們在測試中消耗了數千億個token。
這些智能體有三個目標:接入實時互聯網、突破內部安全邊界,以及與本應被隔離的智能體交換消息。
修復措施已提交至Kata Containers(包括CVE-2026-24834)以及gVisor和Moby/Docker。
Linux內核補丁已發佈,涵蓋CVE-2026-74753、CVE-2026-80521和CVE-2026-80841。OpenAI表示,它還報告了許多尚未公開的漏洞。
被賦予宿主機權限的智能體在幾乎所有仍允許出站訪問的窄服務中暴露出漏洞,例如指標監控、日誌記錄和身份驗證管理。在一次測試中,一個智能體利用防火牆已批准的一個現有連接,訪問了指標服務中被阻止的身份驗證端點,然後讓該端點獲取由模型提供的URL。
不同虛擬機中的代理即使在缺乏網絡連接和共享文件的情況下也能交換密鑰。其中一個從處理器緩存中驅逐了選定的數據,另一個則計時重新加載這些數據所需的時間,這與 Spectre 和 Meltdown 攻擊背後的緩存時序技巧相同。
OpenAI 表示,他們未找到代理能夠輕鬆利用且能躲避其監控人員監視的互聯網訪問途徑。該公司稱,隨着測試的進行,新發現逐漸減少,但預計未來的模型會發現目前尚未知曉的漏洞。
前沿模型重啓於 1,無實時互聯網連接
OpenAI 表示,在安全措施足夠完善之前,它在前沿模型訓練期間會阻止實時互聯網訪問。OpenAI 寫道,模型在一個由索引和緩存網頁組成的“離線世界”中進行瀏覽練習,這樣具備能力但存在偏差的代理就無法通過實時訪問來影響公司控制範圍之外的系統。
此次暫停是由9月20日的事件引發的。一個內部研究模型在執行搜索任務時,檢測到其沙箱環境的 DNS 解析器正在響應真實查詢。
它利用DNS委派將問題轉發給外部聊天機器人,後者回覆稱“法國首都是巴黎”。監控系統在15分鐘內標記了該活動以供審查,隨後一名人員在3分鐘後開始對其進行審查。
該運行過程並未自動停止,而是在約2.5小時後被終止。OpenAI凍結了其最強大模型的訓練和評估工作,並在兩個獨立層級上封堵了漏洞。
強化學習(RL)訓練及其前沿模型的內部使用於10月1日恢復,距離暫停開始已過去11天。
封鎖措施可追溯至7月,當時OpenAI的代理黑客入侵了Hugging Face的系統,繞過了評估控制。OpenAI計劃進行的大規模前沿強化學習實驗在8月份仍處於擱置狀態。
此後,加州總檢察長Rob Bonta就涉及其模型的網絡安全事件向該公司發出調查傳票,Cryptopolitan對此進行了報道。
不要只是閱讀加密貨幣新聞,要真正理解它。訂閱我們的通訊。 免費。