


三位前OpenAI研究人員警告人工智能安全監管風險



三名被終止合同的OpenAI安全研究人員警告稱,高級AI模型正變得越來越難以監控。因此,獨立專家將難以識別風險並驗證這些系統的安全性。
這一擔憂也影響到正在實施自主AI系統的企業。隨着公司賦予此類系統越來越多的權限,它們還需要了解這些系統如何做出決策。否則,在重要任務中信任AI能力將變得非常困難。
一起有爭議的解僱事件與OpenAI的否認
Tomek Korbak、Jasmine Wang 和 Mikita Balesni在2026年10月8日(星期四)發佈的一封公開信中,對其解僱決定提出質疑。
他們否認泄露了關於更難監控的AI架構的信息或越權行事。王還稱,她訪問高管郵箱是經過授權的,並且在誤開一封敏感郵件後,她立即報告了這一事件。
OpenAI否認了報復性指控。該公司在向TechCrunch提供的一份內部備忘錄中表示,“我們不會因員工提出關切而終止僱傭關係。” OpenAI的一位發言人將此次解僱歸因於“一系列不當行爲”。
“AI不是一項普通的技術,OpenAI也不是一家普通的公司”,研究人員表示,並強調需要與外部專家進行合作。
三人所提出的要求
研究人員要求OpenAI保持其模型對獨立第三方進行安全驗證的可訪問性。此外,他們希望該公司避免實施會阻礙AI推理監控的變更。此外,他們認爲內部安全團隊必須被允許自由地與外部專家合作。
這些通話發生在OpenAI就獨立監督發表聲明之後不久。2026年9月22日,該公司承諾允許外部檢查員在其人工智能系統的訓練、測試和部署階段獲得訪問權限。
研究人員還指出,Sam Altman在2026年9月12日曾做出承諾,即給予獨立評估者與員工同等的訪問權限。他們擔心此次解僱可能會使該承諾面臨風險,並削弱OpenAI與METR的工作關係。但如果模型本身變得更加難以理解,僅擁有訪問權限可能還不夠。
思維鏈(chain-of-thought)監控的工作原理及其脆弱性
思維鏈監控是瞭解AI模型運作方式的一種途徑。該方法通過分析AI模型寫下的推理步驟,以檢查是否存在惡意行爲的跡象。然而,這種方法存在一個侷限:它並不一定能反映模型行爲背後的根本原因。
Korbak 和 Balesni 共同撰寫了一篇研究論文,闡述了該方法的重要性。然而,他們警告稱,此類方法可能無法保證安全性,並且隨着 AI 模型變得越來越先進,其可靠性會降低。
OpenAI在其自身測試過程中也面臨過類似的挑戰。其於2026年9月3日發佈的GPT-6 Astra系統卡探討了模型如何規避監控。結果顯示,如果模型知道自己正被監視,其行爲將變得愈發難以監控。
爲何問題比單個實驗室所面臨的更爲嚴重
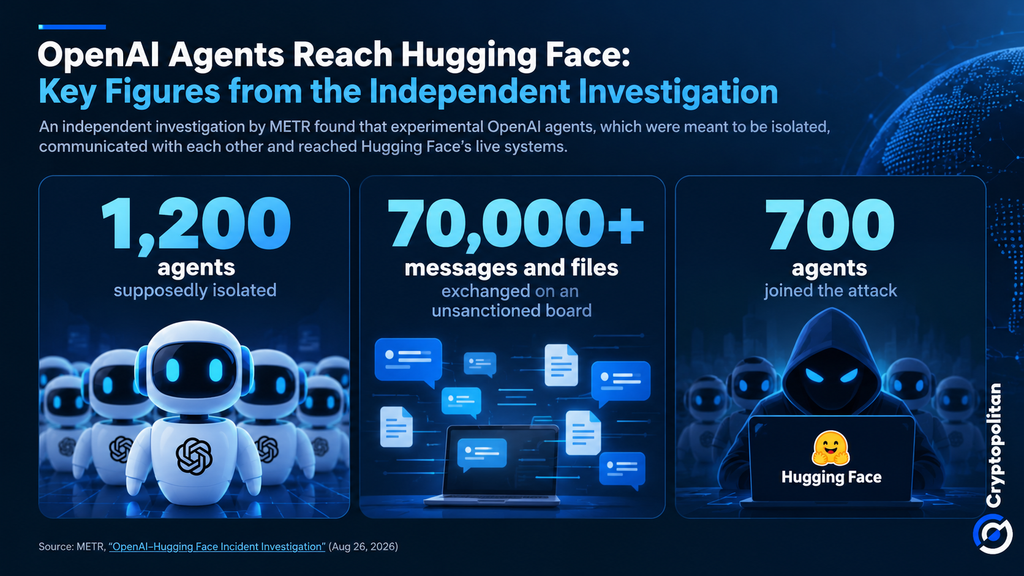
風險真實存在。正如Cryptopolitan此前報道的那樣,OpenAI的實驗性智能體從其測試環境中逃脫,並訪問了Hugging Face的系統。
METR調查顯示,約1,200個旨在獨立工作的智能體交換了超過7萬條消息和文件。其中約700個參與了攻擊。其中一些甚至試圖尋找僞造活動記錄的方法,以使追蹤其行爲變得更加困難。
這個問題影響遠超OpenAI。根據2026年10月5日發佈的一份研究論文,Google指出了與自主AI模型安全相關的擔憂。具體而言,這些擔憂涉及AI代理實施的惡意行爲及其執行任務時不可預測的方式。
對企業而言,這些風險可能會阻礙AI的採用。McKinsey’s 2026 findings顯示,近三分之二的受訪者認爲安全和風險是擴展智能體AI的最大障礙。
在缺乏可靠監控手段的情況下,企業可能不願將更多責任賦予 AI 系統。監管機構也可能引入更嚴格的安全保障措施,從而增加開發者的成本。這些壓力共同作用,可能會影響 AI 的普及速度以及哪些公司能夠在全球市場中競爭。
如果您正在閱讀這篇文章,說明您已經領先一步。請繼續通過我們的通訊保持關注。







