


AWS 组网靠「买」:谁是 Trn3 背后的卖水人?


上篇(见链接)海豚君拆解了 AWS 的两步 “省事棋”:Scale-Up 协议 NeuronLink 实为套壳 PCIe,图的是快速交付;Trn2 全铜 “拼” 出的 3D torus 止步 64 卡,AWS 由此从谷歌的直连派转向英伟达的交换派。
那么,主力机型 Trn3 如何用标品 “买” 出交换式组网?和 GB300 差在哪?AWS 链的钱又流向了谁?下篇继续拆解。
以下是正文:
一、Trn3:「买」出来的交换式
1、与 GB300 类似的机架形态
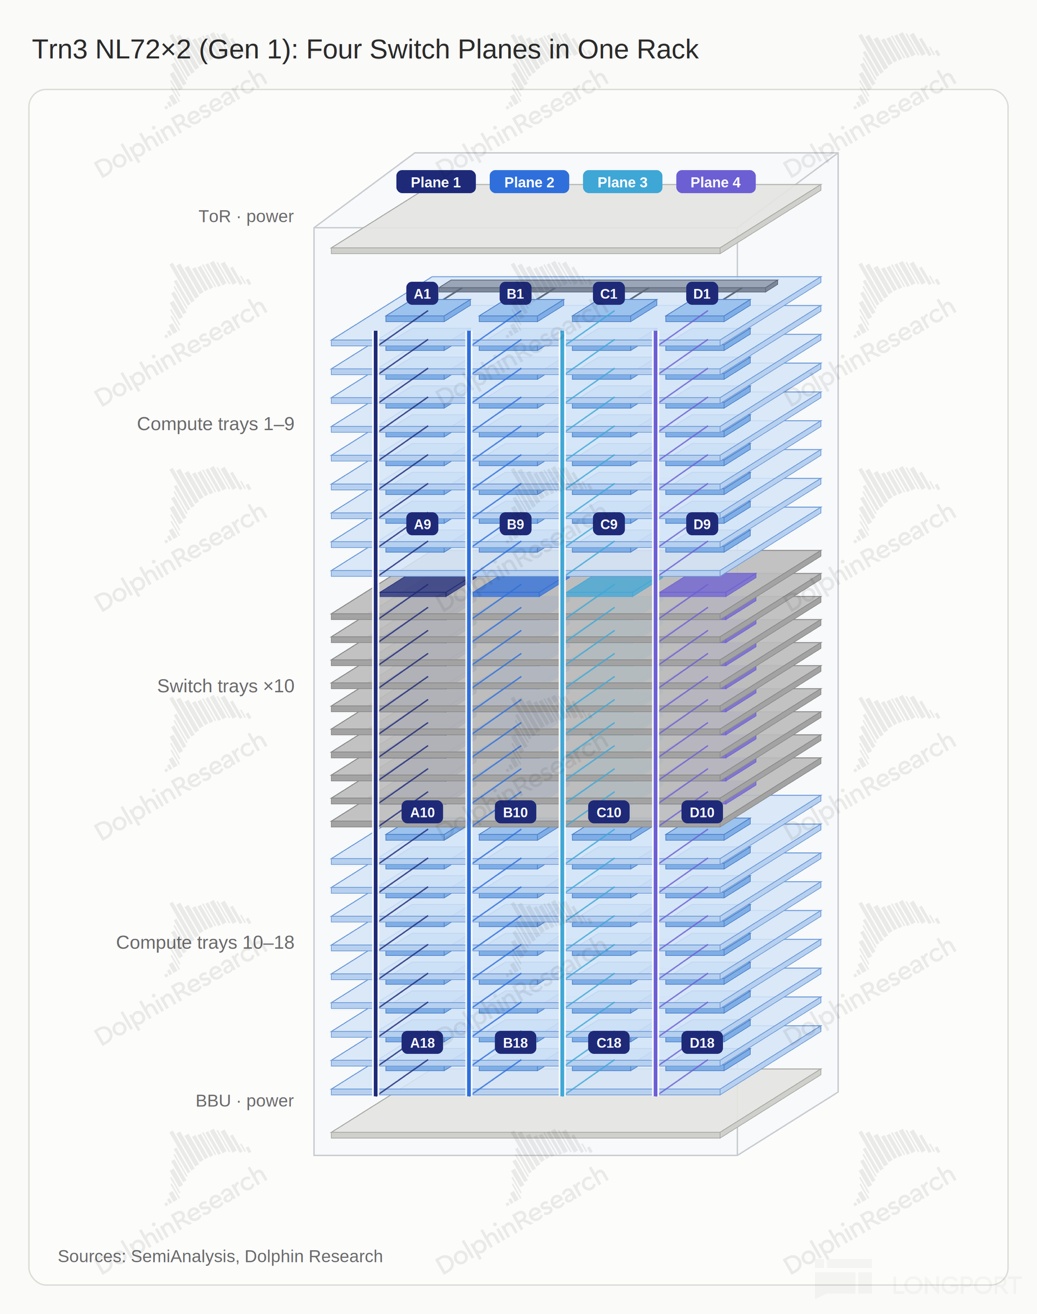
以主力机型 Trn3 NL72x2 为例,该方案基本照搬了英伟达 NVL72 的交换式架构,包括 72 卡一柜,柜内托盘 “三明治式” 的摆放等(计算托盘 - 交换托盘 - 计算托盘)。
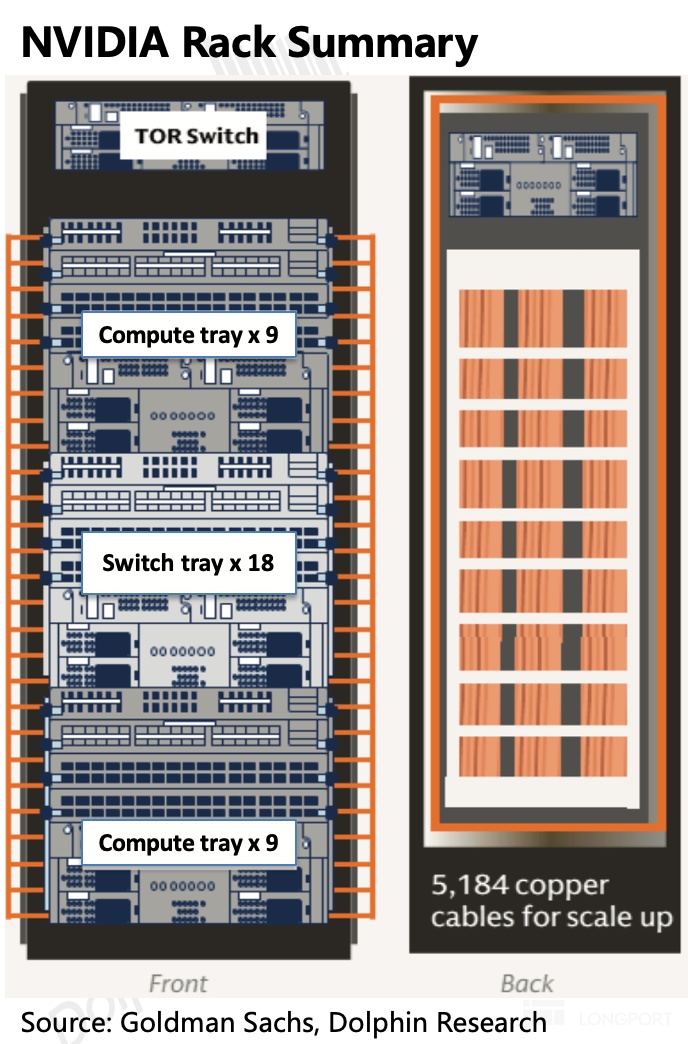
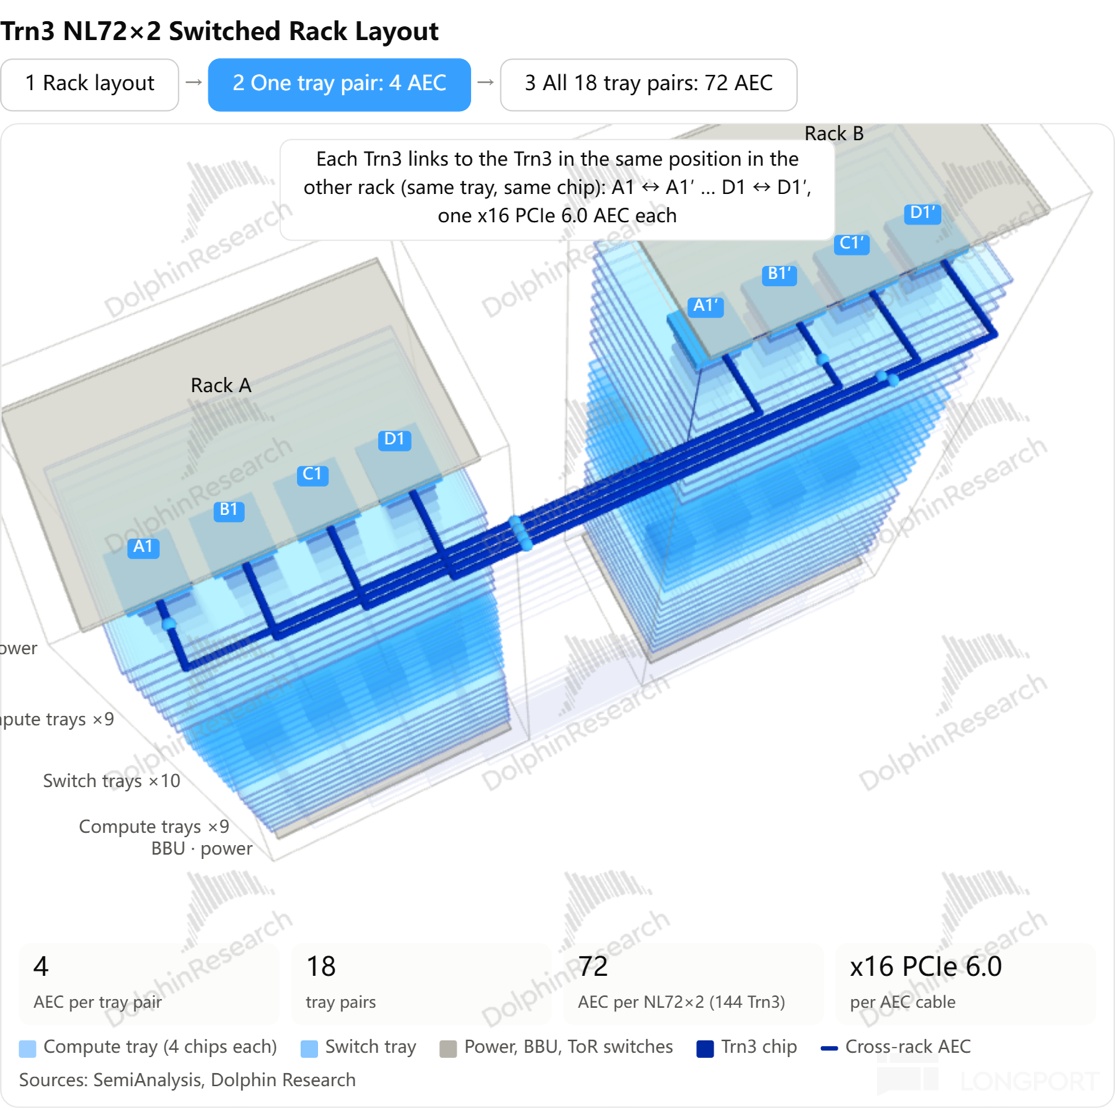
而之所以被称为 Trn3 NL72x2,是因为两个 72 卡的机架作为一个可交付的 SKU(即 144 卡的 Scale-Up 域),机架之间是通过有源铜缆(AEC)连接的。
跨柜使用 AEC 的原因是无源铜缆物理距离受限,而光模块又贵又易坏,相邻机柜之间的短距连接,AEC 确实是合适的选择。两柜之间,机柜内相对位置相同的芯片通过 AEC 两两直连,如下所示:
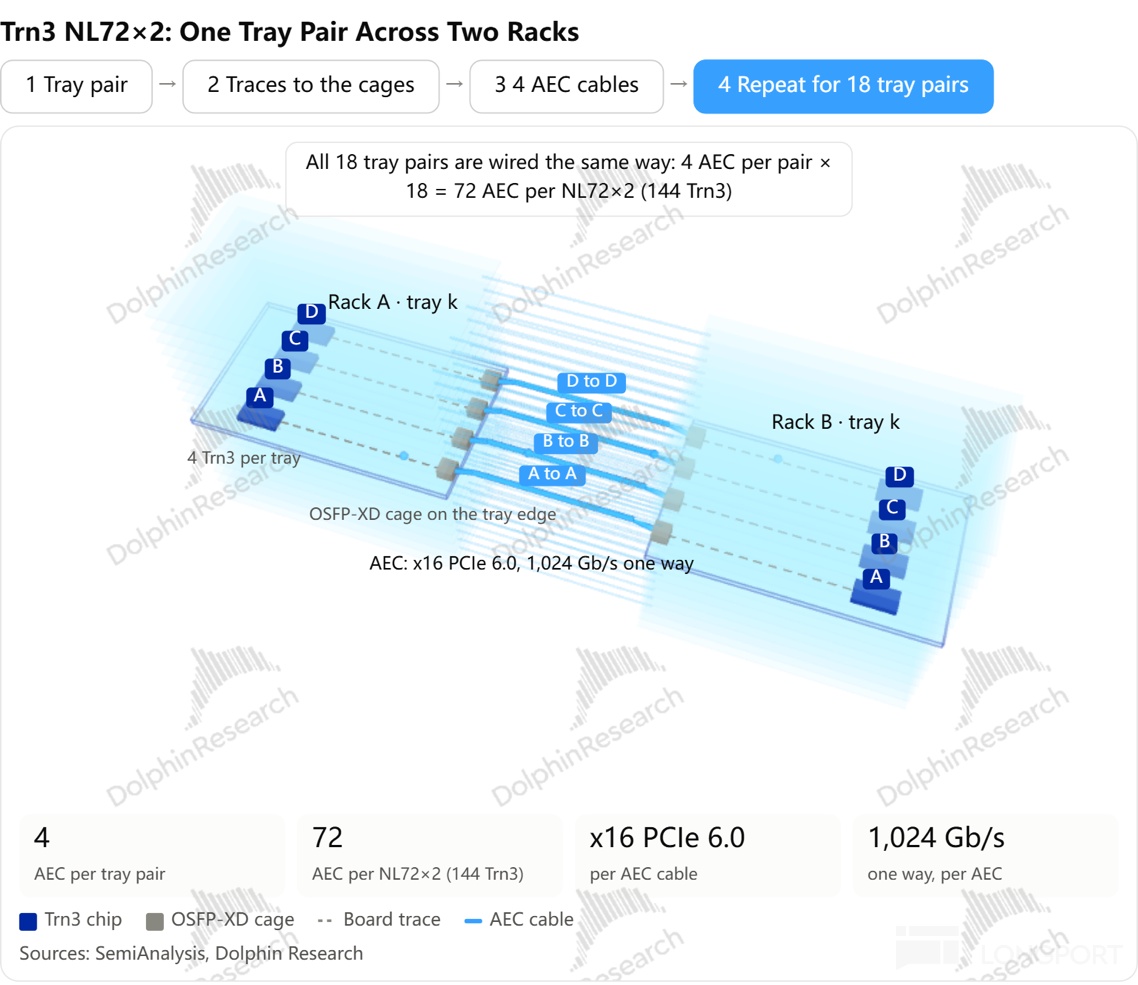
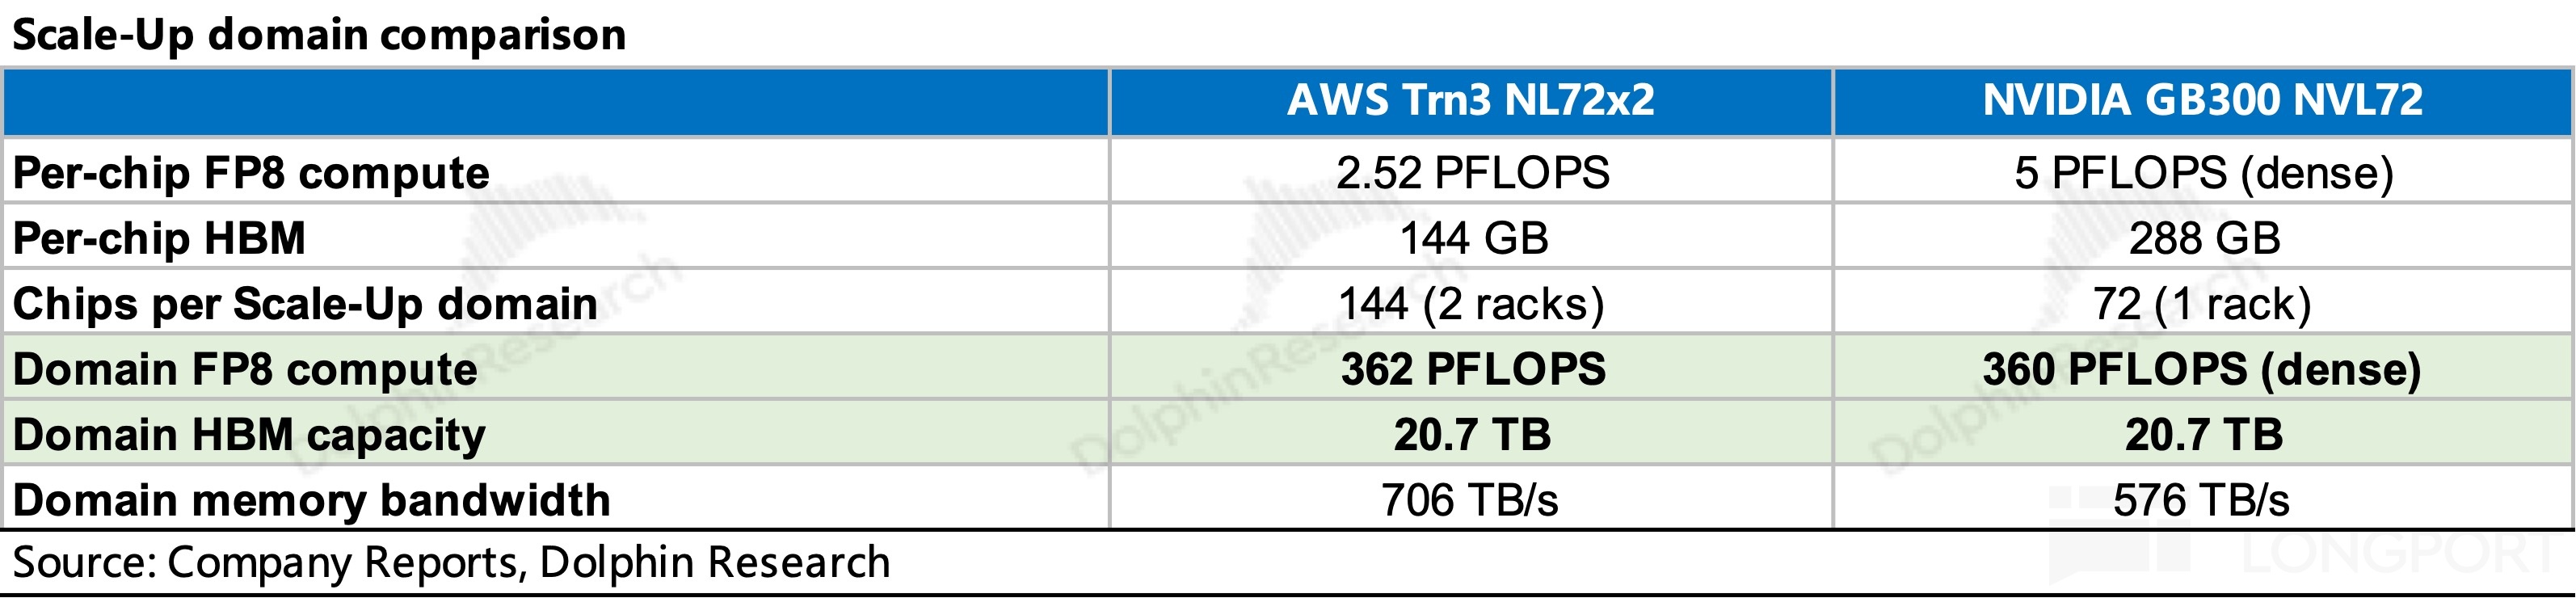
自然的疑问是,为什么是 144 卡?核心点在于弥补 Trn3 弱势的算力、带宽性能。如下表所示,Trn3 单卡 FP8 算力约为 GB300 的一半,两柜 144 颗 Trn3 在 FP8 算力与 HBM 容量上正好对标一柜 GB300 NVL72。
介绍完以上架构设计与整体性能上的类同,更关键的问题是,该如何理解 Trn3 的组网及其差异?
2、如何理解 Trn3 的组网及其差异?
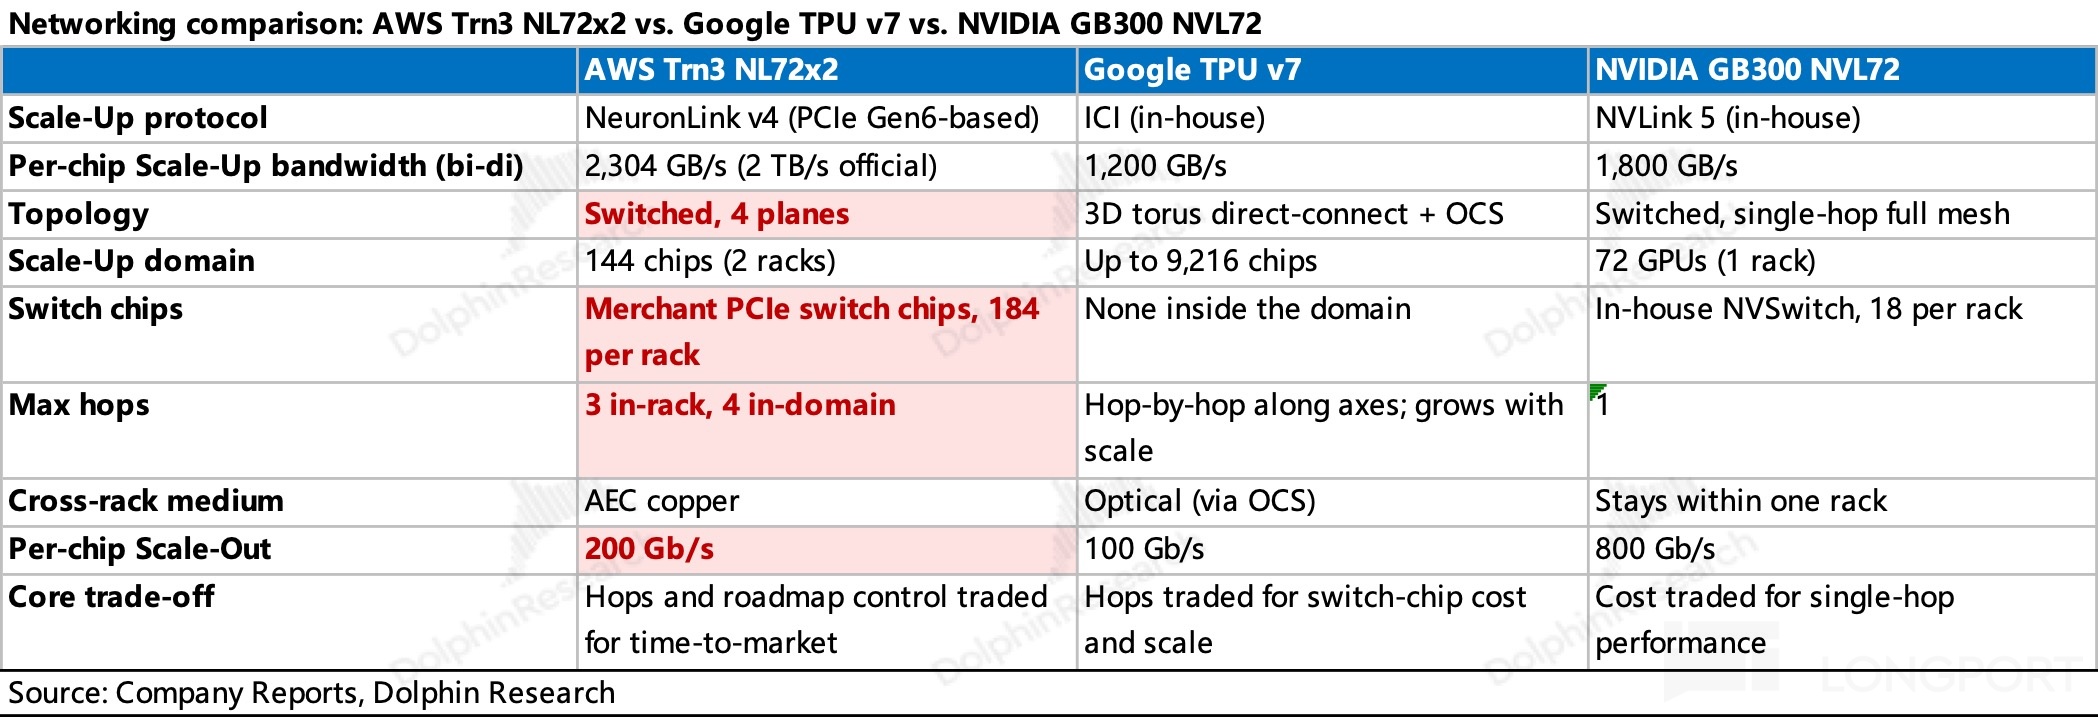
我们一直强调 Trn3 是交换式的组网,也就意味着可以参考英伟达的组网来理解。要点是,GB300 的 Scale-Up(含托盘内/跨托盘)是 72 卡全互连的,通过机柜内交换托盘中的 NV Switch 芯片进行转发。域内通信仅 1 跳,延迟极低。具体可参见先前的深度。
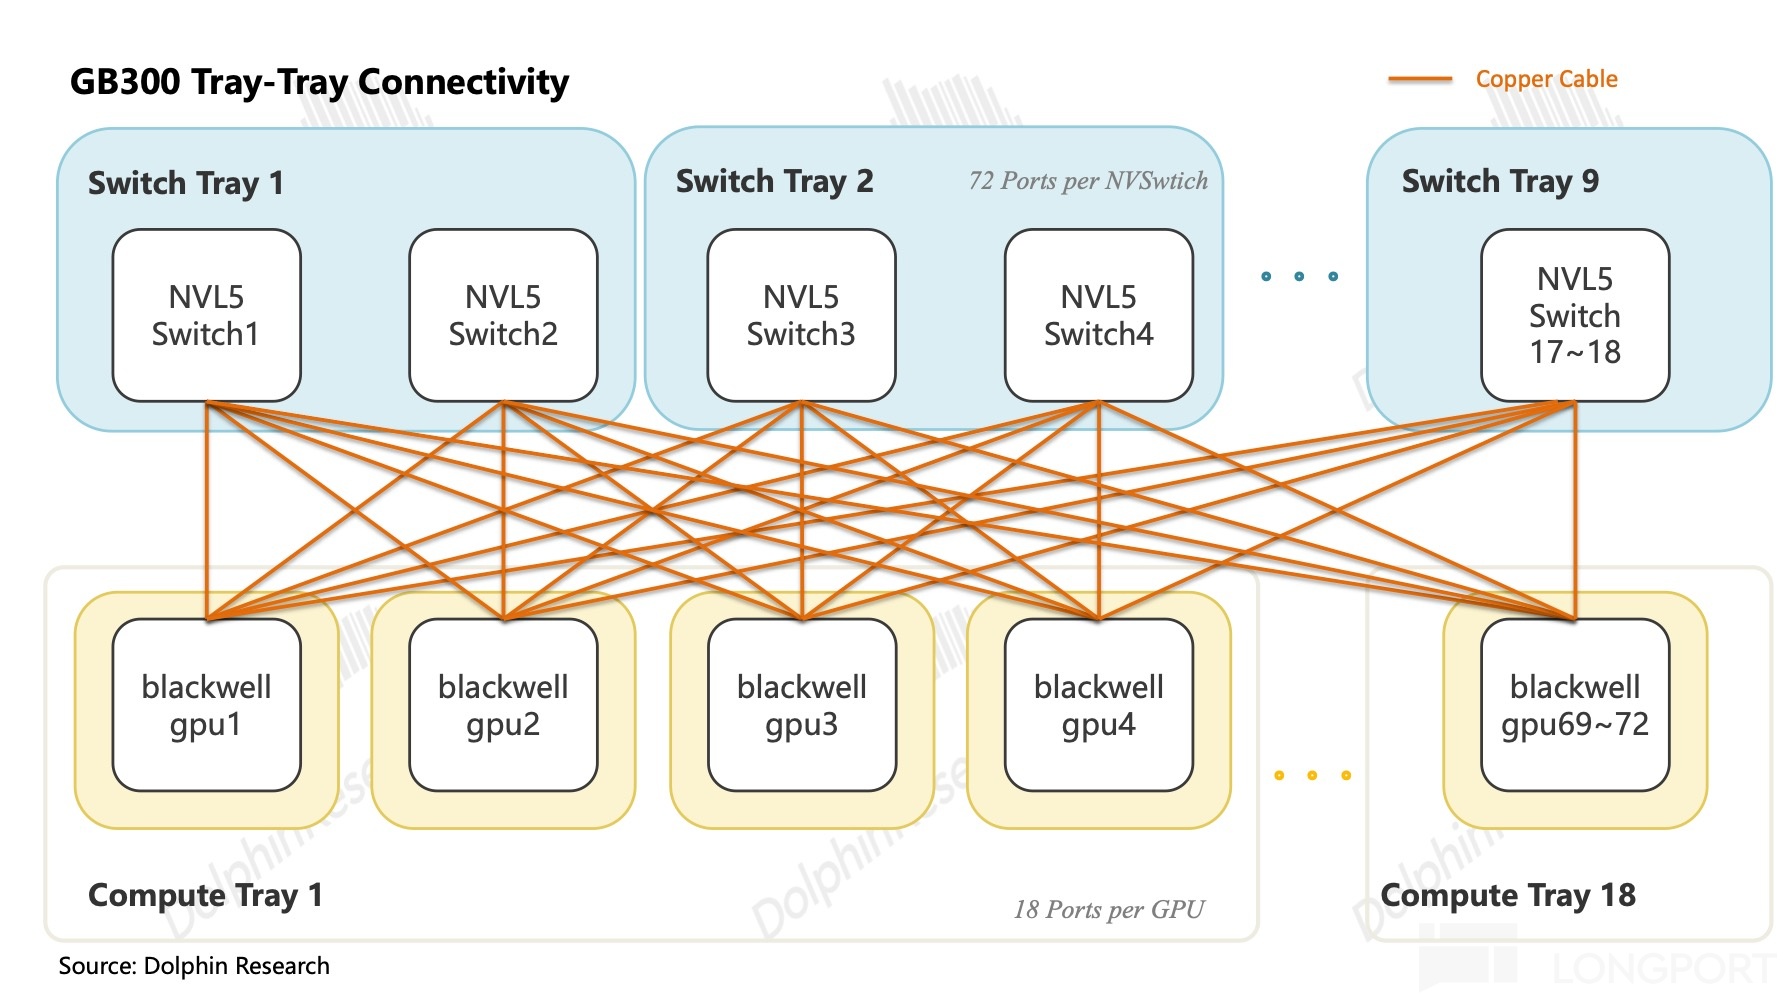
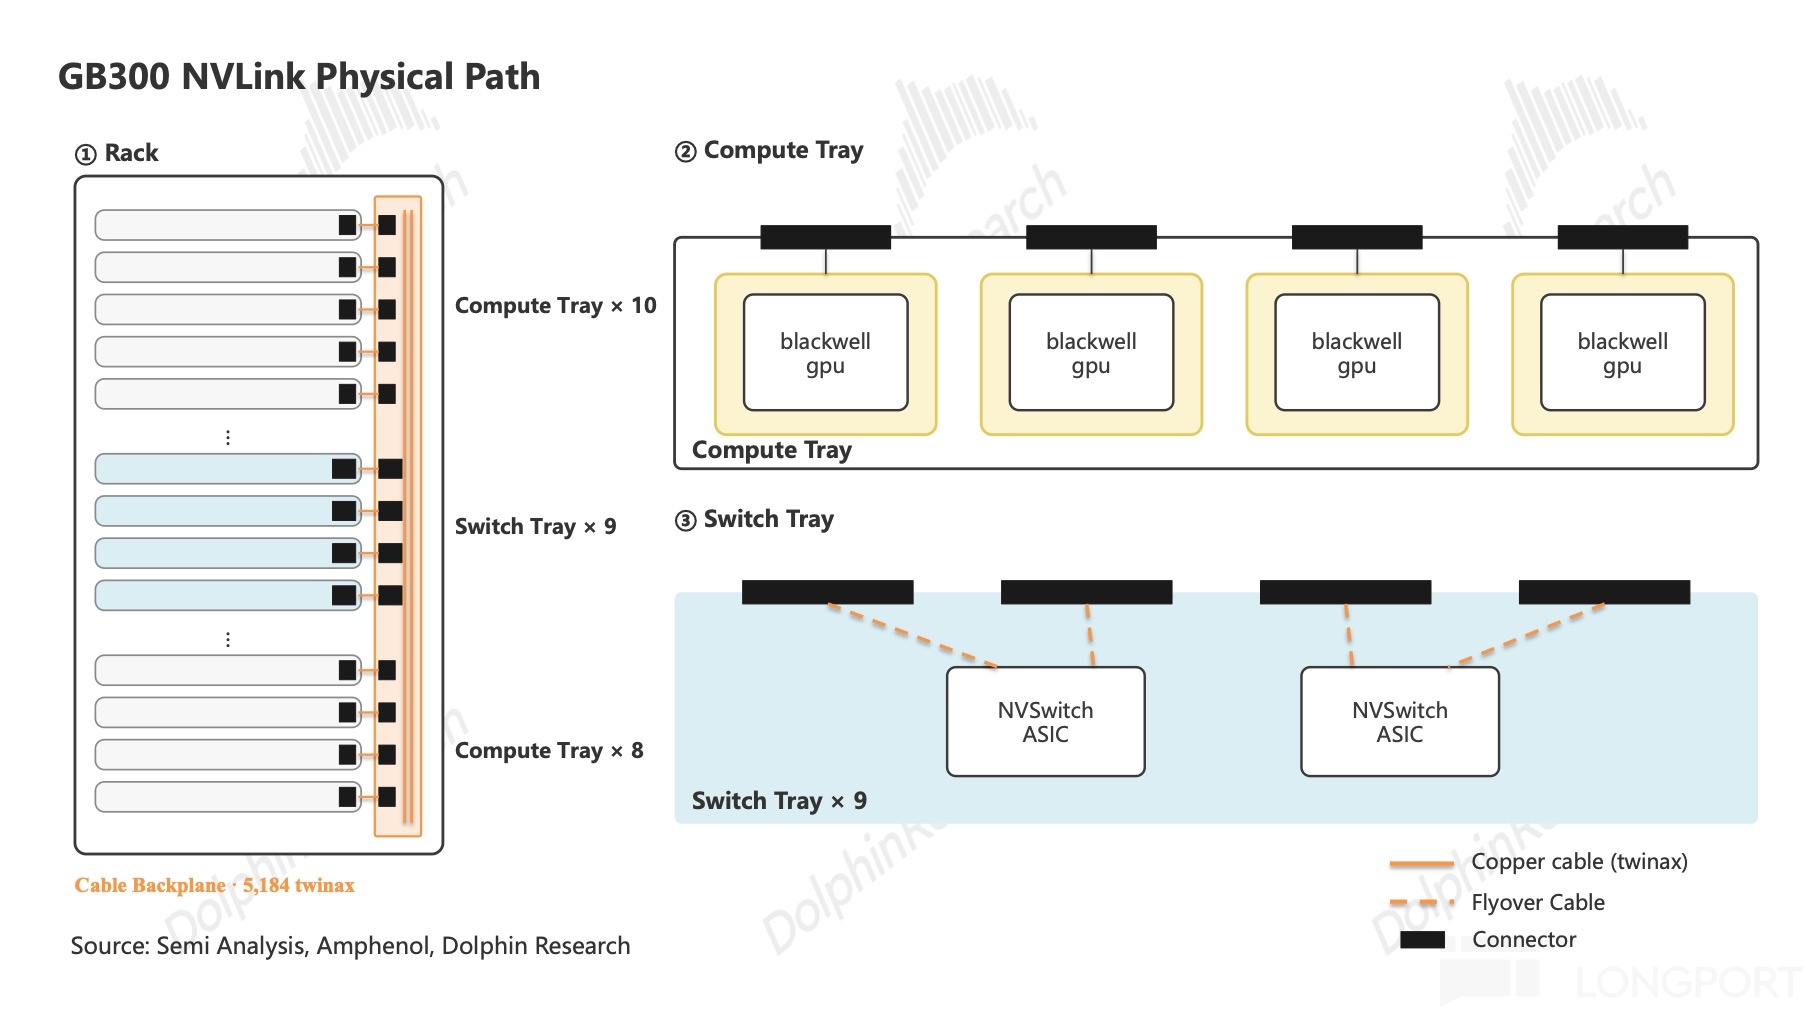
AWS Trn3 Scale-Up 域内的互连同样需要交换芯片的转发,但目前仍不是全互连的,需要多跳,方案整体的延迟是落后的。那么,
3、非全互连的交换式组网是如何实现的呢?
计算托盘内部元件如下,需要关注的是红框内 Scale-Up 相关元件,此前深度中已有涉及。其中最为核心的差异是,Trn3 计算托盘内有 8 颗 Scorpio-P 交换 ASIC(见下图 PCIe Switch),而 GB300 内没有,其交换芯片都外置在交换托盘内。
当然 Trn3 NL72x2 的机架内也有交换托盘,用的是 Scorpio-X 交换 ASIC。需要两款交换芯片的原因,将在下文组网部分一同展开。(注: Scorpio-P 和 Scorpio-X 均来自美股半导体公司 Astera Labs。)
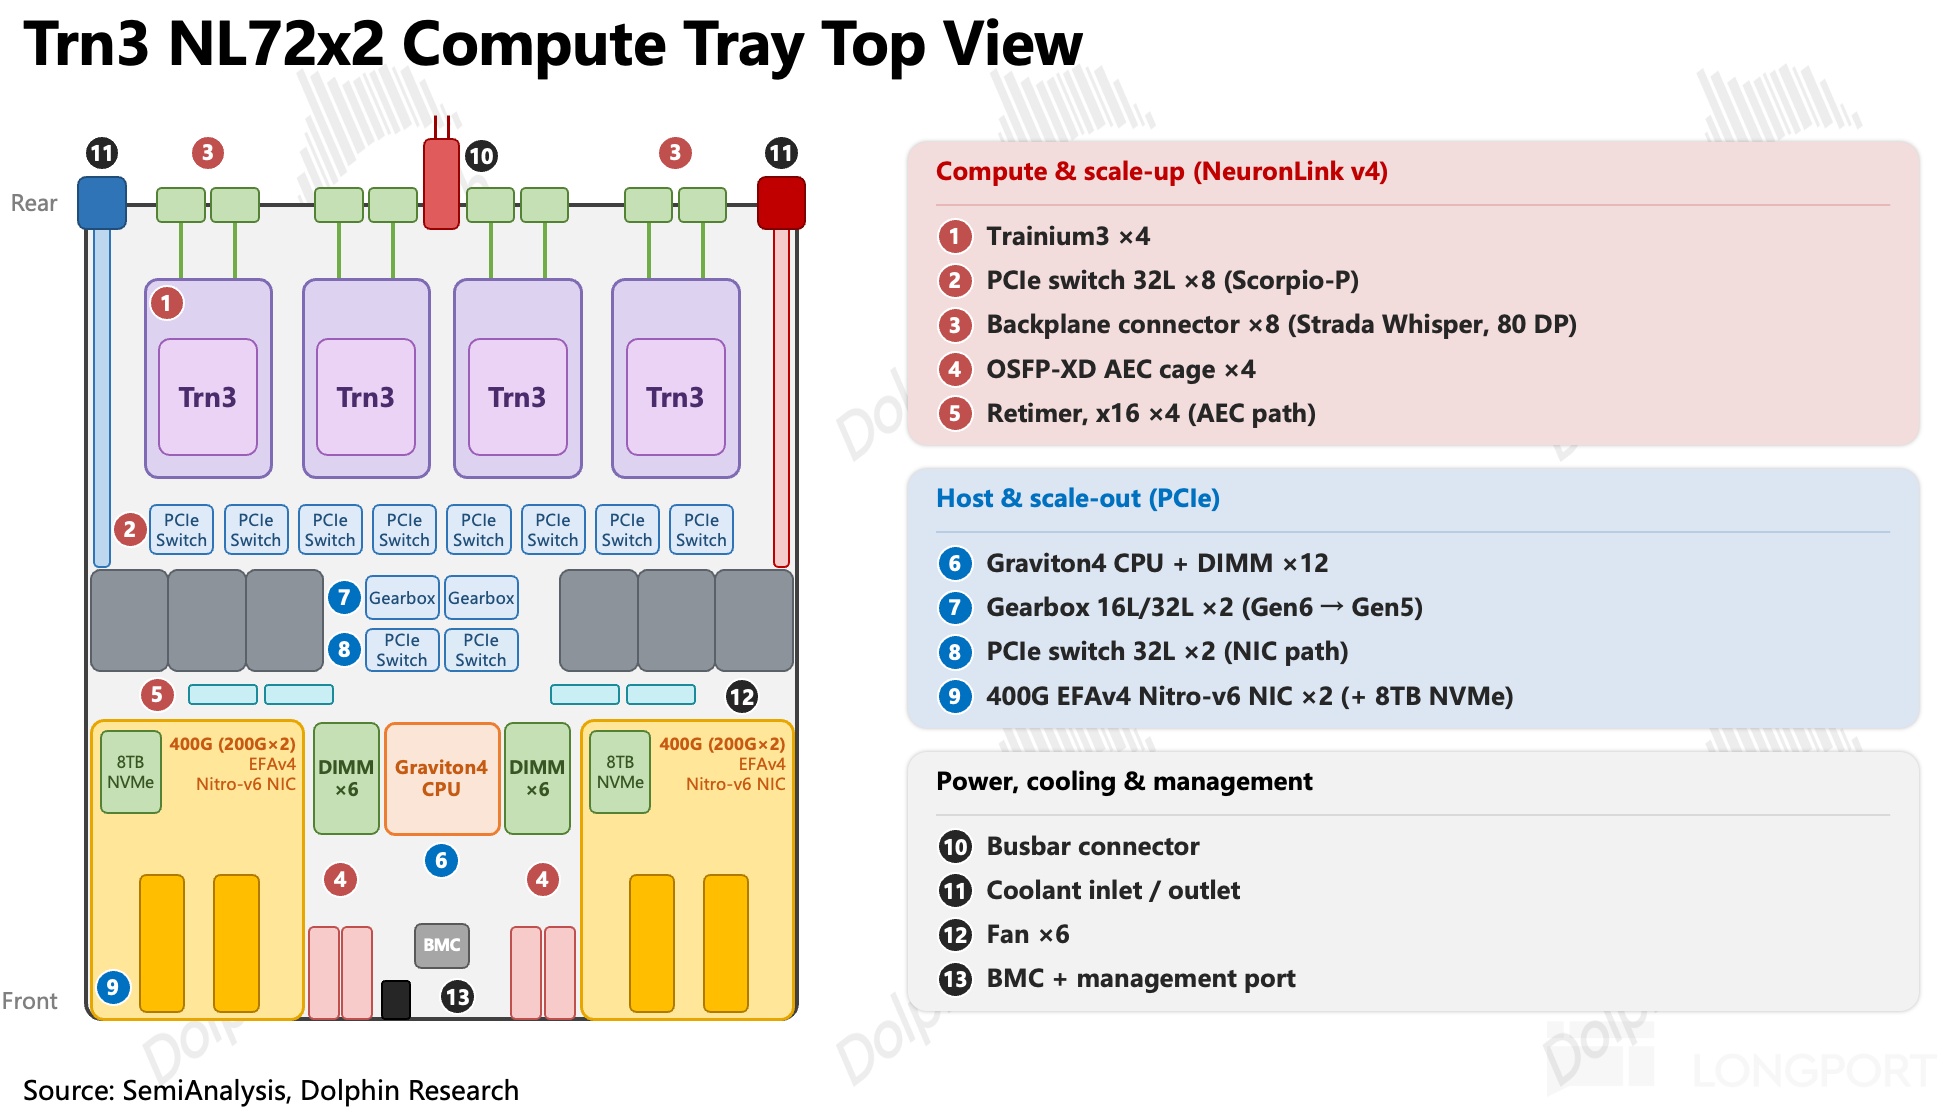
从数据流动的视角来看,GB300 的全互连的 Scale-Up 路径可简化成:起始 GPU → 背板铜缆 → NVSwitch ASIC → 背板铜缆 → 目标 GPU。能做到全互连,关键在于一颗 NVSwitch 有 72 个端口,接满域内全部 72 颗 GPU。
而 Trn3 的 Scorpio-X(交换托盘)只有 18 个可用端口,只对应 18 个计算托盘,而一颗交换芯片在每个托盘只能接 1 颗 Trn3。
但单托盘有 4 颗 Trn3,就得搭 4 个独立的 “垂直天梯”(如下图)。这样搭下来,同个天梯上的 18 颗计算芯实现一跳互联;但每托盘是四颗芯片,就组成了四条天梯。Scorpio-X 端口数太少,天梯之间无直联通道。
而天梯之间要互联,就要降到托盘内的8 颗 Scorpio-P(见前图),而之所以用 8 颗,是托盘间一条天梯内,每个计算芯连 10 颗交换芯,每交换芯配给计算芯 8 条通道,合计每计算芯 80 条通道。
而托盘内每颗交换芯只有 32 条通道,分给盘内 4 颗芯片,每颗只能分到 8 条。用 8 颗这样的 P 交换芯就能配 64 条通道。等于配上 8 颗 P 交换芯的组网,能保持 Tray 内的一跳,和同天梯内跨 Tray 一跳保持基本相同的通道速率。
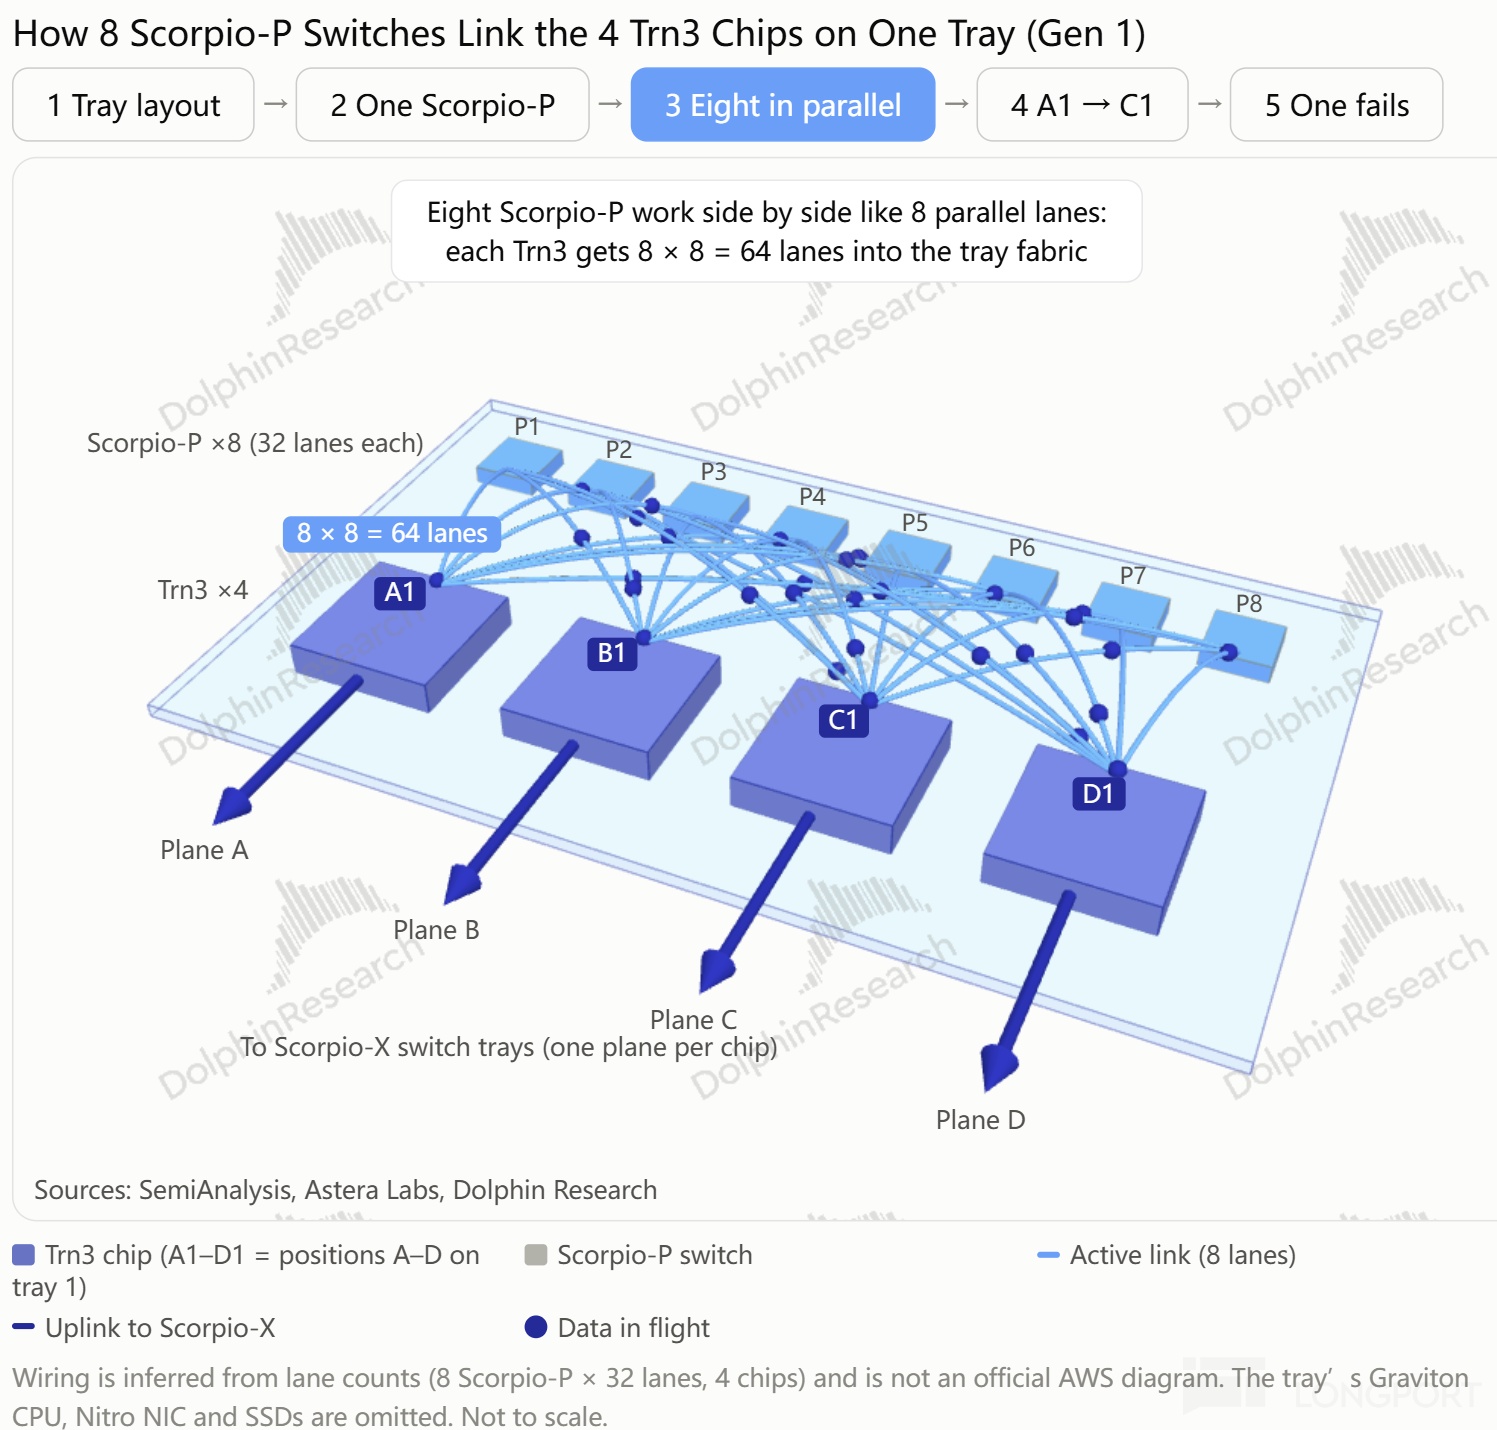
小结一下,Trn3 NL72x2 域是通过 AEC 跨柜构成的,其柜内类似 GB300 交换式的通信由于交换托盘内的交换 ASIC 端口数少,组网是多平面的,因此在计算托盘与交换托盘内都存在交换芯片,尚未实现全互连。
4、跨柜:交换芯 + 跨柜的拖累
海豚君在谷歌的深度中已经指出了多跳带来的延迟影响,其在 v8i(面向推理场景)的组网也优化了跳数。那么在 Trn3 NL72x2 域内,跳数(延迟)如何呢?
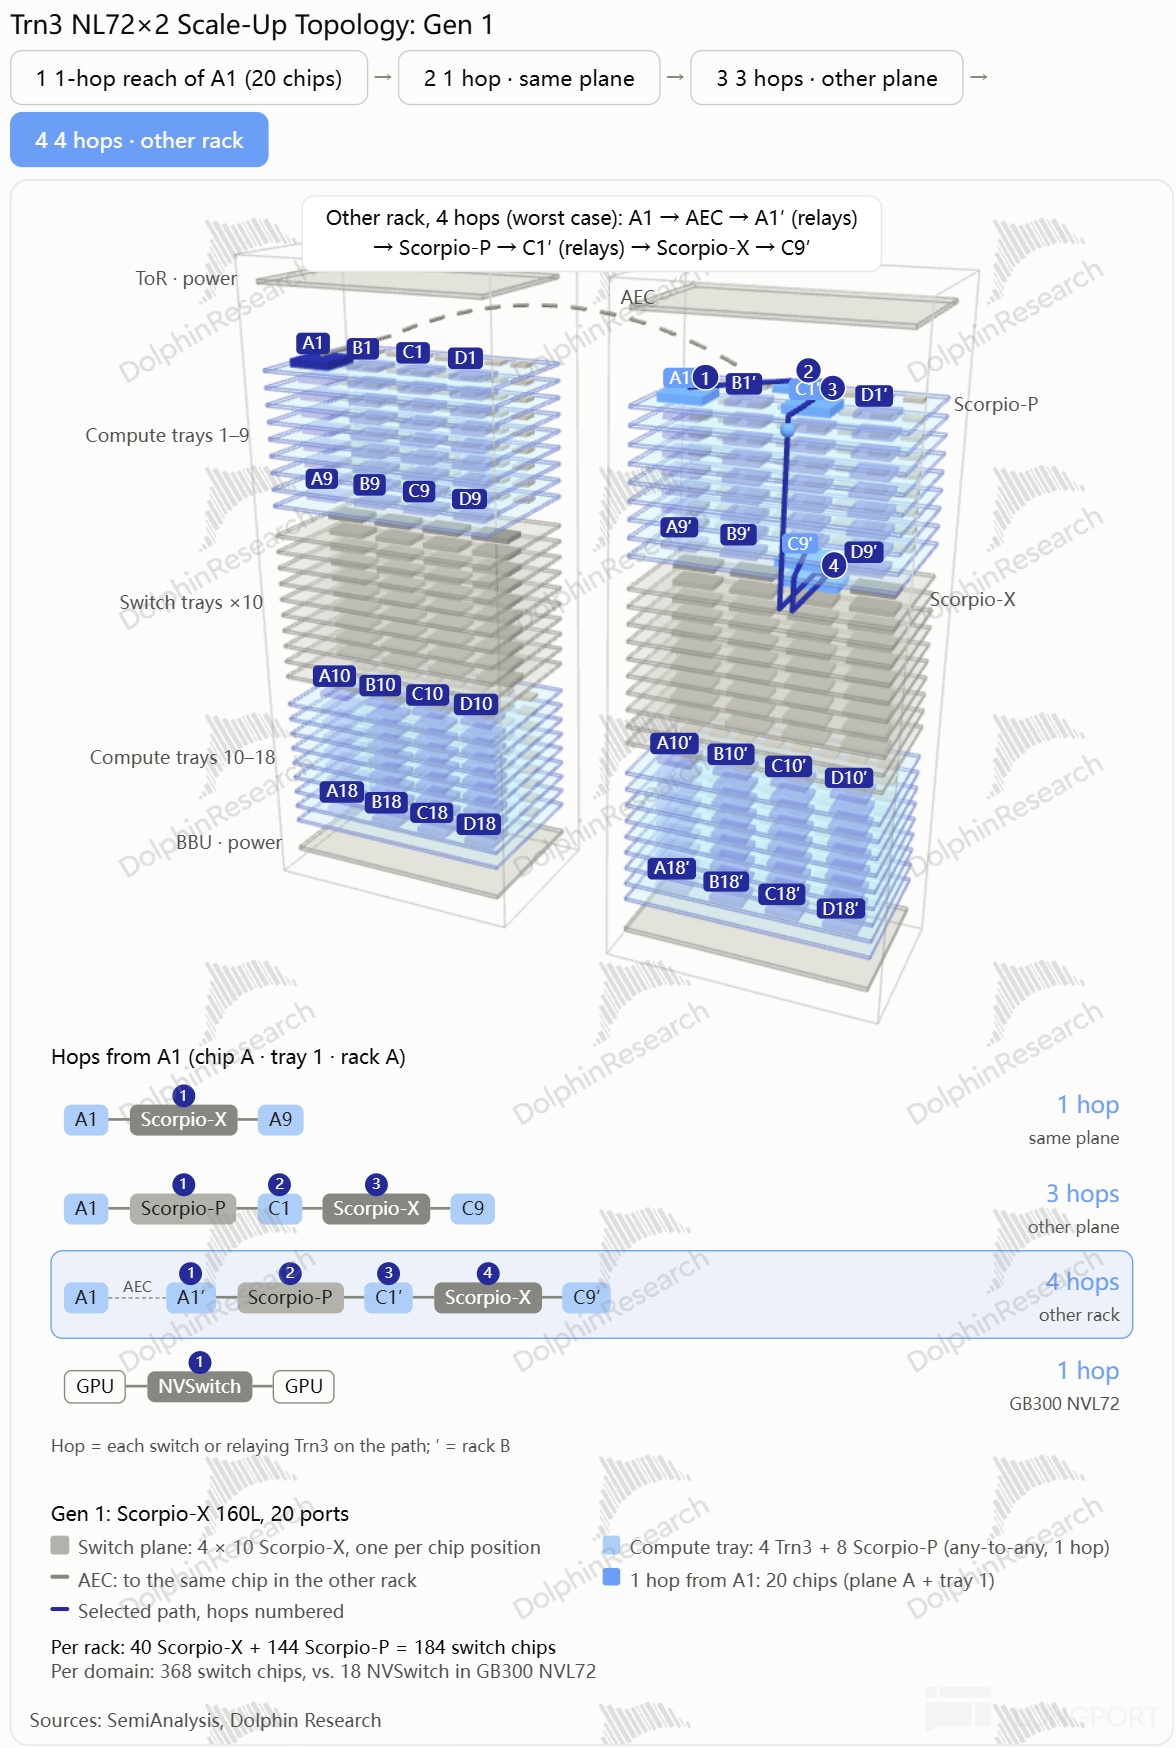
如图,以机柜 A 托盘 1 的芯片 A1,跨越机柜 B,到达 C9:到托盘 9 的 A9 同在一个平面,经 Scorpio-X 直达,1 跳;到 C9 要先经 Scorpio-P 借道另一颗芯片换到 C 所在平面,3 跳;到机柜 B 的 C9′还要再多一次跨柜中转,4 跳。
5、如何补课?等标品的端口数长上来
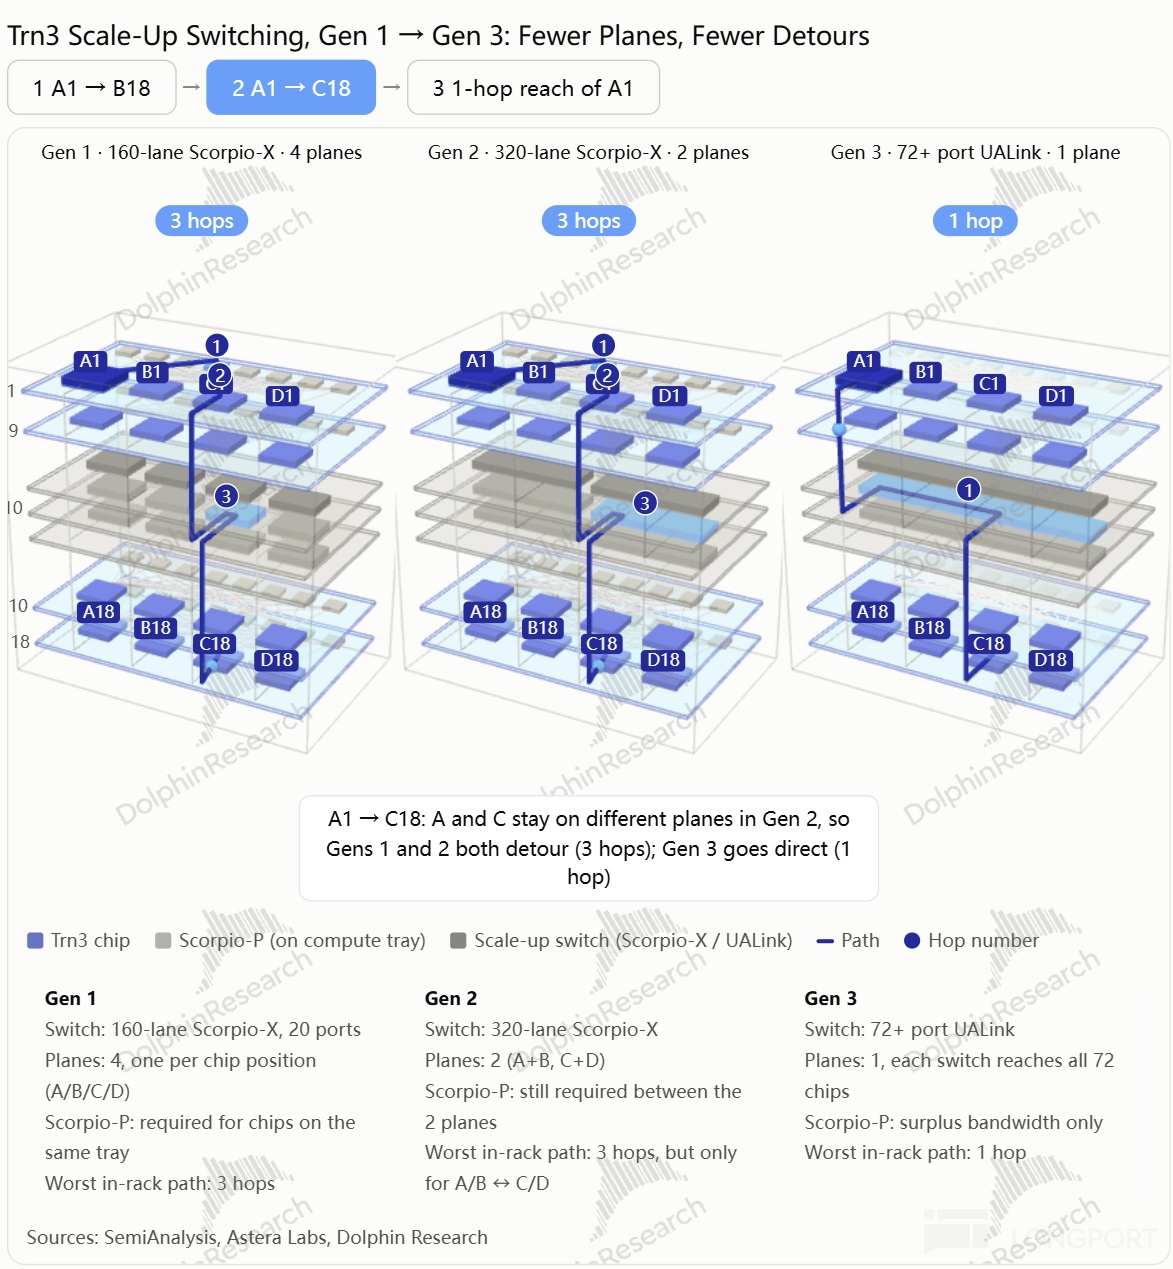
交换侧的多跳、多平面,都由于交换芯片的端口数过少。AWS 的解法是 Trn3 生命周期内需迭代三代,但只替换交换托盘里的交换 ASIC(Scorpio-X),直到采用第三代 UALink 才降到柜内 1 跳。
a. 一代,160 通道 Scorpio-X PCIe 6.0:每柜 4 平面,柜内最长路径 3 跳、跨柜 4 跳;
b. 二代,320 通道 Scorpio-X PCIe 6.0:端口翻倍,平面由 4 个减为 2 个,托盘内相邻芯片仍经 Scorpio-P 互连;
c. 三代,72+ 端口 UALink 交换机:每颗交换机可接柜内每一颗 Trn3,柜内变全互连,实现 1 跳,但跨柜仍需两跳。跳数减少将拉低整体延迟。而计算托盘内的交换芯片不再是必经的中转,但仍然在成本侧。
二、小结:跑得快,但跑得远吗?
结合上篇来看,AWS 的组网并不依靠自研求差异化和高性能,而是捡市面上立即可用的标准件,低成本组网,其实就是图省事的火速投用。
Scale-Up 层:
- 协议层面,基于 PCIe 的 NeuronLink 是图省事的做法,中长期看是会被取代的。
- 组网上,由于 3D torus 的大规模组网对厂商软件以及网络基础设施的要求较高,AWS 被迫转向交换式连接。
但作为核心硬件的交换芯片采用的是标品,端口少,即便采取了交换式拓扑仍然需要多跳,跳数改善要等高端口数的交换机出货。
Scale-Out 层:每卡 Scale-Out 带宽仅 200Gb/s,近两代无提升;交换芯片同样外采。
换言之,AWS 的组网缺乏自主权,其端口数、跳数、升级节奏都取决于供应商。因此,单论组网,AWS 既没有英伟达的性能,也没有谷歌的规模,竞争力并不强。
中长期看,Trn3 仍在等着 UALink 交换机的出货,那么 Trn4 的组网相较于其它厂商的组网方案差距可能会进一步拉大。
三、AWS 链的机会在哪里?
如上所述,AWS 不是奔着打赢英伟达、AMD、谷歌去的。接下来我们来探究下其产业链的机会在何处。
1、组网真的便宜吗?
AWS 组网硬件多为采买标品,或许不必为定制化支付溢价。
NL72x2 的单域(即双机架)组网成本测算如下:
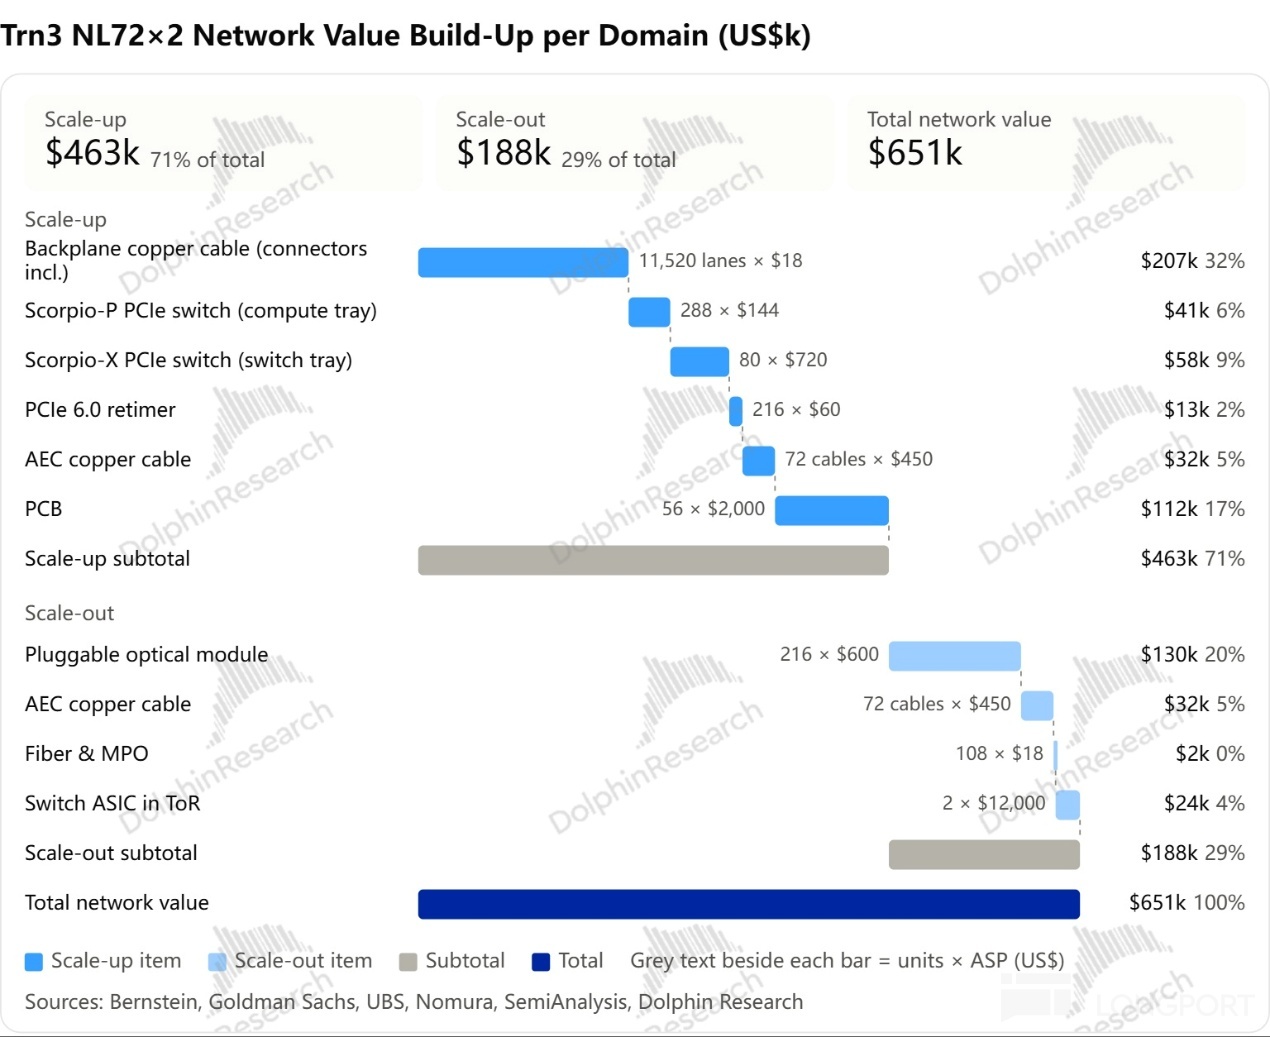
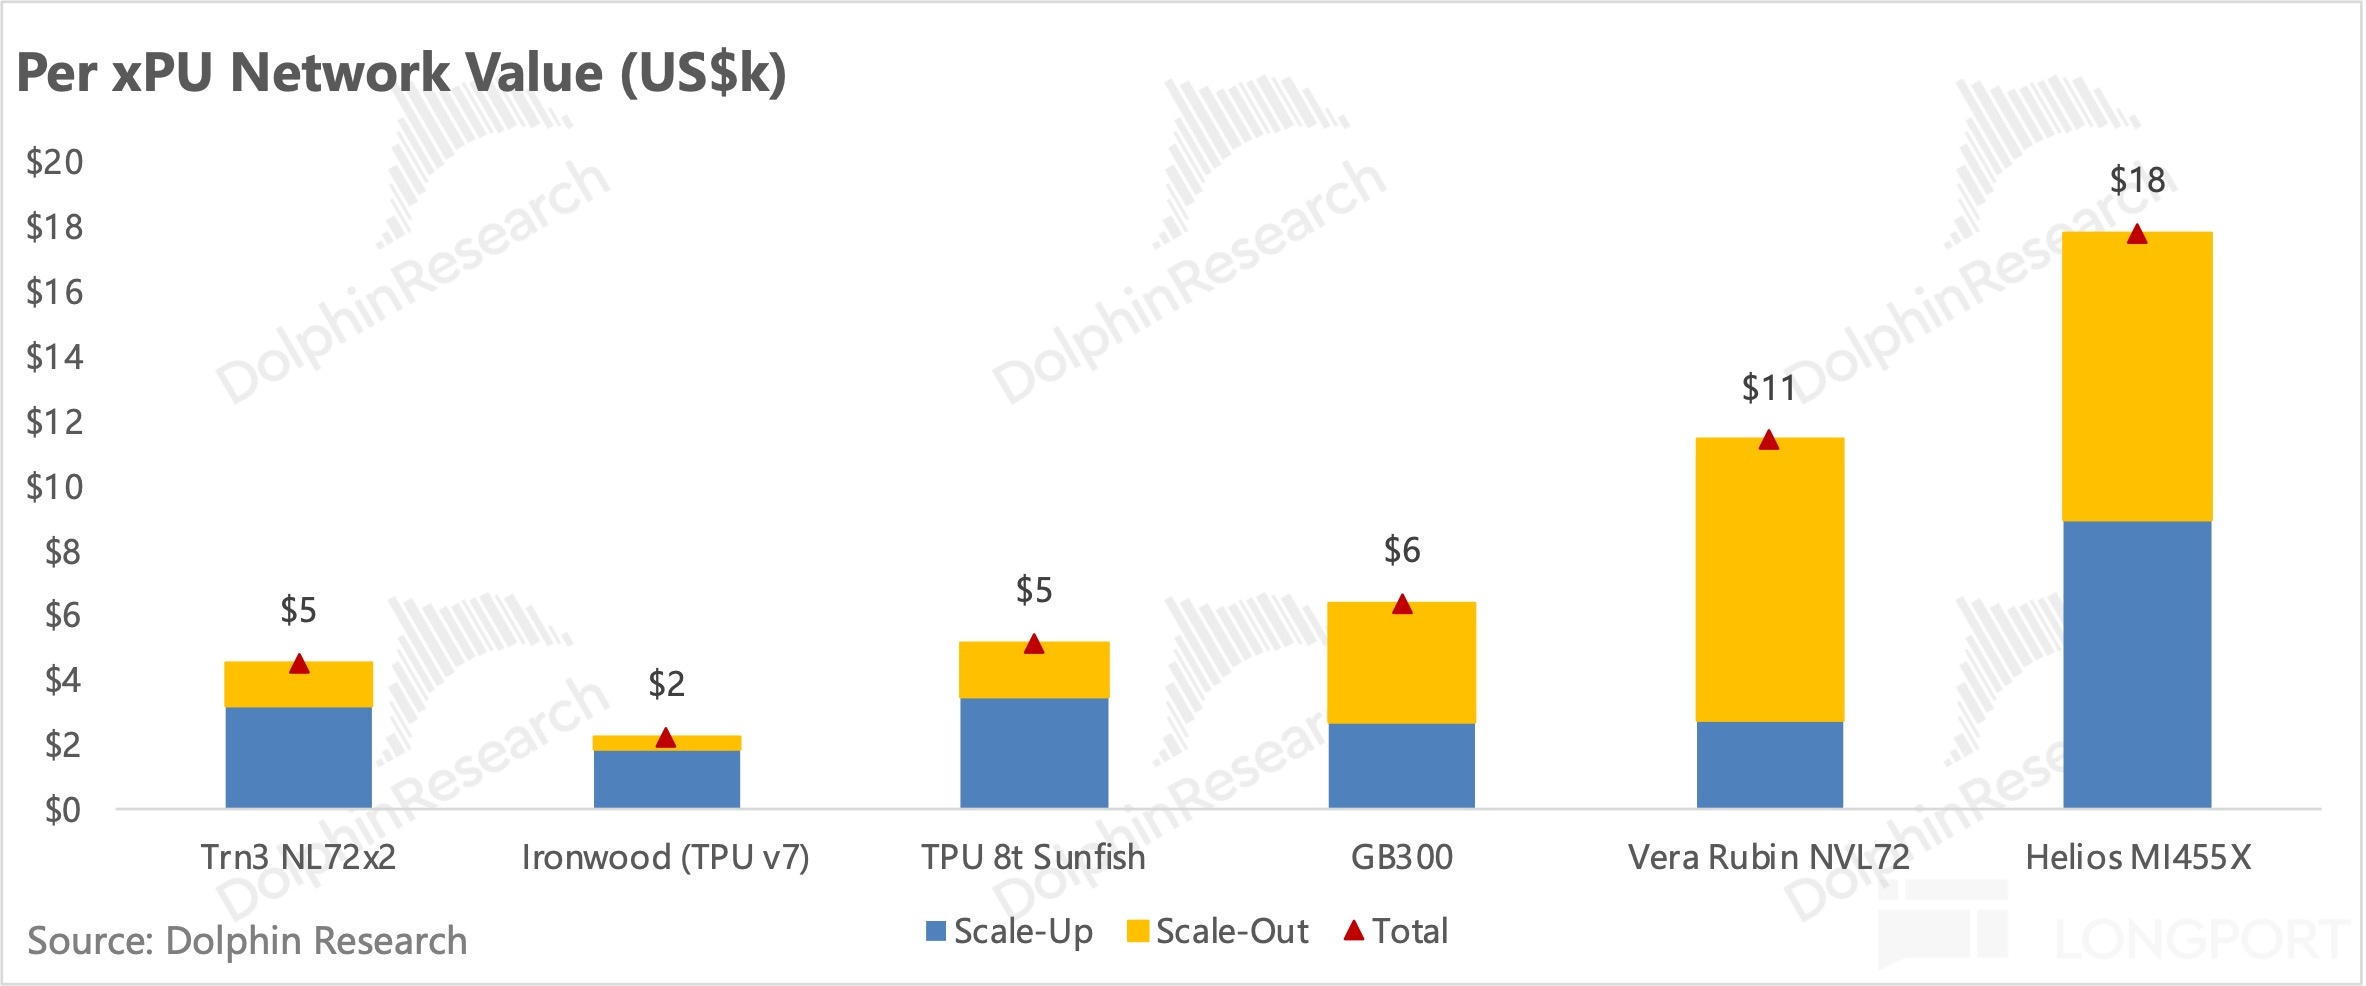
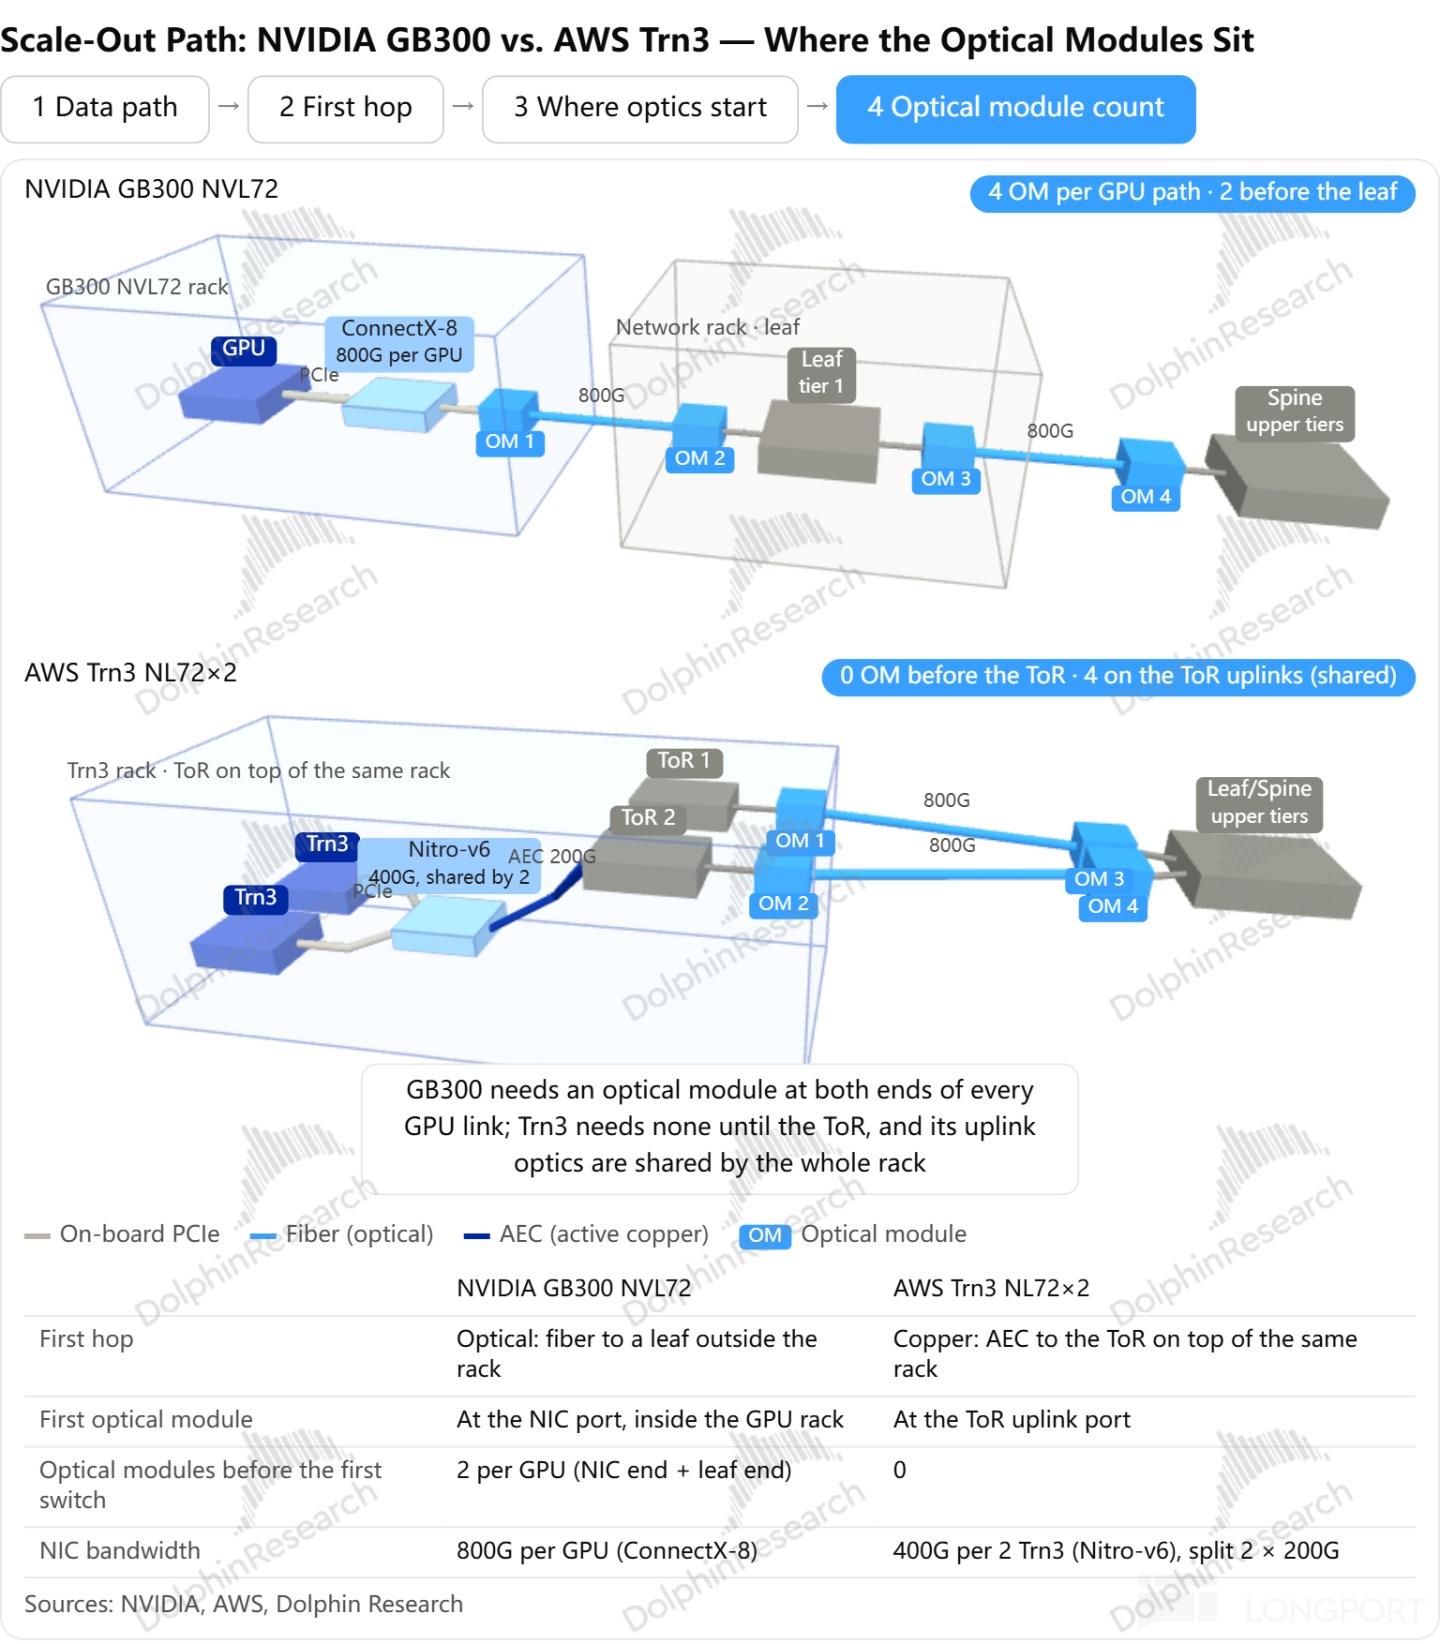
初看单卡组网成本,AWS 的策略是成功的,机柜形态基本对标 GB300,单卡组网成本却更低。省下的钱主要来自 Scale-Out 侧光模块的节省:主要是省去了网卡与 ToR 层的光模块。Trn3 的 Scale-Out 流量先经 AEC 铜缆接到柜顶部的两台 ToR 交换机,因此光模块只出现在 ToR 层及以上的链路。
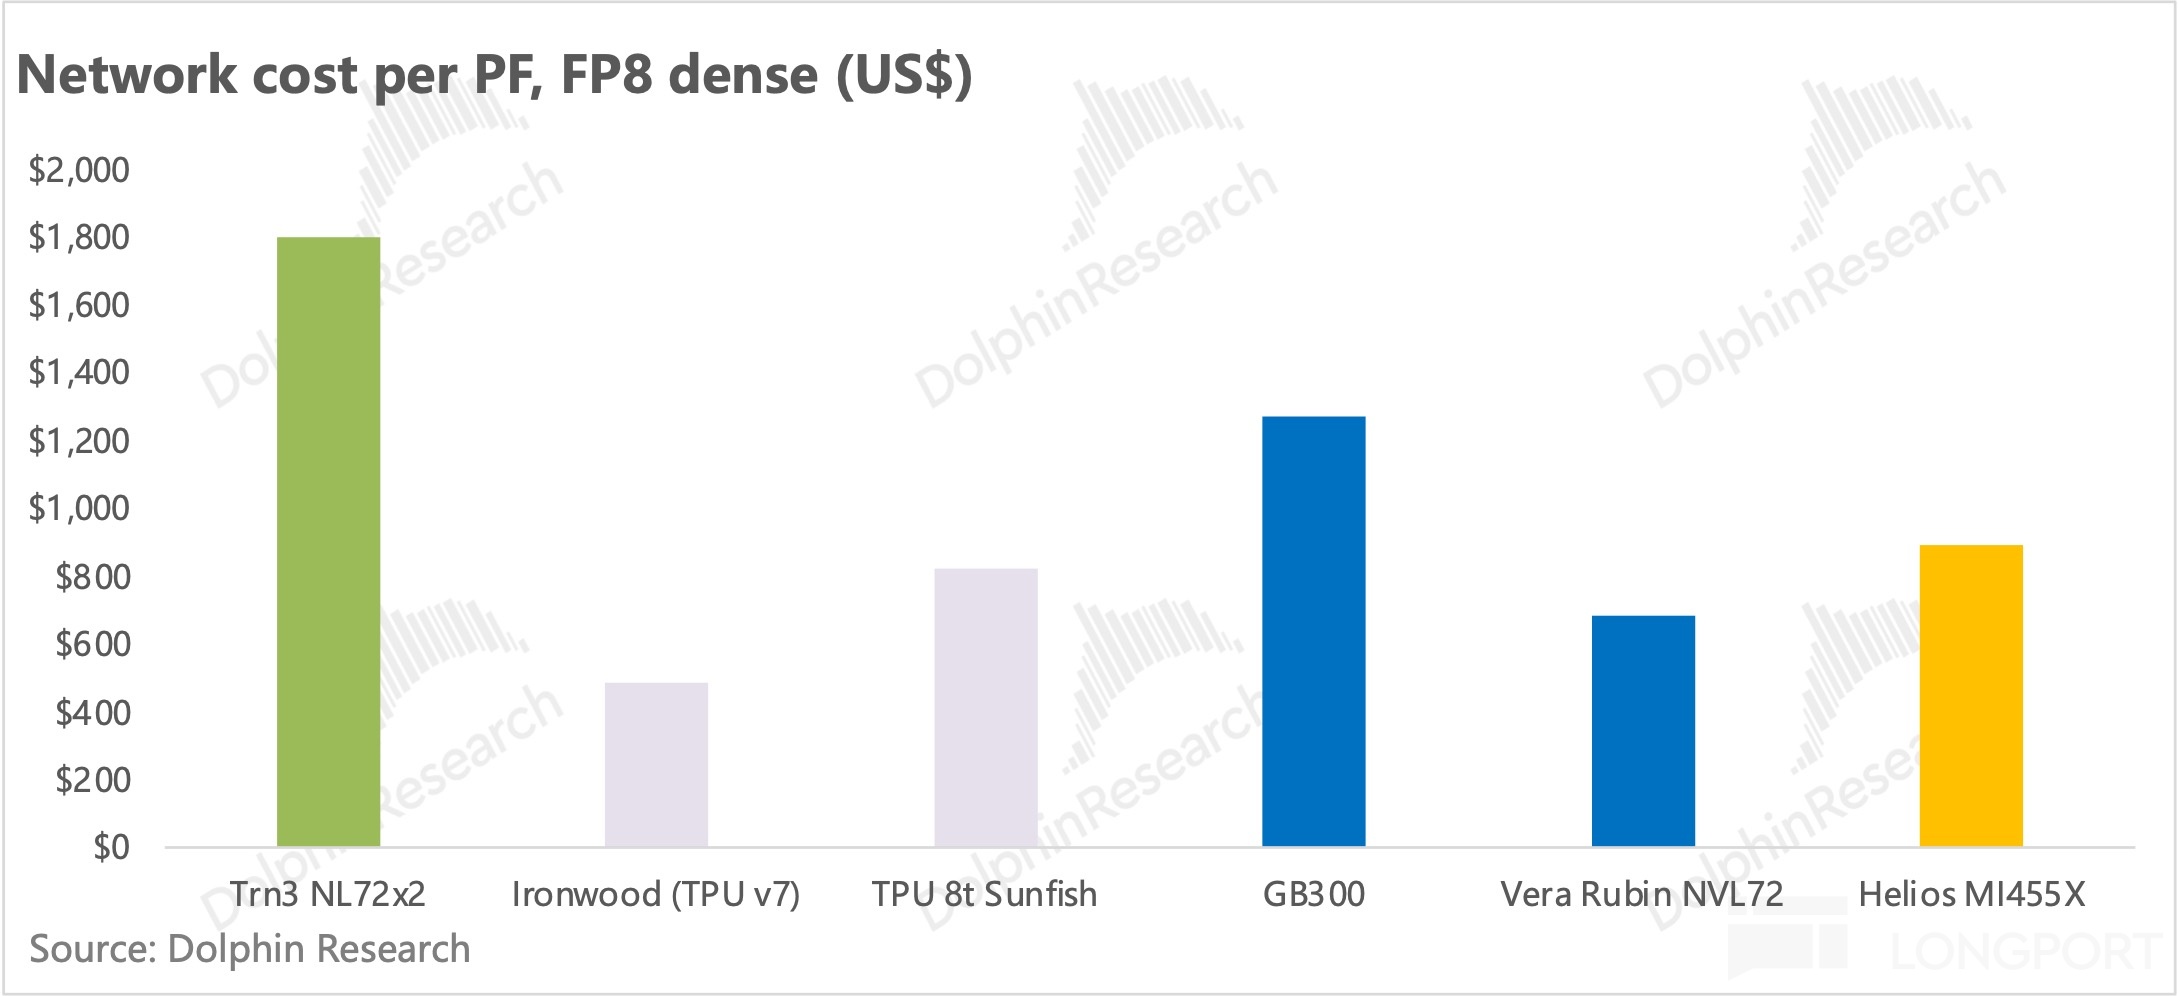
若折算到同等算力,结论与上文一致,Trn3 的组网性价比不高,竞争力并不强。
2、如何看待产业链机会?
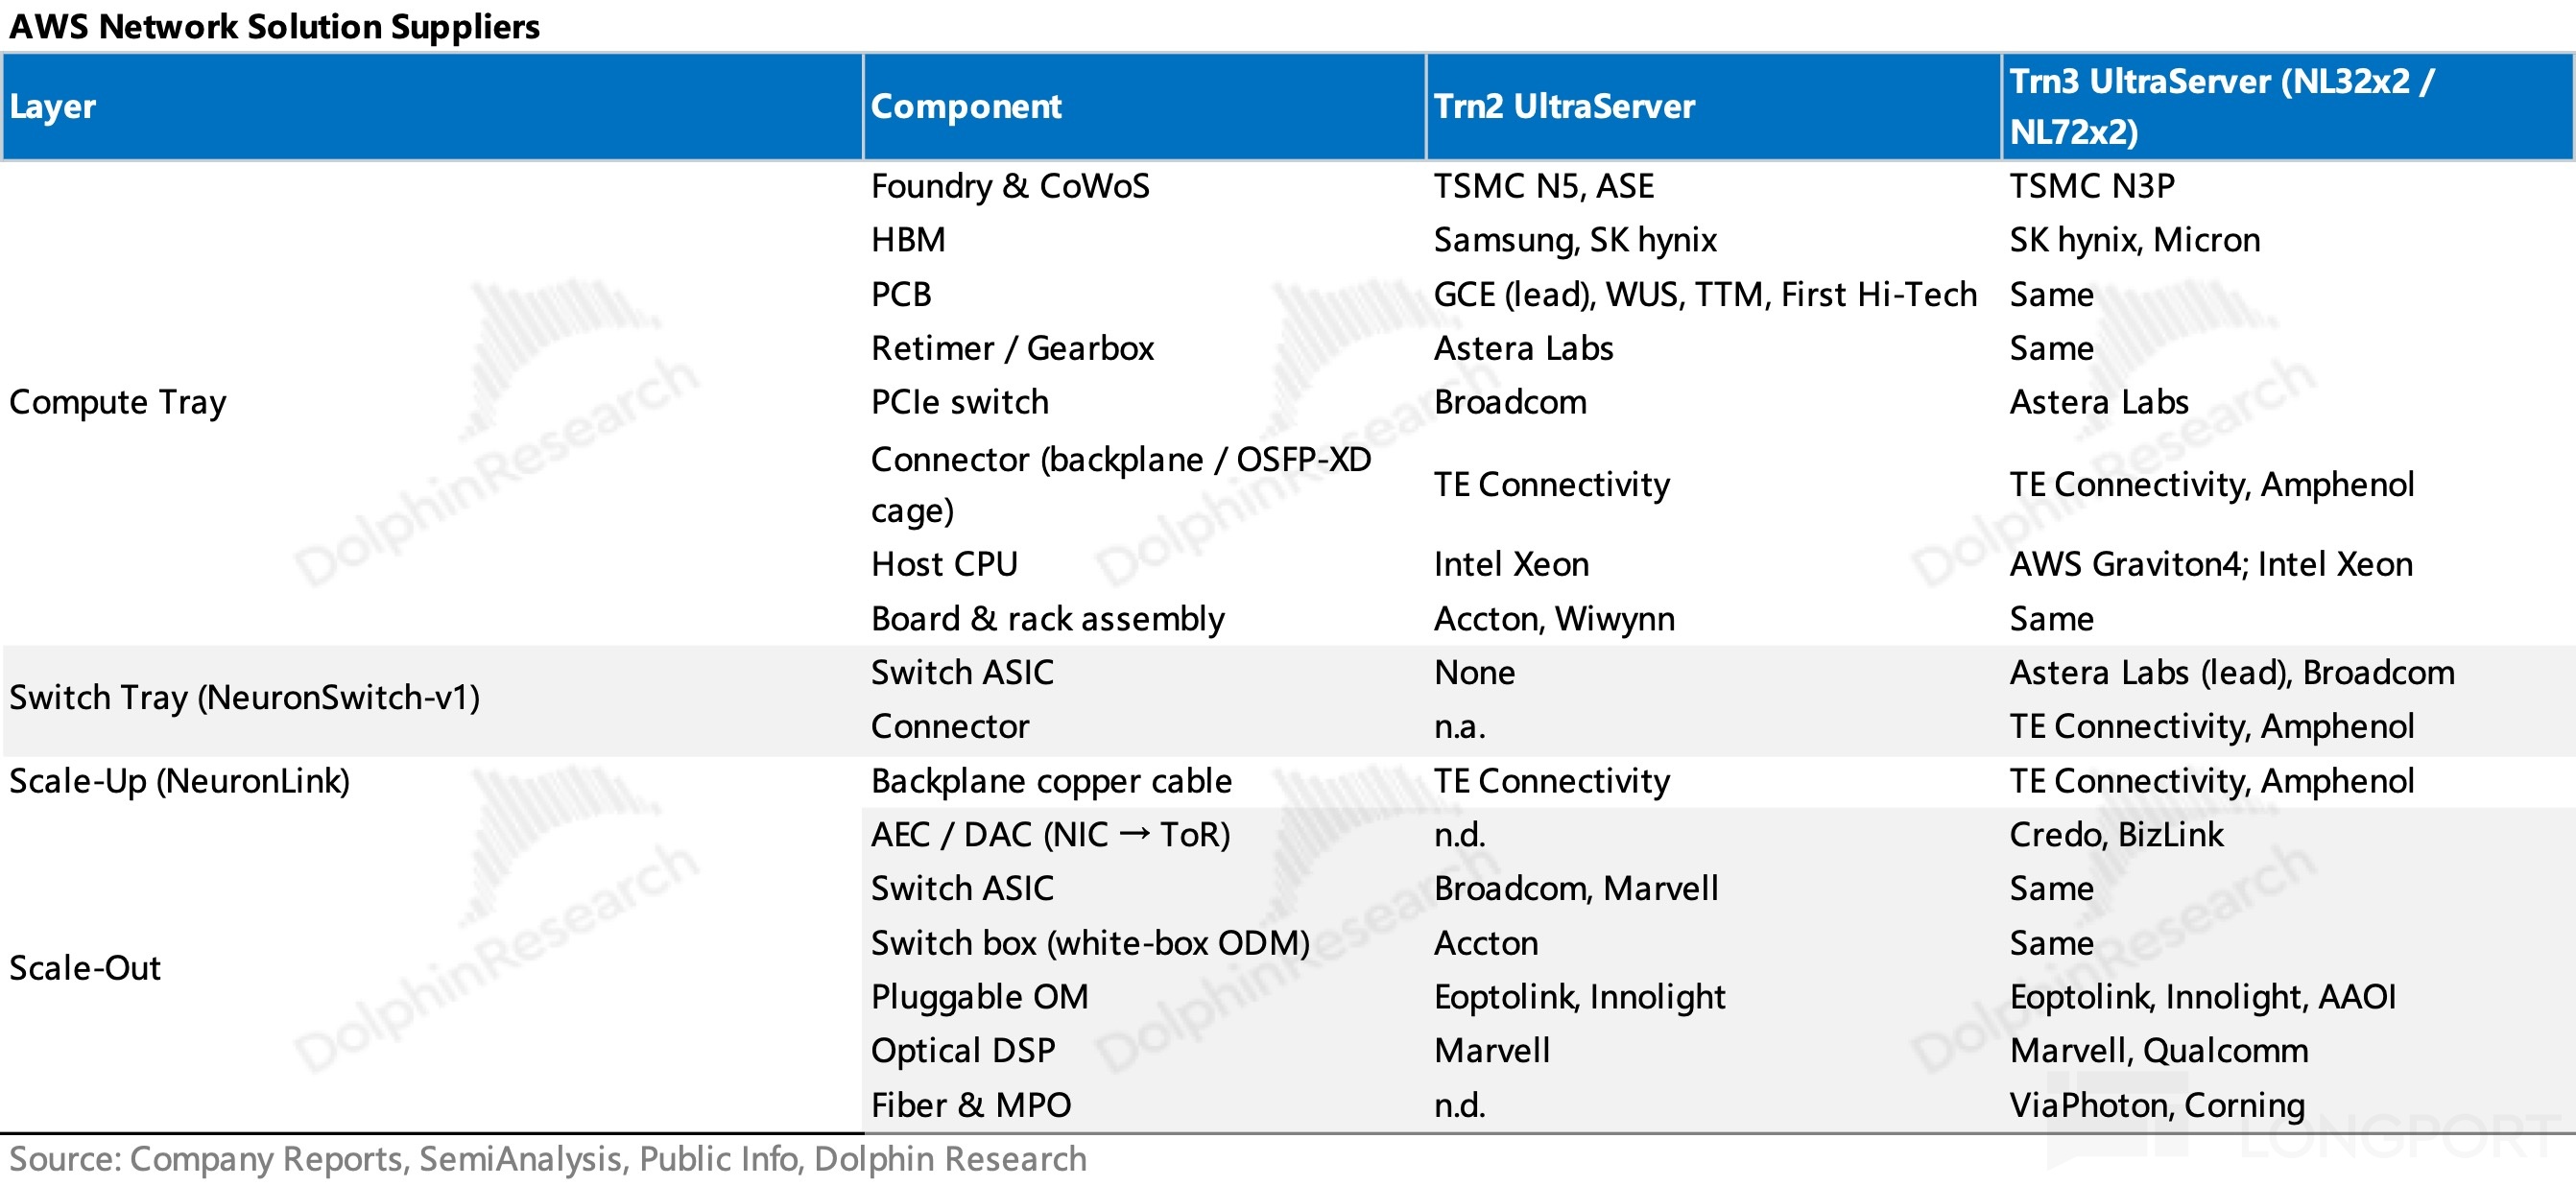
AWS 对标品的采买,除了压低组网成本,也意味着供应链高度多元,因此,链条上价值量以及确定性就极其关键。
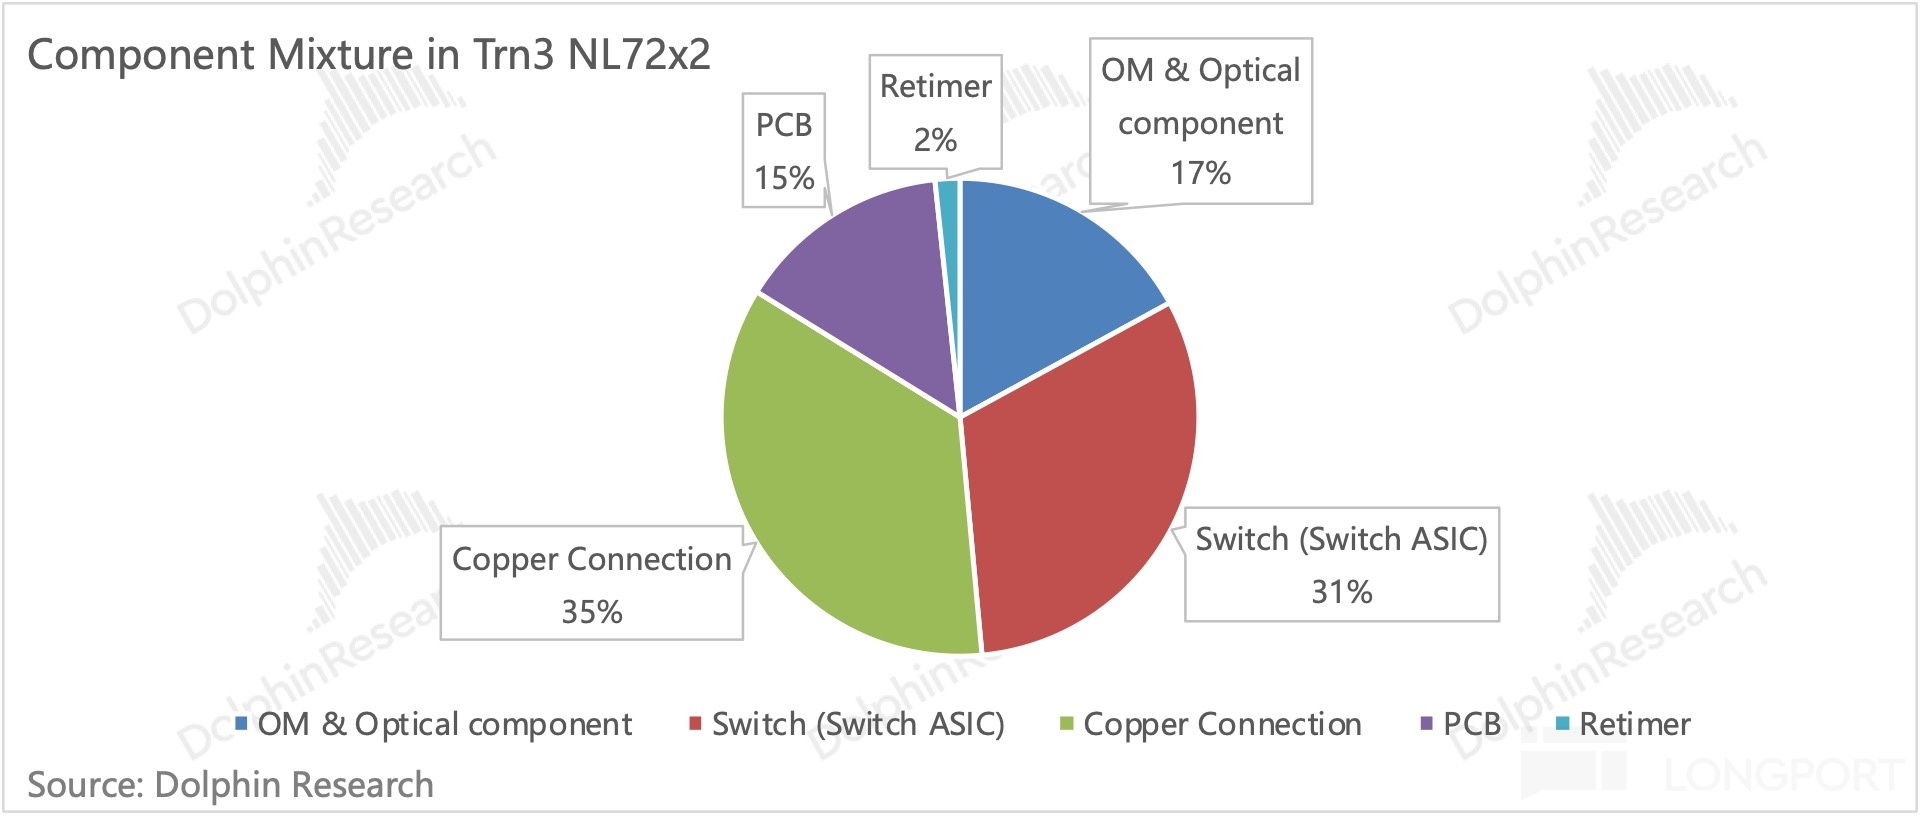
单机柜的价值量上,铜连接最大,其后依次为交换、光连接、PCB、PCIe Retimer。
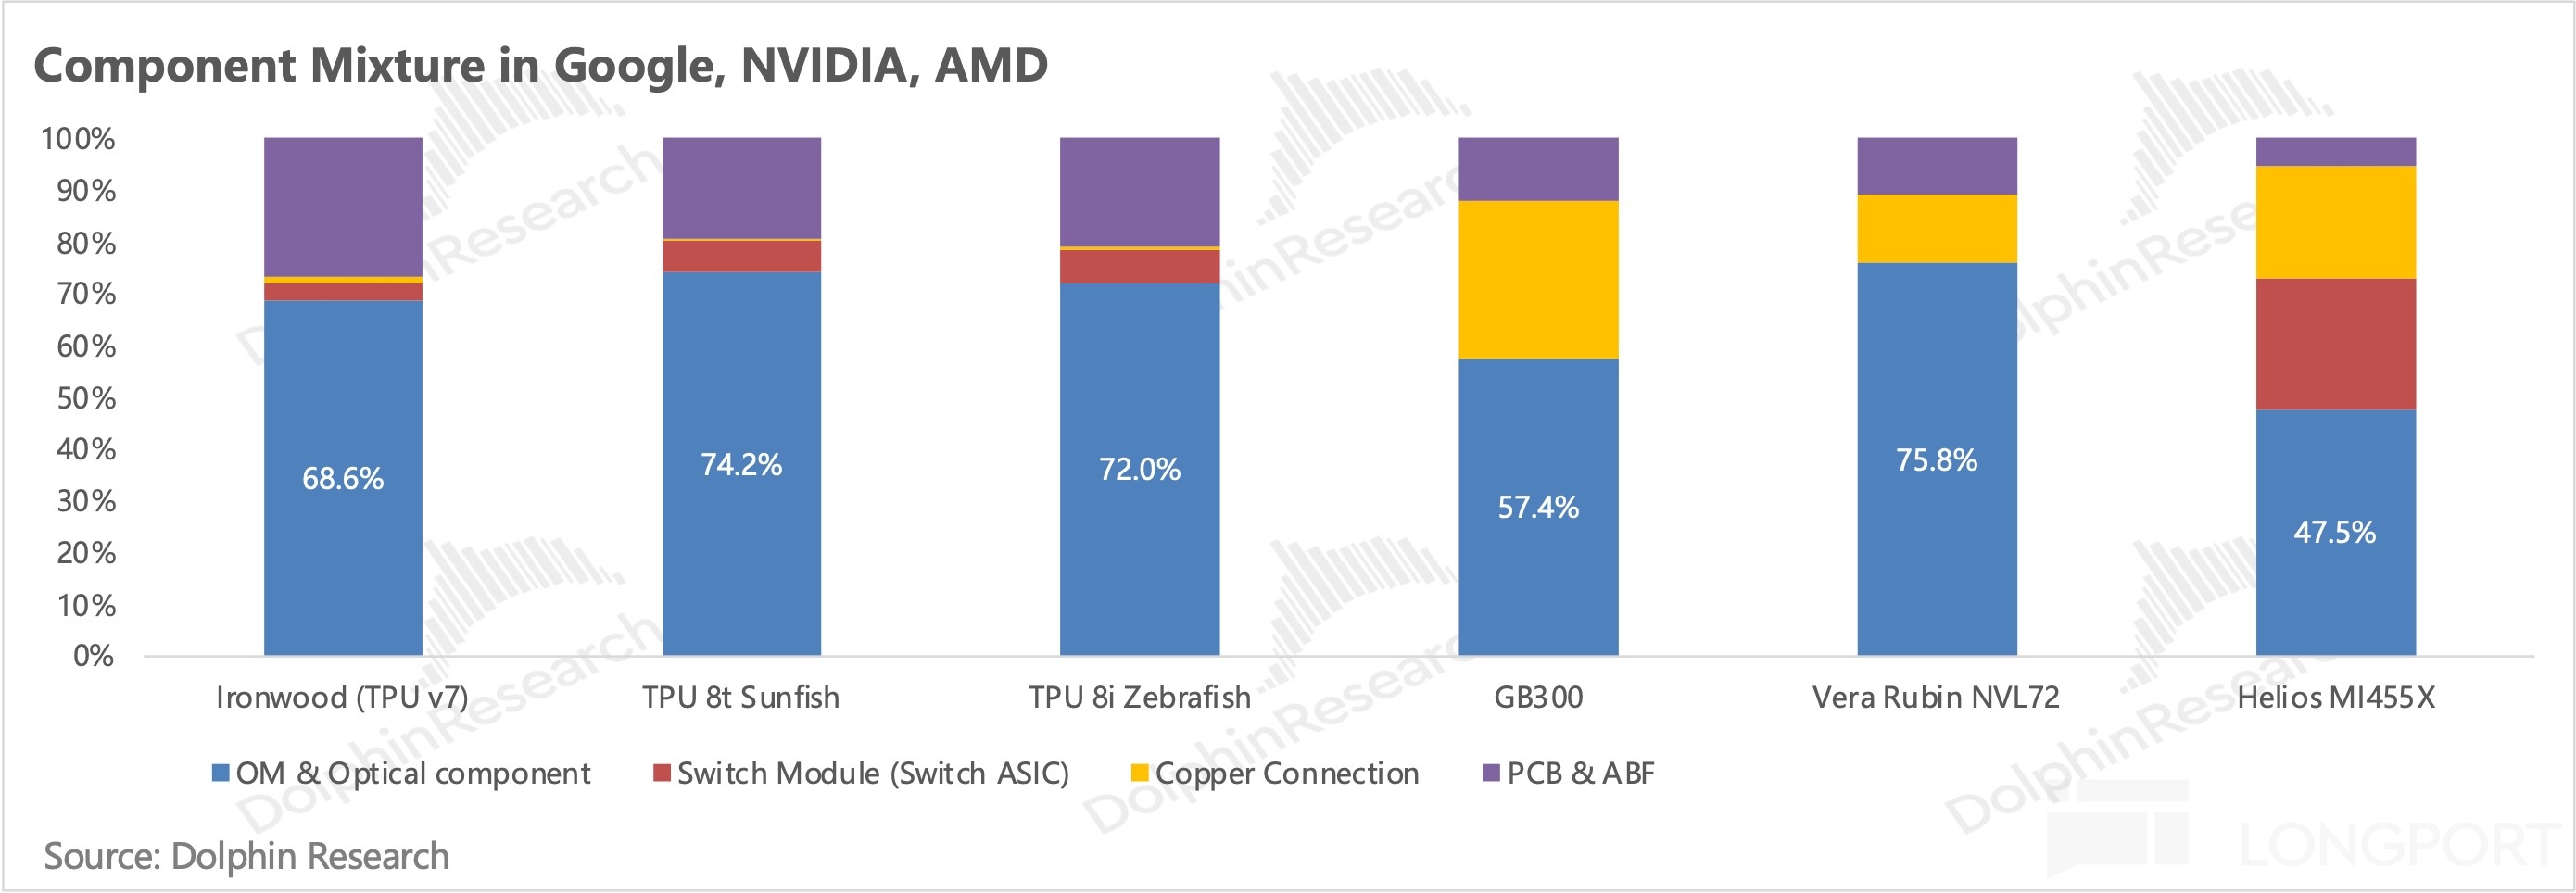
确定性上我们从方案迭代角度考虑:
我们认为确定性最强的是 PCB。因为无论 Trn4 走哪条路,板材都需要升级:
- 若继续走 PCIe,代际迭代会同时抬高板材、Retimer 与 SerDes 的要求,Gen7 对板材压力更大。但其中只有板材是刚性的:Retimer 并非必需品,SerDes 强的方案(如英伟达)可以不用,PCB 板材增强后亦可能移除部分 Retimer。
- 若转向 NVLink(Trn4)或 UALink,单通道速率达到 200G,信号需要 M9 乃至更高等级材料,确定性更强。
其次是光连接和铜连接。
- 大规模组网需求下,Scale-Out 使光连接的确定性与价值量双双抬升。
- 铜连接仍将以柜内连接为主要场景,AWS 在跨柜组网上是 AEC 的忠实采用方,但无法排除 AWS 趋向行业方案、跨柜走光的可能性。
再次是交换。Trn3 生命周期内以采购标品为主,核心供应商是 $Astera Labs.US ,但在下一代交换芯片(交换托盘内)上,可能会转向$高通.US ,详细点评请参见。
而在 Trn4 代际,若走 NVLink Fusion,交换芯片可能依赖 NVSwitch;若走 UALink,也可能让位于 AMD(芯片在 Marvell 与 ALAB 共同研发中)。
最后是 PCIe Retimer。价值量不高,且存在板材对它的替代,是当前必需、但可能被优化掉的环节。
关于光连接,交换以及 PCB 的产业链详细逻辑可回溯此前的深度。
3、铜连接没机会了吗?
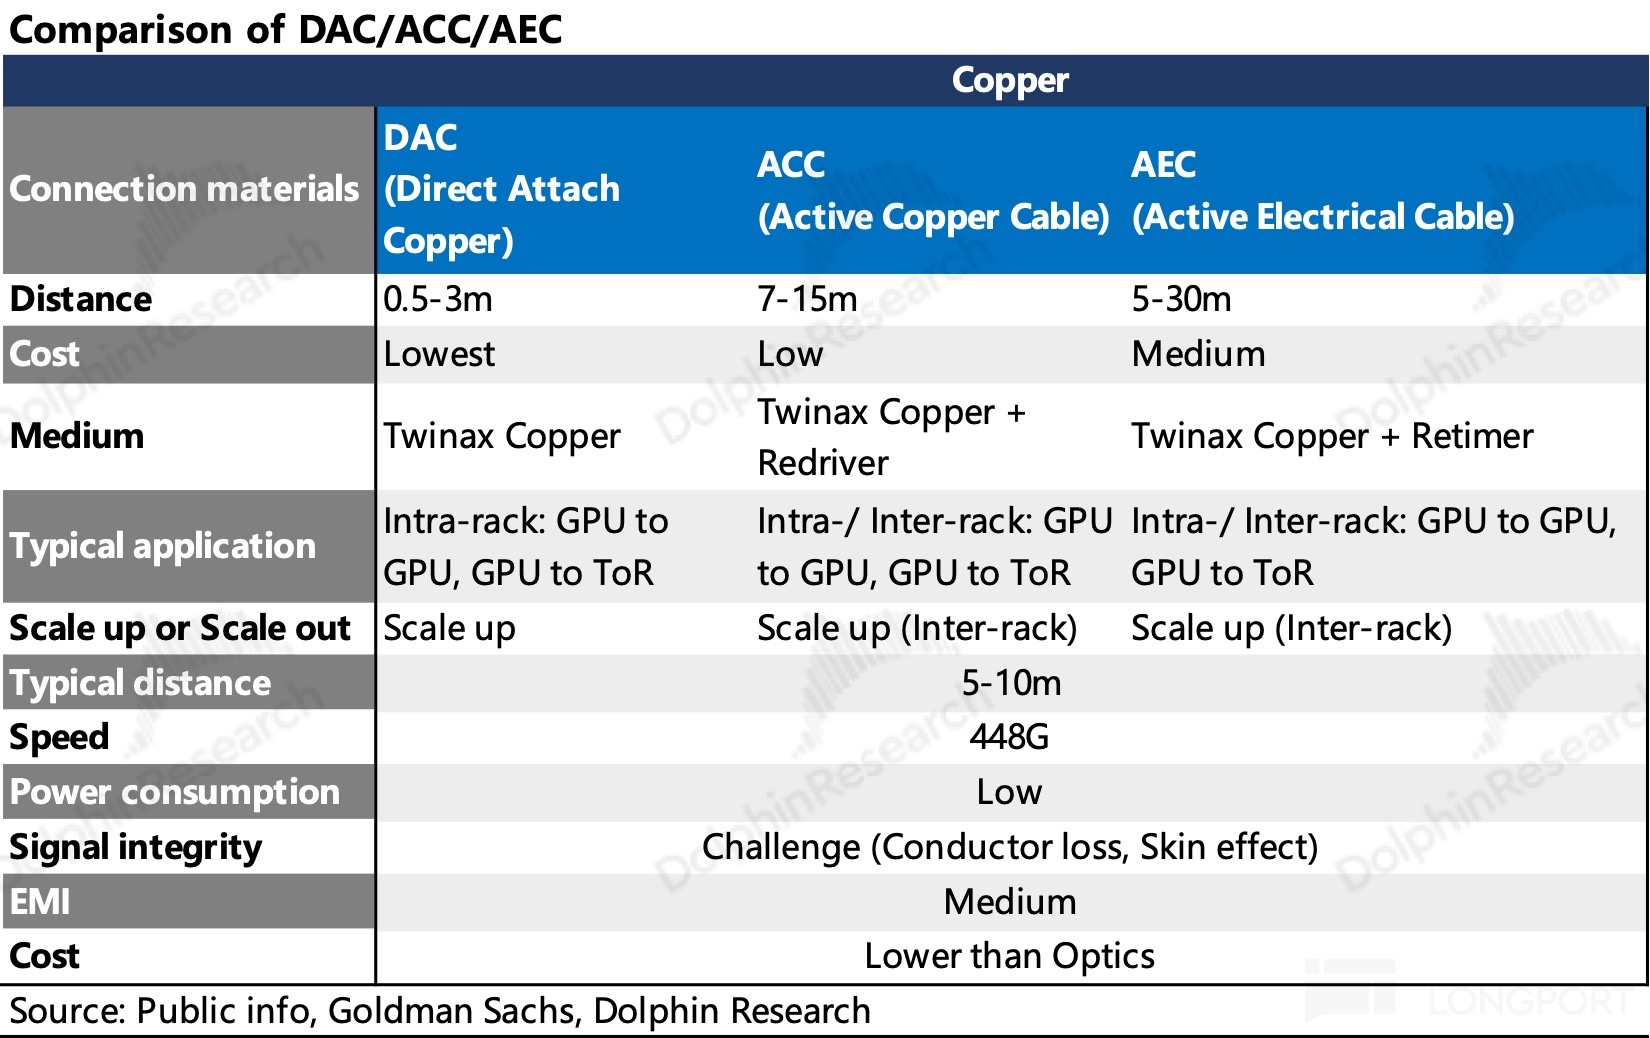
高速铜缆可分为 DAC、ACC 和 AEC。相比 DAC,ACC 通过在线缆的接收端加入 Redriver 来延长铜缆的传输距离;AEC 在线缆两端引入 Retimer 对电信号进行重定时,补偿铜缆损耗的能力更强,传输距离进一步延长,正如表中所示,AEC 的传输上限长达 30m。
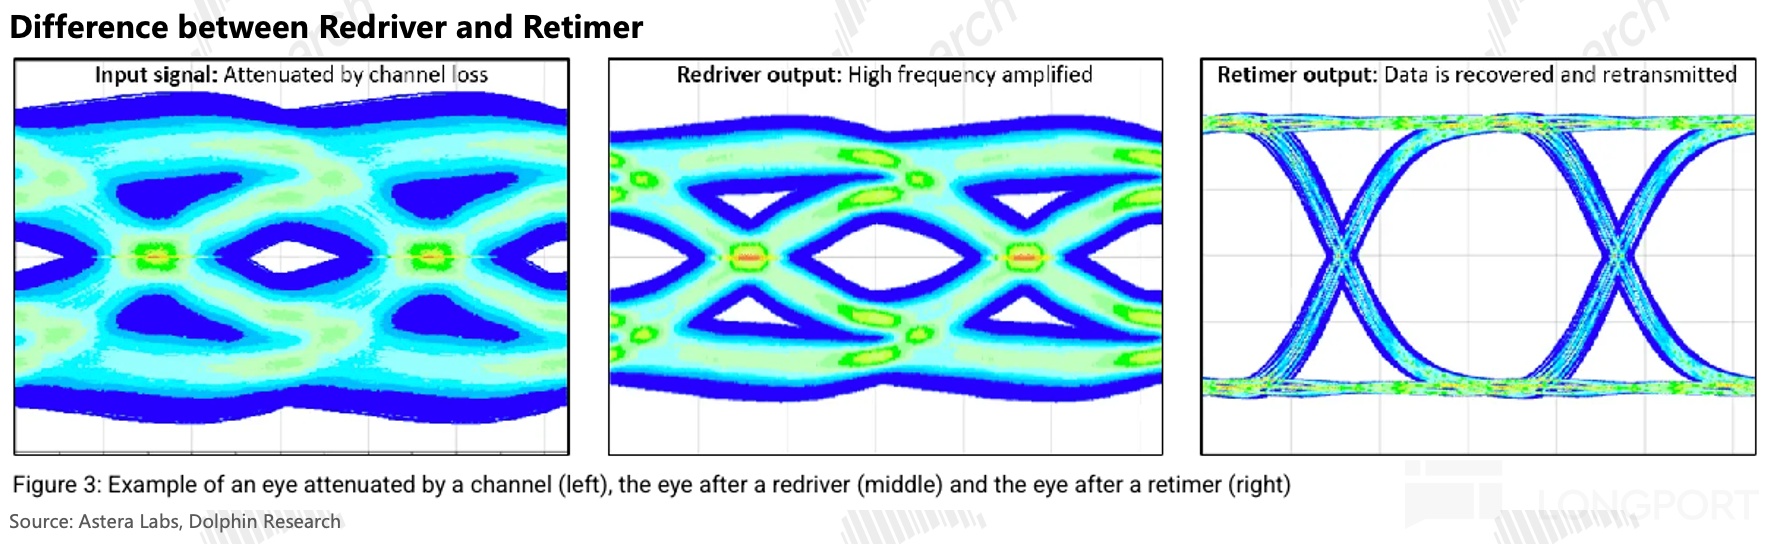
下图的信号眼图解释 Redriver 和 Retimer 的区别:「眼睛」张得越开、越干净,接收端越容易分清 0 和 1。信号经走线衰减后,眼睛几近闭合(左);Redriver 放大衰减的信号,眼睛重新张开,但噪声也被一并放大(中)。
Retimer 重定时的做法是:把信号收下、重新判断后再发一遍,输出一份全新的干净信号(右)。
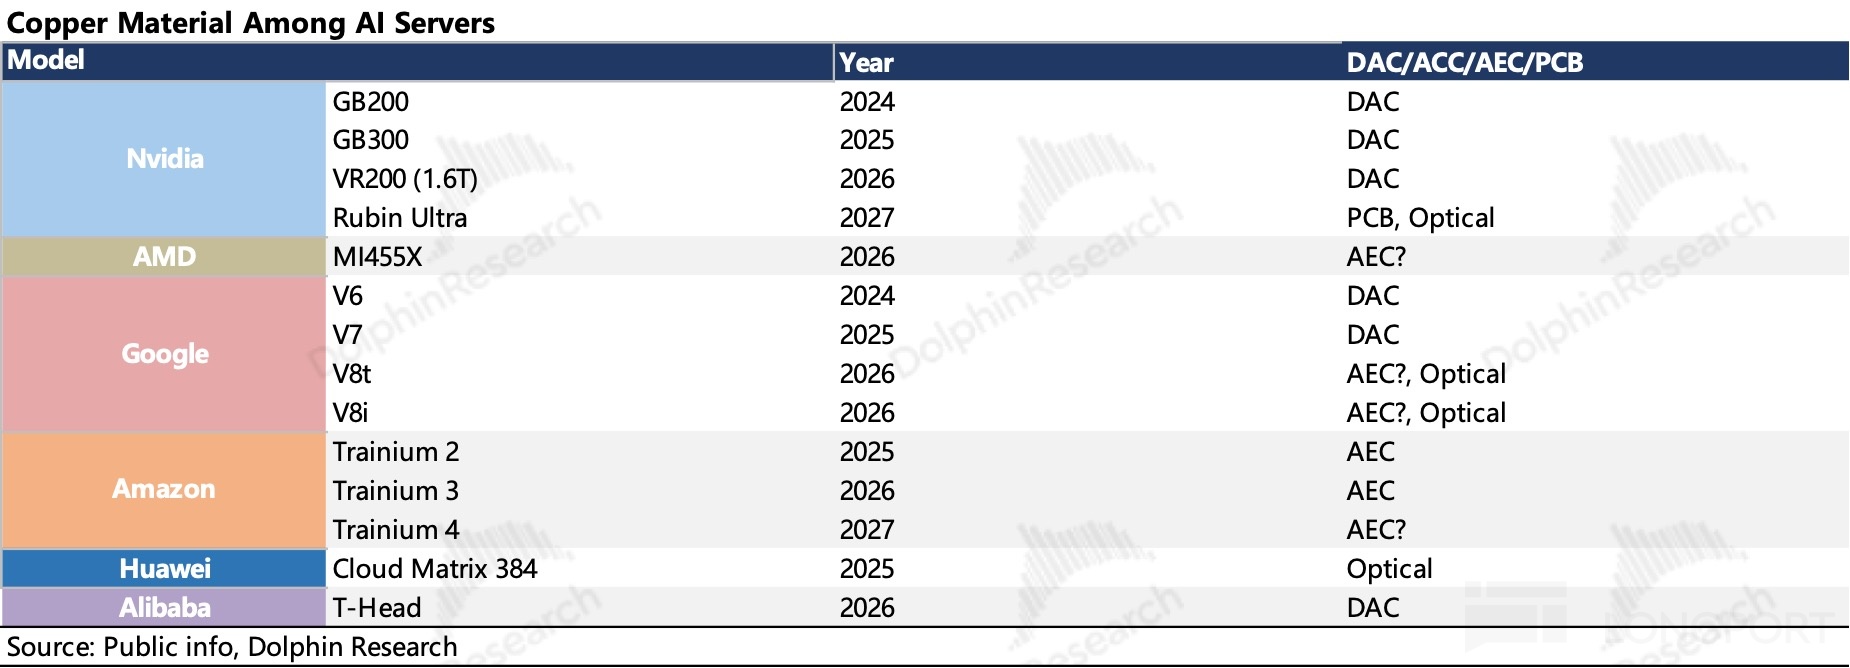
行业而言,Scale-Out 以光为主,机柜内部的 Scale-Up 仍以稳定、高效、便宜的 DAC 为主,铜的基本盘仍在。但这块基本盘也并不稳定:英伟达 Kyber 机架以 PCB 中板取代柜内铜缆,对铜缆是利空。
海豚君认为,铜连接的增量在 AEC,来自两类场景:
一是 Scale-Up 域开始出柜,但只跨一两个相邻机柜,距离超出 DAC 的可达范围,又因功耗与可靠性不值得上光,AWS 的跨柜方案即属此类;
二是单通道速率持续提升,DAC 能走的距离越来越短,部分原本用 DAC 的链路被迫升级为 AEC。
中长期看,跨柜距离再拉长,铜缆将鞭长莫及:Rubin Ultra NVL576 横跨 8 个机架,已规划引入光连接。
4、AEC 产业链
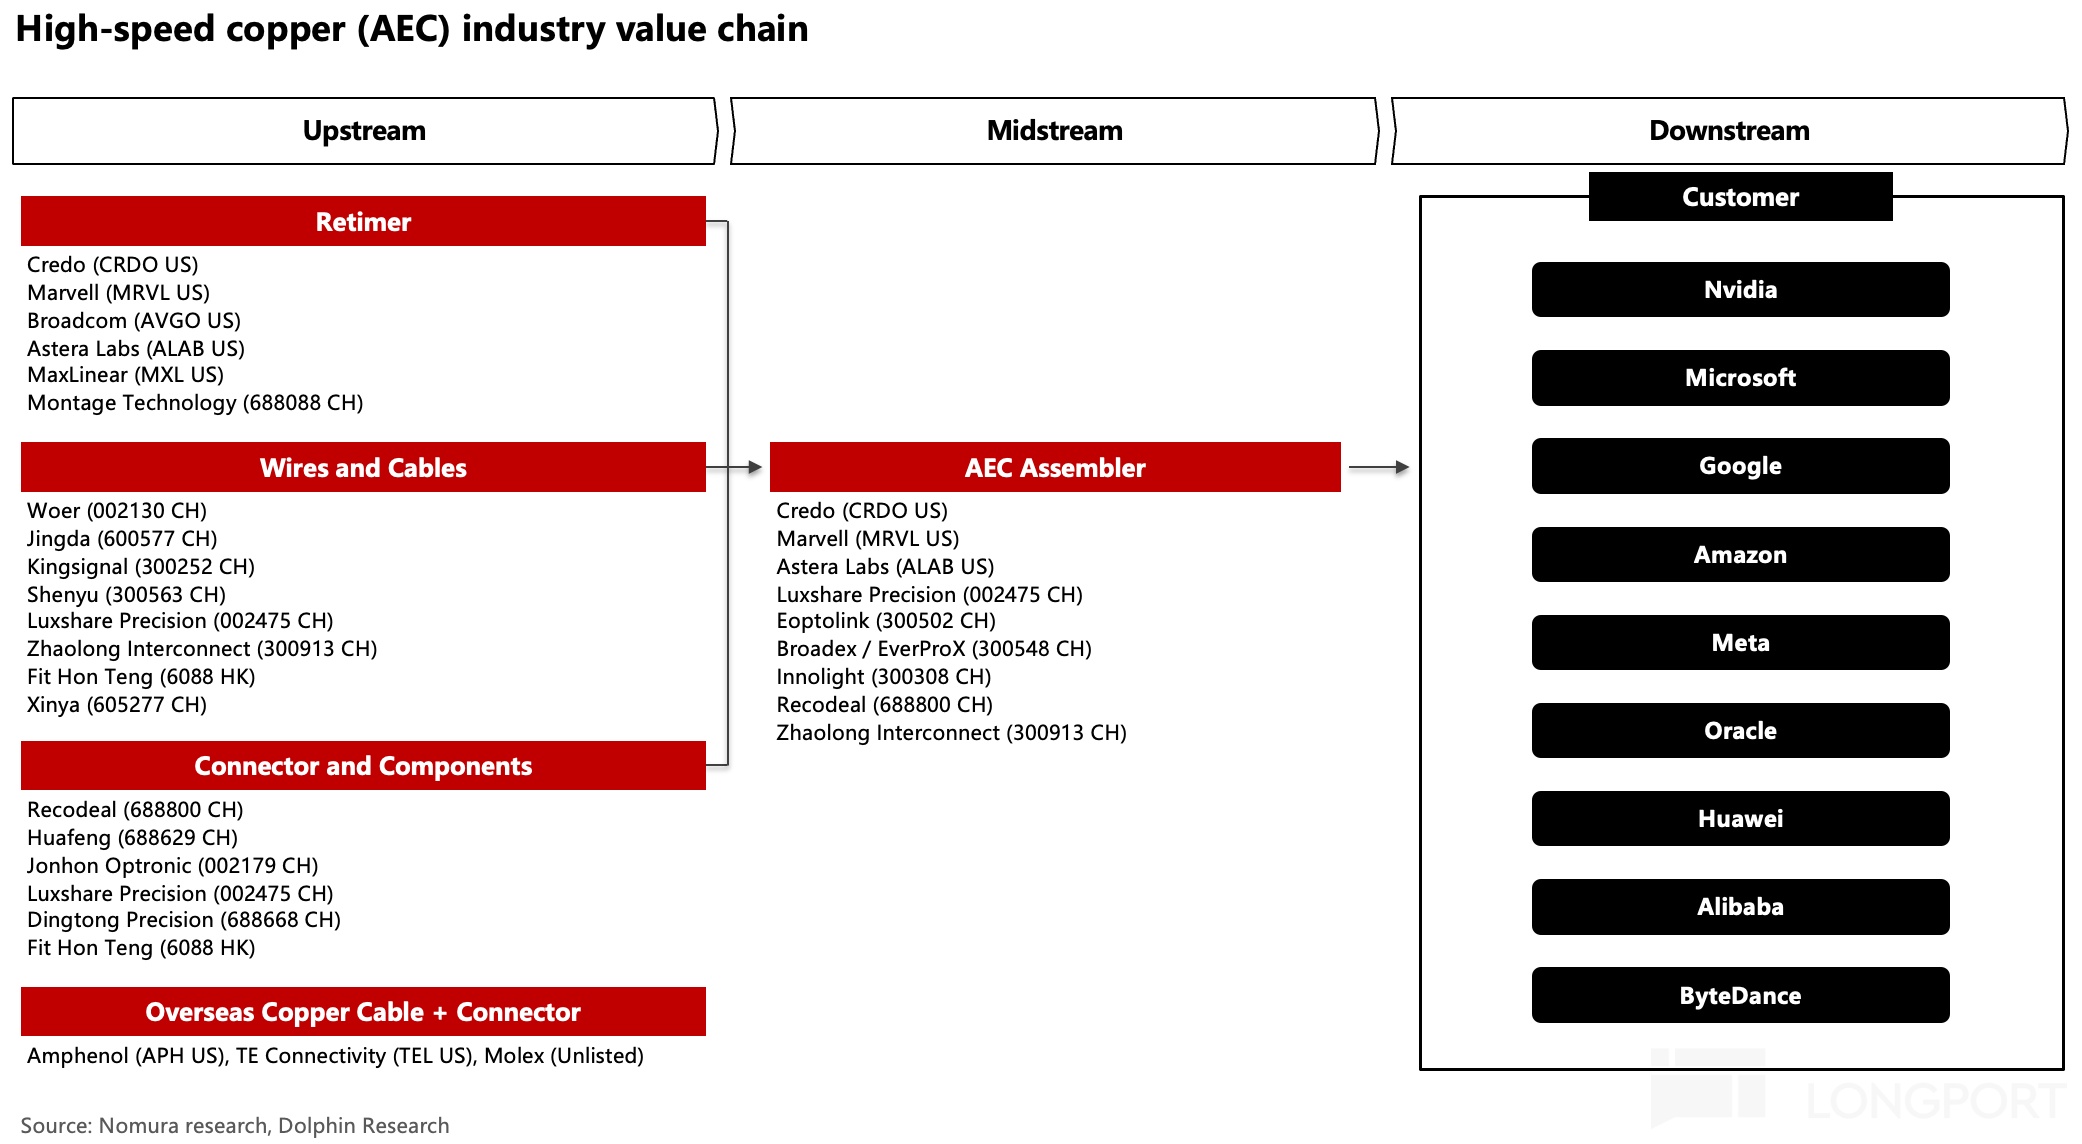
AEC 价值链的上游包括原材料(铜与塑料材料)、芯片/线缆/连接器制造。我们推荐关注高价值量的上游 AEC Retimer 芯片以及高速连接器环节。
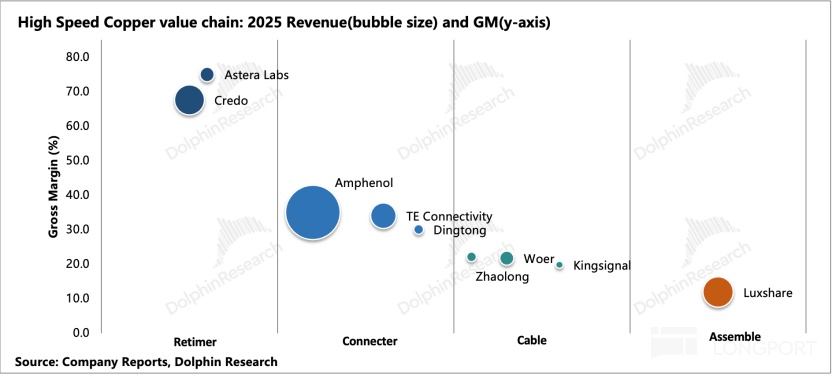
1)Retimer 芯片:$Credo Tech.US 一家独大
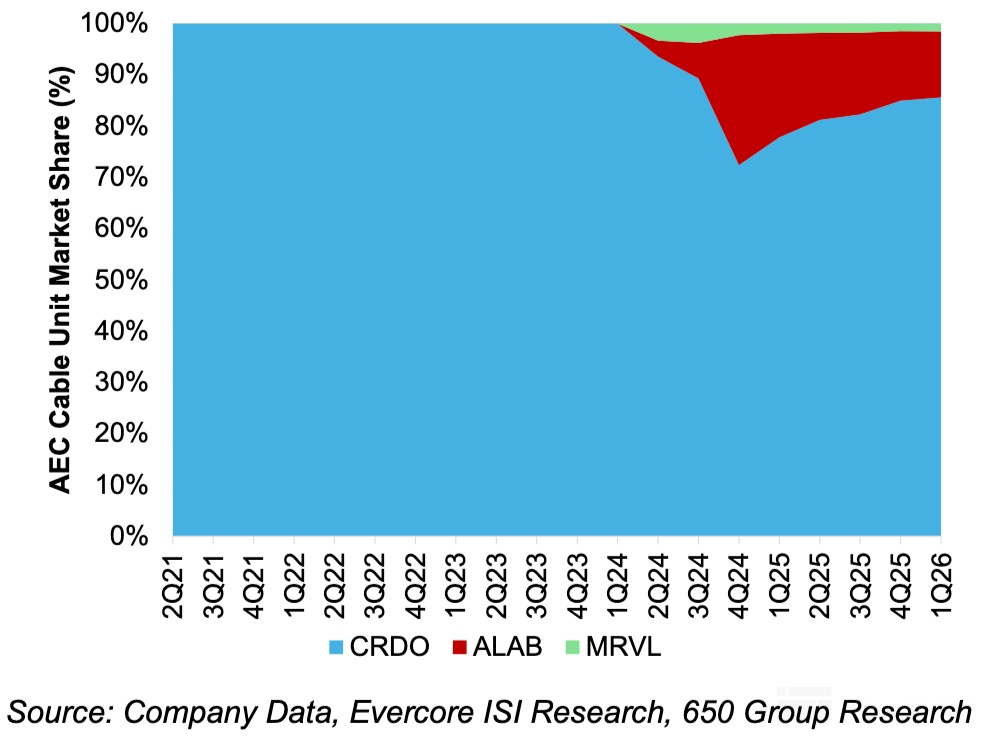
Retimer 芯片是 AEC 价值量最大的部分,而这部分利润主要归芯片方所有。Credo 占据超 80% 的市场份额,其作为 AEC 的开创者,是目前唯一能够同时提供芯片 + 成品线缆的垂直整合厂商,先发优势明显。Astera Labs 的份额次之,而$迈威尔科技.US 、$博通.US 仍在扩张中。
2)高速连接器:海外巨头守门,国产加速追赶
该环节对导电性与机械强度要求严苛,传统连接器巨头(如$安费诺.US 、$泰科电子.US )长期占据第一梯队,凭借技术积累与芯片厂商(如 Credo)协作,形成从芯片到组装的完整方案。而面对光进铜退的市场趋势,行业龙头安费诺、TE 正通过收购补充光连接的能力。
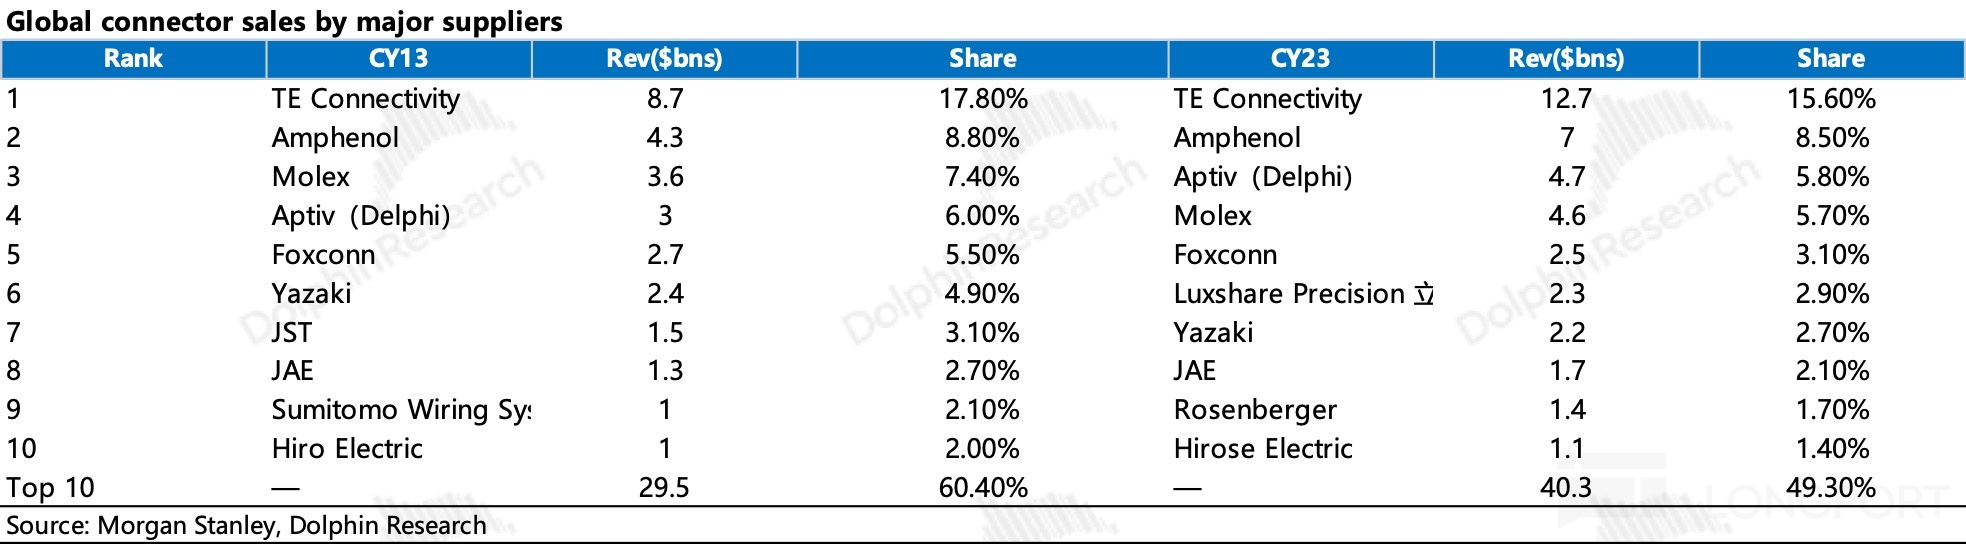
竞争格局上,连接器市场的 CR10 份额从 2013 年的 60% 下滑至 2023 年的 50%,竞争更为充分且分散。国产厂商中$立讯精密.HK 进展较快,2023 年的市占率已升至第六;沃尔核材、兆龙互连正在上量。
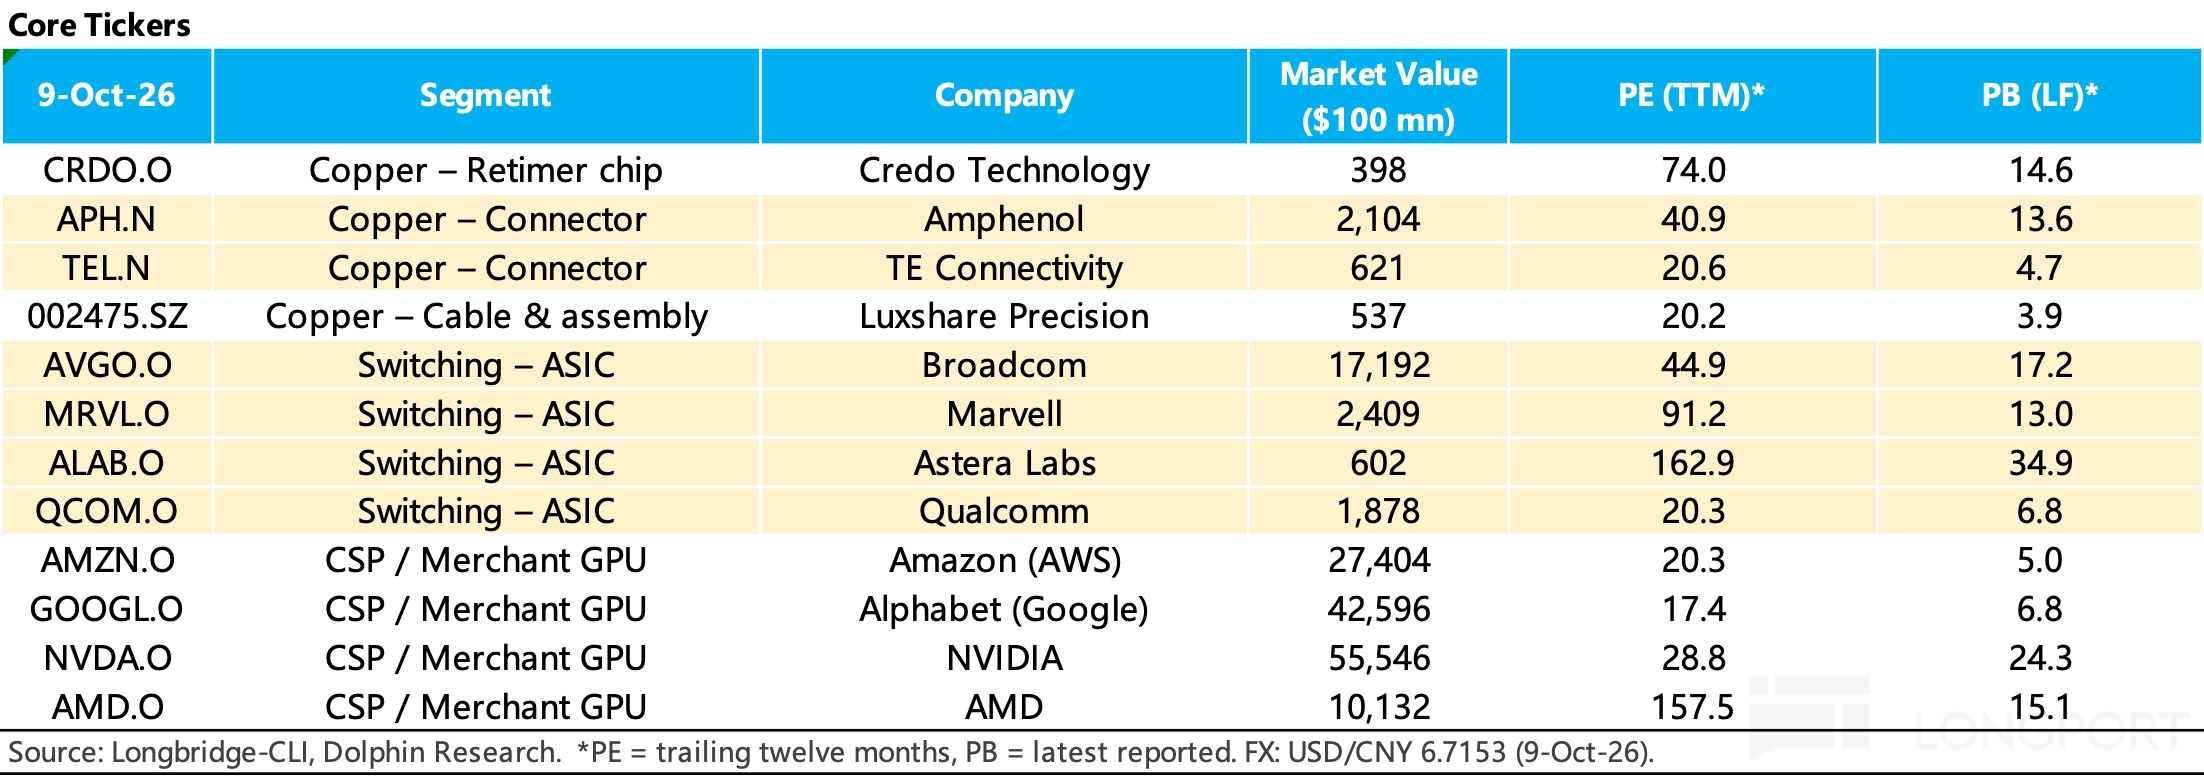
本文提及的核心标的如下(具体可点击此处:海豚君连接股单),光模块、CPO、PCB 等其他连接硬件的核心标的请参见此前的深度。
附录
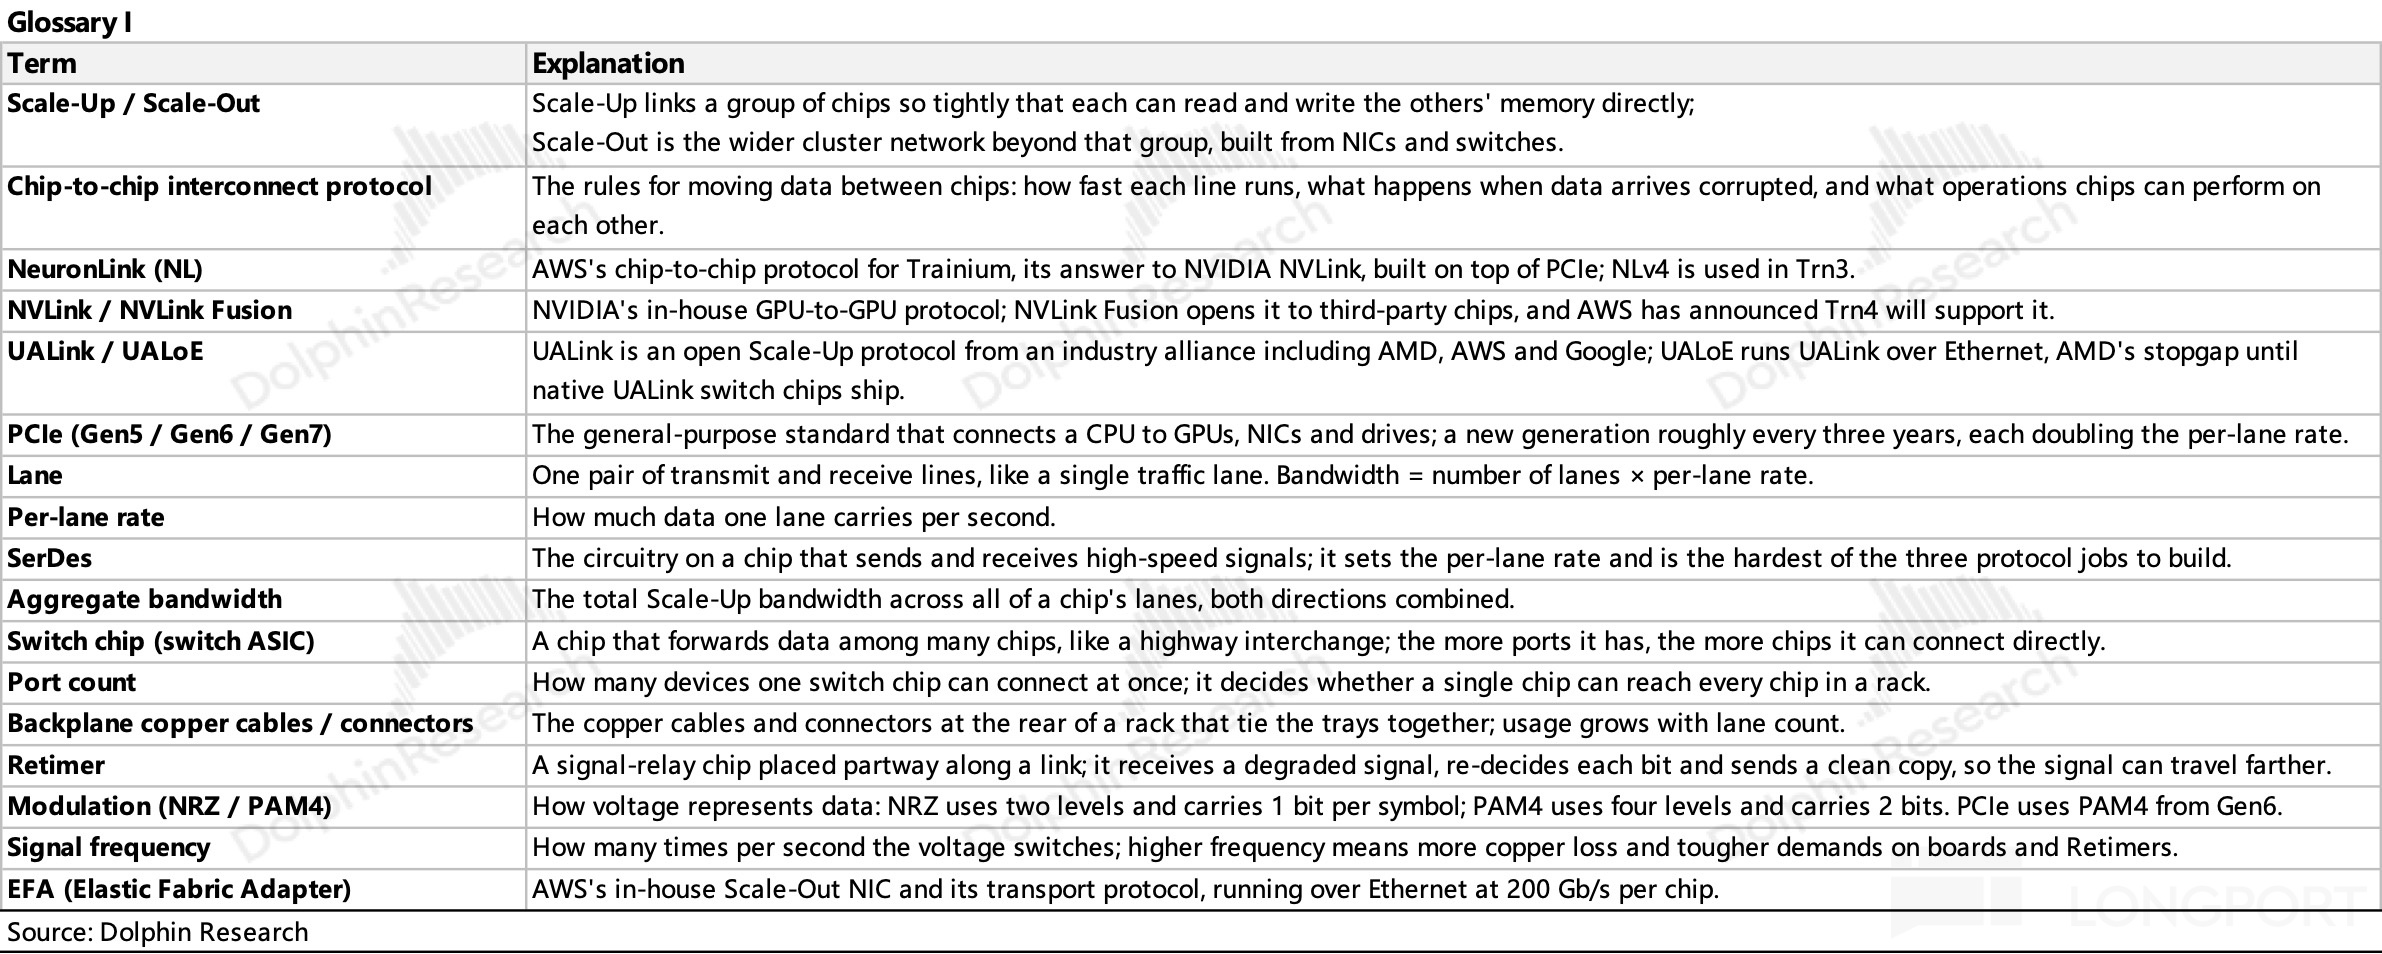
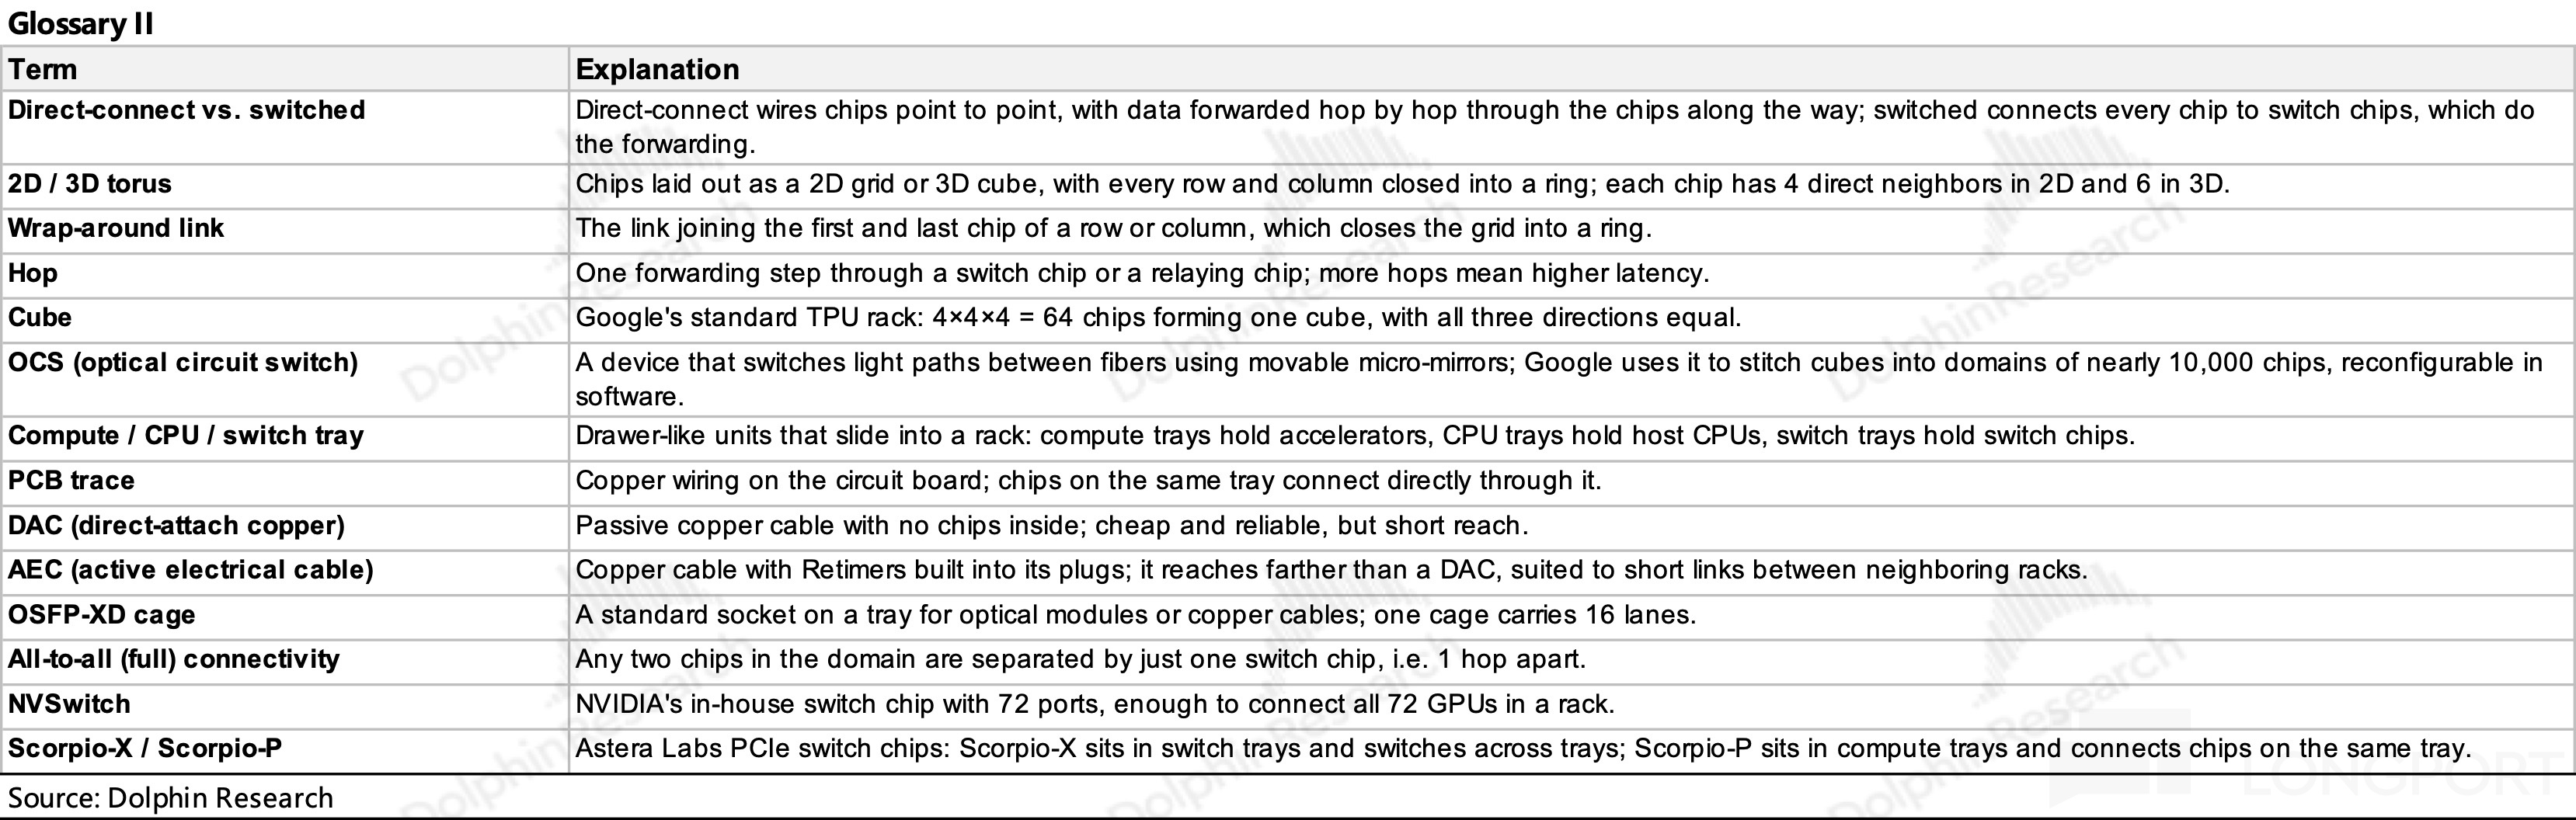
<此处结束>
本文的风险披露与声明:海豚研究免责声明及一般披露
海豚君 AI DC 互联系列分析:
CPO 行业
《AI 超连接时代:AI 向 “光” 飞奔?》《“‘铜’ 牛夫人” 不走!CPO:真机会 or 镜中花?》
组网架构
英伟达组网:《AI 时代 DC 互联:单芯之上抱 “网” 作战,真有 “中国” 机会吗?》
DC 组网之 AMD vs 英伟达:《AMD 跟英伟达 “掰手腕”,Helios 够格吗?》
谷歌组网:《叫板英伟达霸权,谷歌 “光网” 凭什么?》
AWS 组网 (上):《AWS 图省事:套壳 PCIe,组网能打吗?》(链接 xx)
个股
Lumentum(上):《从光互联老炮到 “全能卖水人”,Lumentum 凭什么?》
Lumentum(中):《Lumentum:产能告急,“全能卖水人” 还有什么看家绝活?》







