


英特爾XBM內存專利炸場!速度32GT/s劍指HBM4



一、XBM是什麼?
1.1 事件背景
7月7日英特爾公開XBM專利,科創板日報7月8日深度報道。定位HBM4直接替代方案。此前英特爾HMC/MCDRAM均未能量產。商業化預計2030年後。
1.2 核心問題:AI內存牆
NVIDIA H100→B200算力提升5倍(4000→20000TFLOPS),但HBM帶寬僅從6.4→9.6GT/s(+50%)。這一剪刀差就是內存牆困境。XBM旨在從架構層面打破此瓶頸。
1.3 雙路並進戰略
英特爾並行開發兩種方案:XBM(2030+,BEOL+MoP)和ZAM(2029年,與SAI MEMORY聯合開發,熔合鍵合9層DRAM,帶寬密度約HBM4兩倍)。ZAM將在2026年VLSI研討會展示。
1.4 XBM硬件架構
三大組件:①封裝基板(與HBM4一致,芯片堆疊位於SoC兩側);②可選基底芯片(管理數據讀寫);③堆疊式存儲芯片陣列(BEOL+TFT工藝,容量0.5-5GB,工作頻率2GHz,靠子通道數量和堆疊層數控制數據塊規模)。搭載32GT/s UCIe通用芯粒互聯接口。
二、兩大核心創新
創新一:後段晶體管(BEOL)重構底層架構
將1T1C從FEOL移至BEOL金屬通孔堆疊區,採用薄膜晶體管TFT工藝。三重優勢:面積利用率提升、TSV密度增加(直接提升帶寬)、契合英特爾存儲層疊於邏輯上方技術路線。
創新二:MoP定製封裝方案
專利側重點不在存儲單元本身,而在定製化封裝方案。MoP+反向懸垂結構:傳統MoP增厚300-350微米,新結構降低堆疊高度+取消防翹曲加固筋+電壓調節器直供DRAM。芯片堆疊位於SoC模塊兩側。
性能對比表
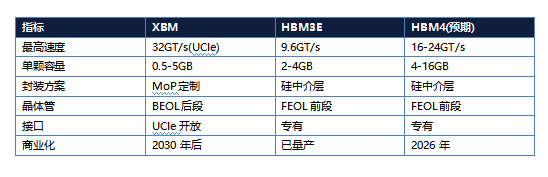
XBM的32GT/s速度實現對比HBM4預期值50%以上領先。
三、XBM vs HBM:兩種技術路線的全面對比
HBM的命門:硅中介層的雙刃劍效應
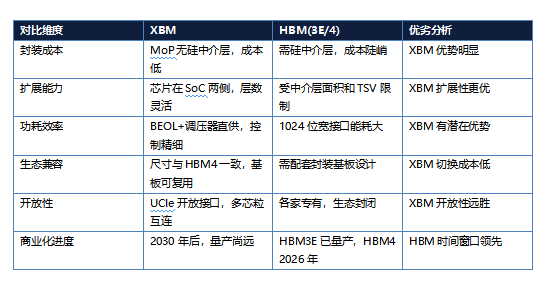
HBM通過TSV+硅中介層連接處理器,單堆疊位寬1024位。但所有信號走線必須經硅中介層→封裝成本極高。HBM4堆疊16-20層,SK海力士/三星投入超百億美元。業界均在研究HBM替代方案。
XBM差異化路徑:MoP+UCIe繞開硅中介層
MoP封裝直接集成在處理器基板上,繞開硅中介層,成本大幅降低。尺寸與HBM4一致,封裝基板可兼容。UCIe開放接口不受專有標準限制。
六大維度深度對比
雙路並進:XBM+ZAM並行開發
英特爾至少兩種HBM替代方案——XBM(2030)和ZAM(2029)。ZAM採用熔合鍵合堆疊九層DRAM,層間硅層約3微米,帶寬密度約HBM4兩倍。
綜合研判
HBM在2030年前難以撼動,但XBM/ZAM釋放了重要信號:①高帶寬內存天花板正被撬動;②英特爾重返DRAM決心不容小覷。短期關注HBM產業鏈確定性,中長期需跟蹤UCIe生態成熟度和先進封裝迭代速度。
四、券商觀點
中信證券
中信認爲XBM專利公開標誌着AI內存競爭從產能競賽進入架構創新新階段。從三方面分析:
第一,技術路線:UCIe接口打破HBM專有壁壘,推動AI內存從封閉走向開放。
第二,商業化:XBM 2030年量產前HBM鏈有3-4年穩定窗口期。
第三,投資方向:建議關注HBM設備材料公司+先進封裝/芯粒互聯標的。
天風證券
天風指出XBM+ZAM雙線表明英特爾在HBM替代領域已進入實質性加速階段。ZAM(2029)採用熔合鍵合九層DRAM約3微米硅層,帶寬密度≈HBM4兩倍。
核心判斷:AI內存正從製造驅動轉向架構驅動,有利於架構積累深厚企業,對純製造依賴的存儲廠商構成長期挑戰。
國金證券
國金指出BEOL+定製封裝組合路線可在同等或更低成本下實現更高帶寬,是XBM最具顛覆性的價值主張。
建議關注多技術路線均有佈局的泛封裝產業鏈龍頭。先進封裝和異構集成能力是AI內存不可繞過的核心壁壘。
以上券商觀點來源於公開研報信息整理。
風險提示:本文僅爲行業與技術分析,不構成任何投資建議。
來源:證券之星 | 科創板日報/IT之家/Wccftech/公開研報 | 2026-07-08







