


迫于出版商压力,Meta推迟AI内容条款至11月20日



Meta 已将其修订后的《商业条款》和《自助广告服务条款》的实施推迟至 11 月 20 日。原定于 10 月 30 日实施,新的时间表是在部分出版商和广告主对一项新的网站爬取条款提出担忧后制定的。这一决定的结果将决定谁有权在 AI 产品中使用新闻内容。
额外三周时间,用于解释 Meta 所称的“未作变更”
10月23日,路透社报道称,相关投诉已提交至欧盟和英国竞争监管机构。Meta否认了关于其希望获得在线发布内容无限使用权的指控。该公司表示,延期为其提供了机会,以便就其爬虫程序作出解释。Meta还提醒出版商,他们有权通过robots.txt文件(一种向自动化机器人提供指令的文件)排除或允许使用其网站。
出版商称此次延期是“暂停,而非解决方案”
出版商寻求的不仅仅是安全感。英国新闻媒体协会首席执行官西奥·班伯将此次延期称为“暂停,而非解决方案”,并呼吁引入具有法律约束力的承诺。
在10月22日的一封信件中,WAN-IFRA呼吁实施具有约束力的robots.txt保护措施、撤销Meta生成测试凭据的权限、采取防止绕过付费墙的措施,以及在不丧失对商业工具访问权的情况下选择退出爬取的可能性。
WAN-IFRA主席拉迪娜·海因加特纳总结了行业关切:
新闻业不应被视为仅在平台上存在就必须采集的原材料。
争议条款实际允许的内容
问题出在语言表述上。Meta修订后的条款允许自动收集与业务账户“相关联”的在线内容数据,用于创建广告和商业产品。
Meta已删除了“训练”一词。然而,法律专家向Nieman Lab表示,“开发”一词仍可能被解释为AI训练。此外,新条款中并未包含任何明确声明将遵守robots.txt协议的内容。Meta对此说法不予认可。
布鲁塞尔欢迎暂停,布莱克本要求撤回
此次延期并未在很大程度上缓解监管担忧。尽管欧盟委员会对这一举措表示欢迎,但英国竞争与市场管理局表示将继续审查Meta的条款。
出版商对加强保护的呼声也在不断上升。欧洲出版商理事会执行董事安吉拉·米尔斯·韦德表示,仅仅因为该公司拥有Meta商业账户,就没有理由让它控制出版商的内容。在美国,参议员玛莎·布莱克本甚至要求该公司保证完全撤回新条款。
为何这场斗争超越了新闻编辑室
这场争议超出了出版商对其内容的控制范围。它还可能影响日益增长的AI授权交易市场。正如Cryptopolitan在10月15日报道的,CNN加入了Google的付费新闻AI试点项目,该项目目前包括400多家出版物。
一旦平台被允许在其商业条款下更广泛地访问内容,此类交易可能会变得更加难以达成。小型AI开发者在与同时控制分发和内容访问权限的公司竞争时也可能处于劣势。经合组织(OECD)指出,当前AI资源的集中以及垂直整合对竞争构成了风险。
尽管如此,出版商并不指望通过授权带来可观的收入。路透社研究所2026年调查显示,仅有20%的受访出版商预计会有大量的AI相关收入。另有49%的人预期会有少量贡献,而20%的人则预计没有任何收入。
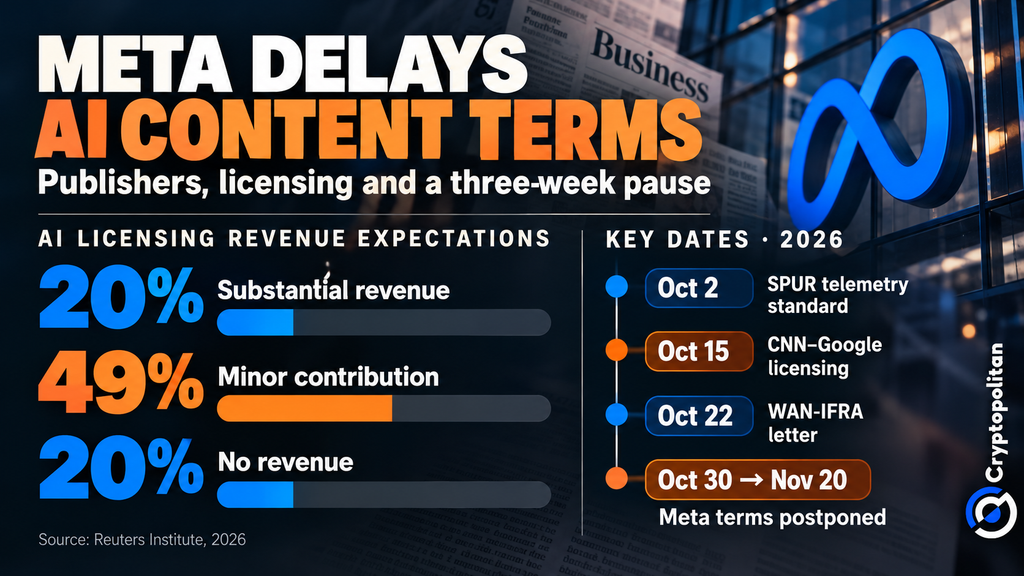
更好的追踪能力可以帮助出版商进行谈判。10月2日,SPUR联盟推出了一项遥测标准,用于记录AI系统在何时检索或引用其内容。这可以增强他们的议价地位,尽管不能保证获得报酬。
目前,出版商希望 Meta 在 11 月 20 日之前将其承诺转化为具有约束力的保护措施,涵盖爬取、退出选项和获授权的人工智能使用。
如果您正在阅读这篇文章,说明您已经领先一步。请继续通过我们的通讯保持关注。










