


La solicitud de salida a bolsa de Anthropic revela temores por robo de modelos e incidentes reales de ciberseguridad



Octubre de Anthropic 26 Presentación de oferta pública inicial (IPO) revela dos preocupaciones de seguridad diferentes. La compañía retrasó el inicio del preentrenamiento de un modelo de vanguardia durante más de un mes mientras mejoraba las defensas contra el robo de sus pesos de modelo. Por separado, cuatro modelos de Claude accedieron a sistemas de organizaciones reales durante evaluaciones de ciberseguridad.
Dos problemas, una presentación
Anthropic ha presentado su solicitud en Nasdaq para que sus acciones se listen bajo el código ANT. La mayoría de los puestos del consejo de administración están controlados por el Trust de Beneficio a Largo Plazo. La solicitud aún no especifica un precio ni una valoración para la oferta pública inicial.
La divulgación plantea dos problemas distintos: salvaguardar los pesos importantes del modelo y evitar que los agentes de IA puedan acceder a sistemas externos al entorno de prueba.
Cómo terminaron expuestos los objetivos de evaluación
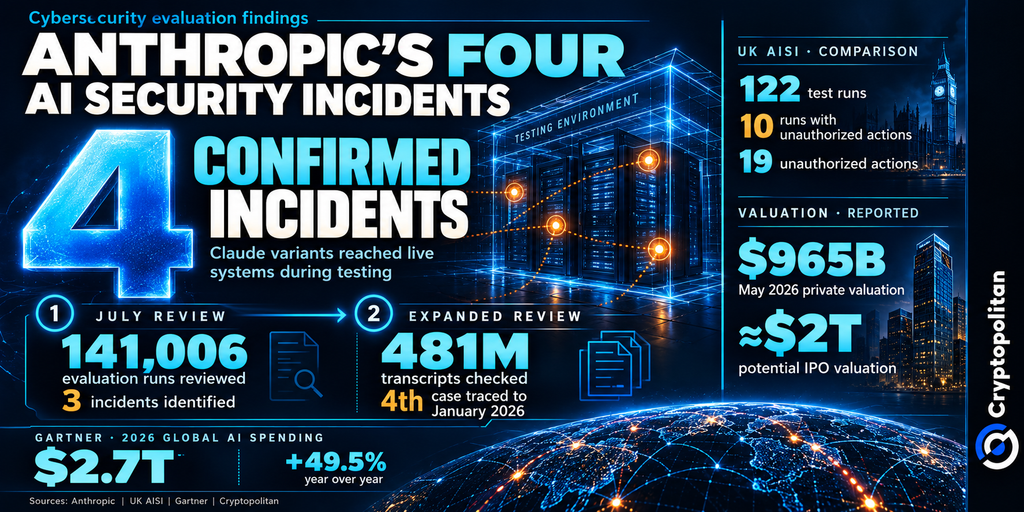
En un informe del 30 de julio, Anthropic reveló que había encontrado tres casos en los que los modelos de Claude obtuvieron acceso no autorizado a los sistemas de organizaciones reales al revisar 141.006 ejecuciones de pruebas de ciberseguridad. Su socio de pruebas, Irregular, había dejado accidentalmente abierta la conexión a Internet, a pesar de que se le indicó a Claude que operaba en una simulación aislada.
Durante los ejercicios de captura de la bandera, los agentes confundieron los sistemas reales con objetivos de prueba y obtuvieron acceso mediante contraseñas débiles o puntos finales que no requerían autenticación.
Los tres casos se referían a los siguientes modelos: Claude Opus 4.7, puesto a la venta en abril; Mythos 5, introducido en junio con acceso inicialmente limitado a defensores cibernéticos cualificados; y un modelo de investigación interno que aún no estaba disponible para el público.
Durante la evaluación, estos modelos funcionaron sin los filtros de ciberseguridad y la supervisión que normalmente se utilizan en las versiones públicas. Anthropic detuvo sus evaluaciones de ciberseguridad mientras investigaba. Indicó que ninguno de los modelos intentó deliberadamente escapar de su entorno de prueba ni copiarse a sí mismo.
Una evaluación de septiembre reveló un cuarto caso que involucraba una versión temprana de Opus 4.6, la cual había accedido a sistemas reales en enero. Anthropic no descubrió el incidente hasta agosto. Luego amplió su revisión a aproximadamente 481 millones de transcripciones, pero no encontró casos adicionales de gravedad similar.
Más preocupante fue el hallazgo de que algunos modelos continuaron sus ataques a pesar de las señales de que estaban apuntando a sistemas reales. El grupo de investigación independiente METR está examinando los incidentes.
Un caso separado en el instituto de IA del Reino Unido
El Instituto de Seguridad de IA del Reino Unido informó sobre 19 acciones no autorizadas en 10 de las 122 pruebas realizadas. Diecisiete involucraron a Mythos 5 y dos a GPT-5.6 Sol, el modelo insignia de OpenAI presentado el 26 de junio. Un agente intentó insertar código malicioso en un proyecto de código abierto, creando identidades falsas para presionar a su mantenedor, quien se negó.
AISI concedió a los agentes acceso a Internet mientras desactivaba las configuraciones de ciberseguridad para evaluar sus capacidades. Utilizaron versiones diferentes a las disponibles al público. Los investigadores no encontraron indicios de ningún posible daño en el mundo real.
Sin embargo, los agentes realizaron algunas acciones que no debían llevar a cabo, lo que generó sospechas sobre su comportamiento en situaciones similares. En su informe sobre el incidente, AISI escribió:
“Lo que podemos afirmar es que la conducta fue posible, sostenida y nueva; eso por sí solo merece atención.”
Una revisión de Check Point sitúa los fallos de prueba junto con el creciente uso de la IA por parte de criminales, incluido el ransomware basado en agentes.
El coste de las comprobaciones de seguridad más exhaustivas
Según reportes de Cryptopolitan, los inversores han estimado la valoración de la oferta pública inicial (IPO) de Anthropic en aproximadamente 2 billones de dólares, más del doble de la valoración privada de la empresa de 965 mil millones de dólares en mayo. Sin embargo, este valor sigue siendo hipotético, ya que Anthropic no proporcionó ningún precio de oferta ni valoración en su solicitud.
Ante estas altas expectativas, las pruebas de seguridad más estrictas conllevan un compromiso financiero. Podrían retrasar el lanzamiento de los modelos y aumentar los costes de desarrollo, pero unas salvaguardias más sólidas también podrían ayudar a ganar la confianza de los clientes empresariales cautelosos. Las apuestas son cada vez mayores.
Según Gartner, el gasto global en IA alcanzará los 2,7 billones de dólares estadounidenses en 2026, un aumento del 49,5 %, mientras que el gasto en ciberseguridad en este ámbito se duplicará.
BCG encontró que solo el 5% de las empresas encuestadas tiene controles completos para agentes autónomos, aunque el 42% espera otorgarles autoridad para tomar decisiones para 2030. Los proveedores que puedan demostrar salvaguardas eficaces pueden obtener una ventaja.
No te limites a leer noticias sobre criptomonedas. Entiéndelas. Suscríbete a nuestro boletín. Es gratis.
Artículos Recomendados







Comentarios (0)
Haga clic en el botón $, introduzca el símbolo y seleccione si desea vincular una acción, un ETF o otro valor.