


Meta aplaza los términos de contenido de IA al 20 de noviembre bajo presión de los editores


Meta ha pospuesto la implementación de sus Términos Comerciales y Términos de Publicidad de Auto-Servicio revisados hasta el 20 de noviembre. Originalmente programada para el 30 de octubre, la nueva fecha se produce después de que algunos editores y anunciantes expresaran preocupaciones sobre una nueva disposición de rastreo de sitios web. El resultado de esta decisión determinará quién tiene derecho a utilizar el contenido periodístico en productos de IA.
Tres semanas más para explicar lo que Meta dice que no está cambiando
El 23 de octubre, Reuters informó que las quejas habían sido presentadas ante las autoridades de competencia de la UE y del Reino Unido. Meta desestimó las alegaciones sobre querer tener derechos ilimitados sobre el contenido publicado en línea. La empresa señaló que el aplazamiento le da la oportunidad de explicar el funcionamiento de sus rastreadores. También recordó a los editores que tienen derecho a excluir o permitir el uso de sus sitios mediante robots.txt, un archivo que proporciona instrucciones a los bots automatizados.
Los editores califican el retraso como "una pausa, no una solución"
Los editores buscan más que una sensación de seguridad. Theo Bamber, director de la Asociación de Medios de Comunicación del Reino Unido, calificó el aplazamiento como «una pausa, no una solución», e instó a introducir compromisos legalmente vinculantes.
En una carta fechada el 22 de octubre, WAN-IFRA pidió protecciones vinculantes para robots.txt, la revocación del permiso de Meta para generar credenciales de prueba, medidas que impidan eludir los muros de pago, así como la posibilidad de optar por no ser rastreado sin perder acceso a las herramientas empresariales.
La presidenta de WAN-IFRA, Ladina Heimgartner, resumió las preocupaciones de la industria:
El periodismo no es materia prima que deba ser recopilada como condición para estar presente en una plataforma.
Lo que realmente permite la cláusula en disputa
El problema radica en el lenguaje. Los términos revisados de Meta permiten la recolección automática de datos de contenido en línea "asociado" con cuentas comerciales con el fin de crear productos publicitarios y empresariales.
Meta ha eliminado la palabra "entrenamiento". Sin embargo, expertos legales indicaron a Nieman Lab que "desarrollar" aún podría interpretarse como entrenamiento de IA. Además, los nuevos términos no contienen ninguna declaración explícita de que se respetará robots.txt. Meta discrepa de esta interpretación.
Bruselas acoge la pausa, Blackburn quiere una retirada
El aplazamiento no ha contribuido significativamente a aliviar las preocupaciones regulatorias. Aunque la Comisión Europea acogió favorablemente la medida, la Autoridad de Competencia y Mercados del Reino Unido indicó que continuará examinando los términos de Meta.
También hay una creciente demanda por parte de los editores de mejores protecciones. Angela Mills Wade, directora ejecutiva del Consejo Europeo de Editores, afirmó que no debería haber razón para que la empresa obtenga control sobre el contenido de los editores simplemente por tener una cuenta comercial de Meta. En EE. UU., la senadora Marsha Blackburn incluso ha exigido que la empresa garantice la retirada total de los nuevos términos.
Por qué la lucha trasciende las redacciones
El desacuerdo va más allá del control que ejercen las editoriales sobre su contenido. También podría afectar al mercado en crecimiento de acuerdos de licencia para IA. Como informó Cryptopolitan el 15 de octubre, CNN se unió al programa piloto de pago de Google para IA de noticias, que ahora incluye más de 400 publicaciones.
Estos acuerdos podrían volverse más difíciles de cerrar una vez que las plataformas puedan acceder a los contenidos de forma más amplia bajo sus términos comerciales. Los pequeños desarrolladores de IA también podrían verse perjudicados frente a aquellas empresas que controlan tanto la distribución como el acceso a los contenidos. La OCDE señala que la actual concentración de recursos de IA, junto con la integración vertical, entraña riesgos para la competencia.
No obstante, las editoriales no esperan que las licencias generen ingresos sustanciales. La encuesta de 2026 del Instituto Reuters reveló que solo el 20% de los encuestados de entre las editoriales esperaba ingresos importantes relacionados con la IA. Otro 49% anticipaba contribuciones menores, mientras que el 20% esperaba ninguno.
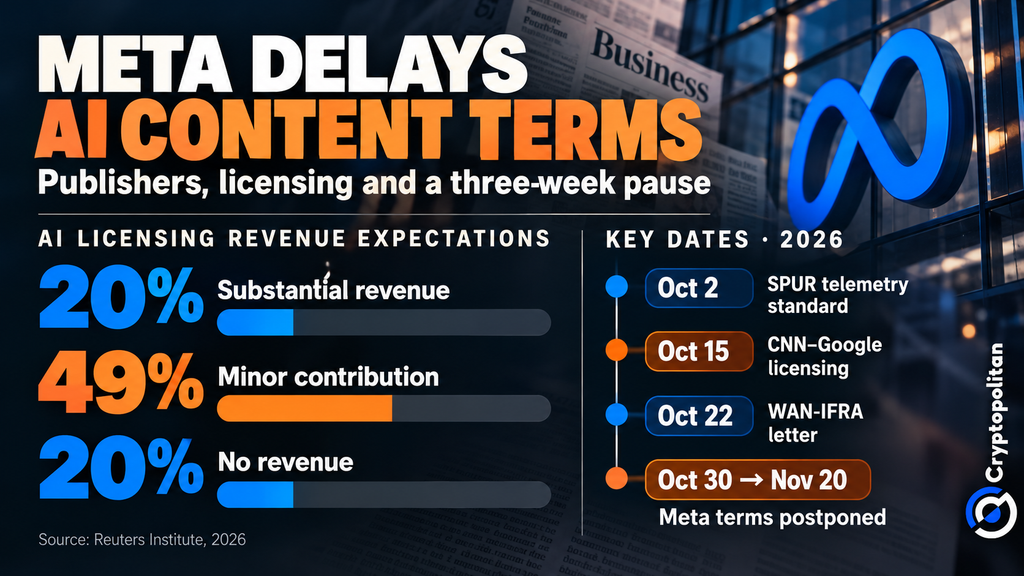
Un mejor seguimiento podría ayudar a las editoriales a negociar. El 2 de octubre, la Coalición SPUR presentó un estándar de telemetría para registrar cuándo los sistemas de IA recuperan o citan su contenido. Esto podría fortalecer su posición negociadora, aunque no garantiza el pago.
De momento, los editores quieren que Meta convierta sus garantías en protecciones vinculantes para el rastreo, las opciones de exclusión y el uso con licencia de IA antes del 20 de noviembre.
Si estás leyendo esto, ya vas por delante. Mantente así con nuestro boletín.
Artículos Recomendados









Comentarios (0)
Haga clic en el botón $, introduzca el símbolo y seleccione si desea vincular una acción, un ETF o otro valor.