OpenAI与微软的版权之争成为对人工智能商业模式的一次考验。



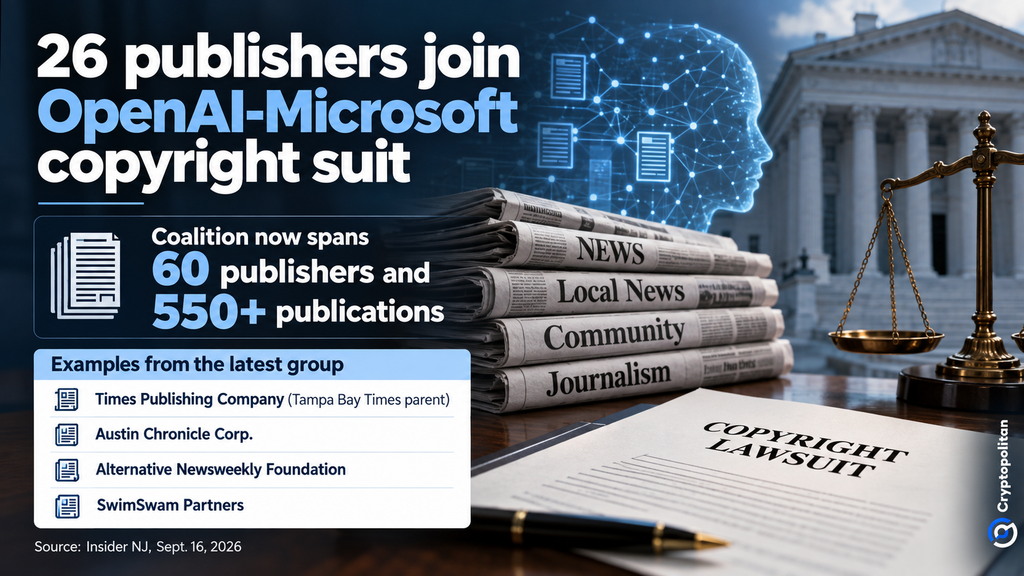
又有 26 家出版商 加入针对 OpenAI 和微软的诉讼,使加入该联盟的出版商总数超过 550 家,这使得此案成为一起大规模案件,决定了生成式人工智能公司如何获取和支付用于创建其产品的内容。
本案的核心问题是一个可能改变人工智能领域游戏规则的根本性问题:在训练大型语言模型时,如何界定使用受版权保护的材料才算合理?答案可能影响许可成本、获取高质量训练数据的途径,并最终决定哪些公司能够参与竞争。.
一个不断壮大的联盟
据普拉特金律师事务所(Platkin LLP)称,该事务所目前在诉讼中代表60家出版商。最新加入的出版商包括《坦帕湾时报》的母公司时代出版公司(Times Publishing Company)、奥斯汀纪事报公司(Austin Chronicle Corp.)、另类新闻周刊基金会(Alternative Newsweekly Foundation)以及SwimSwam Partners。.
出版商指责OpenAI和微软未经许可或未支付任何经济补偿,擅自使用他们的作品开发盈利性人工智能产品,并删除了版权数据,包括作者姓名和版权声明。普拉特金认为,这一联盟的出现表明,出版商开始将这些行为视为不仅对版权保护的威胁,而且对新闻业本身的经济也构成威胁。.
“这个联盟的规模应该敲响警钟。” ——马特·普拉特金,普拉特金律师事务所合伙人
如今,这个问题在更多案件中被放大。Richner Communications 的案件已与 OpenAI 的诉讼合并,成为一系列诉讼案中的一起,而其他出版商也在单独提起诉讼。例如, 《西雅图时报》和《新闻日报》起诉 OpenAI 和微软,指控其未经授权使用其网站上的内容,包括用于 ChatGPT、Microsoft Copilot 和 Bing AI 等产品的付费内容。
为什么9月4日如此重要
9月4日,OpenAI公司版权侵权诉讼案中,双方就简易判决请求展开了激烈的辩论。版权所有者声称,OpenAI公司为创建其模型而进行的复制行为不能被归类为合理使用,并且会对现有市场和潜在的未来市场造成负面影响。而OpenAI和微软则表示,根据人工智能与数字政策中心(Center for AI and Digital Policy)的。
如今,同样的合理使用问题也引起了trac各方的意见。负责审理此案的纽约南区联邦地区法院法官西德尼·H·斯坦邀请各方在10月16日前提交法庭之友意见陈述。 美国司法部 已于9月2日发表声明,表示支持在人工智能训练领域对“合理使用”一词进行广泛解释,并警告称强制许可可能会给小型公司带来障碍。
并非所有裁决都与人工智能相悖。
法律形势依然复杂。9月16日,OpenAI和微软 在GitHub Copilot开发者诉讼案中取得部分胜利,上诉法院驳回了其中一项版权管理信息理论,但保留了其他诉讼请求。
美国 版权局 表示,人工智能训练中的合理使用需视具体情况而定,取决于所使用的素材、获取方式、复制原因及其对版权市场的影响。即使裁决有利于人工智能公司进行训练,也未必能解决关于盗版或来源不当素材的争议。
许可费用是多少?
版权所有局倾向于在国会考虑强制许可之前,先让自愿许可市场发展起来,同时承认大规模人工智能训练材料的许可可能会带来巨大的财务和后勤负担。.
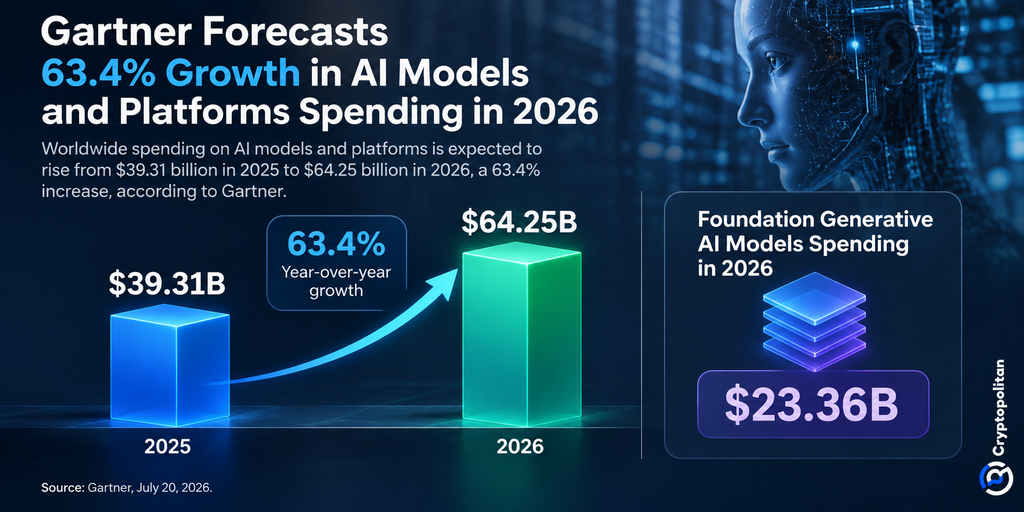
正因如此, Gartner 的预测 才显得尤为重要。全球人工智能模型和平台的支出预计将从 2025 年的 393.1 亿美元攀升至 2026 年的 642.5 亿美元,增幅高达 63.4%。仅基础生成式人工智能模型一项,预计支出就将达到 233.6 亿美元。因此,任何转向付费获取培训资料的举措都将冲击这个快速增长的市场,而数据成本在其中所占的比例可能会大幅增加。
这些成本可能不会对所有人造成同等影响。 经合组织 表示,人工智能市场依然充满活力,但警告称,对数据、计算能力和云基础设施的集中获取可能会增强现有企业的实力。受版权保护的训练数据可能成为另一项成本高昂的投入,而大型开发商更有能力承担这部分成本。
这个问题也正变得日益全球化。在欧洲,欧盟的 通用人工智能法典 为履行《人工智能法》的版权义务提供了一个框架。
挑战在于如何在提高创作者报酬的同时,避免模型开发成本上升。法院如何划定这tron界限,不仅将决定人工智能公司如何获取训练数据,还将决定这些成本究竟会扩大还是缩小能够构建下一代模型的公司范围。.
不要只是阅读加密货币新闻,要理解它。订阅我们的新闻简报, 完全免费。