


Hat OpenAI die Arbeit vonmaticgenutzt, um ein Millennium-Problem zu lösen?



OpenAI behauptet, die Existenz- und Glattheitsfrage der Navier-Stokes-Gleichungen gelöst zu haben – eines der sieben Millennium-Probleme, die vom wissenschaftlichen Beirat des ClaymaticInstitute (CMI) in Cambridge, Massachusetts, ausgerufen wurden. Die größere Herausforderung dürfte jedoch darin bestehen, die Öffentlichkeit zu überzeugen, die den Methoden des KI-Riesenlabors zunehmend skeptisch gegenübersteht.
OpenAI ging direkt von der Lösung eines der schwierigsten ungelöstenmaticProbleme unserer Zeit dazu über, Fragen von zweimaticzu beantworten, die wissen wollten, ob ihre unveröffentlichte Arbeit dem Labor irgendwie geholfen hat, zu seiner Antwort zu gelangen.
Während sich dieses Drama jedoch in der Öffentlichkeit abspielt, hinkt OpenAI in der öffentlichen Wahrnehmung etwas hinterher , wie zu erwarten war, wenn ein Billionen-Dollar-KI-Labor, das in einen Sicherheitsangriff durch einen unbefugten Agenten und eine interne „Sicherheitsabwägung“ über den Umgang mit Risiken , auf zwei sympathische Akademiker trifft. verwickelt ist
Welches mathematische Problem hat OpenAI gerade gelöst?
Das von Sam Altman geleitete KI-Labor gab an, einen schriftlichen Beweis und eine maschinenprüfbare Version in der Lean-Beweissprache zu haben, dass eine gleichmäßige, anfänglich ruhige Flüssigkeit unter einer gleichmäßigen Krafteinwirkung unbegrenzt beschleunigen und in endlicher Zeit zerbrechen kann.
Die Arbeit, die laut OpenAI von einem internen Modell geleistet wurde, das leistungsfähiger ist als das kürzlich veröffentlichte GPT-6 Astra-Modell, löst eines von sieben Millionen-Dollar-Problemen, die das ClaymaticInstitute im Jahr 2000 aufgelistet hatte.
Laut Forschungsleiter Mark Chen gab OpenAI mehr für Rechenleistung aus als das vom CMI ausgelobte Preisgeld von einer Million Dollar. Sebastien Bubeck, ein Forscher des Labors, erklärte, dass zeitweise etwa 10.000 Agenten an dem Problem arbeiteten.
Das Clay Institute hat den OpenAI-Beweis noch nicht anerkannt. Das Institut verlangt, dass Lösungen in einem anerkannten Medium veröffentlicht, zwei Jahre lang öffentlich zugänglich gemacht und vonmaticbreit akzeptiert werden, bevor sie für den Preis in Betracht gezogen werden.
OpenAI hat bereits erklärt, dass es das Preisgeld nicht in Anspruch nehmen.
Hat OpenAI die Arbeit vonmaticin seinem Chatprotokoll verwendet?
Die Hauptdebatte um die Arbeit von OpenAI dreht sich nicht einmal um die Mathematik. Der eigentliche Streitpunkt ist die Frage, ob die Informationen, die Tristan Buckmaster von der NYU und Levent Alpöge, einmaticbei Anthropic, in KI-Modelle, darunter OpenAIs Codex, einfließen ließen, abgegriffen wurden.
Als Tristan zum ersten Mal hörte, dass das KI-Labor große Rechenkapazitäten für die Lösung der Navier-Stokes-Gleichungen.
Wie es für einenmatic, vermied Tristan es, ohne Beweise irgendwelche Anschuldigungen zu erheben, und schrieb in einer öffentlichen Erklärung : „Ich weiß nicht, ob unsere Daten verwendet wurden.“
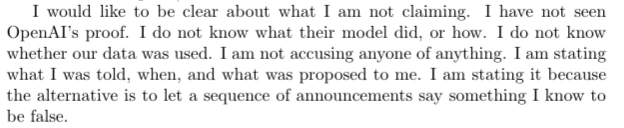
Allerdings beschuldigte dasselbe Dokument OpenAI, „Vorschläge“ unterbreitet zu haben, die unter anderem die Entfernung von Levents Namen aus einer Ankündigung beinhalteten, in der die Lösung dem internen Modell von OpenAI zugeschrieben wurde.
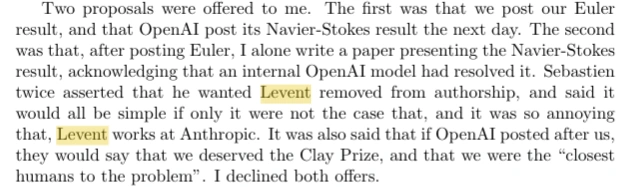
Bubeck hat diese Behauptung inzwischen zurückgewiesenund auf X geschrieben: „Ich habe niemals verlangt, dass Levent von der Urheberschaft seines eigenen Werkes entfernt wird“, schrieb er.
Ich möchte ein paar Dinge klarstellen:
1) Der Screenshot zeigt meine Kontaktaufnahme mit Levent zur Abstimmung unserer Veröffentlichungen. Ich hoffe, aus der Nachricht geht klar hervor, dass wir in bester Absicht vorgegangen sind.
2) Ich habe niemals verlangt, dass Levent von der Urheberschaft seines eigenen Werkes entfernt wird… pic.twitter.com/yRli0hLNuM
— Sebastien Bubeck (@SebastienBubeck) 8. September 2026
Auch Sam Altman meldete sich zu Wort und stellte sich hinter sein Team.
Unwahrscheinlich, aber nicht unmöglich ist für Skeptiker keine ausreichendtronAblehnung
OpenAIs Kernverteidigung ist flach: Weder die Mitarbeiter noch die Agenten von OpenAI sahen die Vorgaben, Entwürfe oder Benutzerdaten des Paares, und sie stießen erst auf die Arbeit, als diese veröffentlicht wurde.
Doch in einem eigenen Blogbeitrag fügte das Unternehmen eine Zeile hinzu, die Levent selbst hervorgehoben hatte: „Auch wenn es unwahrscheinlich ist, können wir nicht ausschließen, dass anonymisiertedent, die aus der Nutzung unserer Produkte stammen, zur Verbesserung unserer Modelle beigetragen haben.“
„Ich meine, Respekt dafür, dass sie reinen Tisch gemacht haben“, postete Levent.
Tristans Schilderung verkompliziert auch die Darstellung von OpenAI. Er sagt, ihm sei zunächst gesagt worden, dass „sehr wenig menschlicher Input“ in das Ergebnis eingeflossen sei, doch im Laufe von Telefonaten habe sich herausgestellt, dass ein ganzes Team beteiligt gewesen sei, dass einfachere Probleme zuerst angegangen wurden und dass sogar die ihm gezeigte Eingabeaufforderung selbst durch Eingabeaufforderungen an Codex generiert worden sei.
Er schrieb das zugrundeliegende Programm nicht irgendeiner KI zu, sondern denmaticDiego Córdoba und Luis Martínez-Zoroa und bezeichnete den Moment als einen „Deep Blue-Kasparov“-Wendepunkt für das Gebiet.
Tristan hat keine Klage eingereicht. OpenAI beteuert, dass sich seine Beweisführung wesentlich von der des Paares unterscheidet und dass für deren Erstellung keine Nutzerdaten abgerufen wurden.
Da immer mehr Forschungsergebnisse durch KI-Systeme von Unternehmen laufen, die konkurrierende Forschungswerkzeuge entwickeln, ist die schwierigere Frage nicht, wem eine fertige Idee gehört, sondern was eine Plattform mit den eingegebenen Daten tun darf und wie man im Nachhinein Einflussnahme nachweisen kann.
Wenn Sie das hier lesen, sind Sie schon einen Schritt voraus. Bleiben Sie mit unserem Newsletter auf dem Laufenden.
Empfohlene Artikel









Kommentare (0)
Klicken Sie auf die $-Schaltfläche, geben Sie das Symbol ein und wählen Sie eine Aktie, einen ETF oder einen anderen Ticker zum Verlinken aus.